Migration eines Data Warehouses: Ein praxisorientierter Leitfaden für IT-Führungskräfte
Migration eines Data Warehouses: Ein praxisorientierter Leitfaden für IT-Führungskräfte Nutzen Sie eine phasenweise Migration mit einer hybriden Strategie: Migrieren Sie produktionskritische Tabellen auf eine neue Plattform, entwerfen Sie Lösungen neu, wenn technische Altlasten die Skalierung behindern, und führen Sie ein Lift-and-Shift nur für selten genutzte oder kurz vor der Stilllegung stehende Assets durch.
Migration eines Data Warehouses: Ein praxisorientierter Leitfaden für IT-Führungskräfte
Führen Sie die Migration phasenweise mit einer hybriden Strategie durch: Migrieren Sie produktionskritische Tabellen auf eine neue Plattform, entwerfen Sie Lösungen neu, wenn technische Altlasten die Skalierung behindern, und führen Sie ein Lift-and-Shift nur für selten genutzte oder kurz vor der Stilllegung stehende Assets durch. Das Wertvollste, was Sie diese Woche tun können, ist, einen Verantwortlichen zu benennen und eine fokussierte Bestandsaufnahme durchzuführen, bei der Sie Ihre wichtigsten Produktionstabellen und die wichtigsten nachgelagerten Nutzer katalogisieren. Wenn Sie diesen Schritt überspringen, treten sofort zwei Risiken zutage: undokumentierte Abhängigkeiten, die nachgelagerte Berichte am Tag der Umstellung zum Ausfall bringen, sowie jahrelang angehäufte technische Altlasten, deren Hosting in der Cloud Sie zu höheren Kosten pro Abfrage bezahlen lässt als zuvor im eigenen Rechenzentrum.
Wenn Sie diese Bestandsaufnahme lieber von einem erfahrenen Team durchführen lassen möchten, Ridiculous Engineeringbietet strukturierte Analyseleistungen an, die darauf ausgelegt sind, Erkenntnisse aus der Bestandsaufnahme in eine priorisierte Migrations-Roadmap zu überführen.
Inhaltsverzeichnis
-
Wie sieht eine Data-Warehouse-Migration in den einzelnen Phasen aus?
-
Wie führen Sie vor Beginn der Migration eine Bestandsaufnahme Ihres Warehouses durch?
-
Welche Design- und Modellierungsentscheidungen sind auf der Zielplattform am wichtigsten?
-
Wie verschieben Sie Daten und konvertieren Pipelines während der Durchführung?
-
Wie validieren Sie Daten und planen eine sichere Umstellung?
-
Was geschieht nach der Umstellung und warum ist das wichtig?
-
Welche Tool-Kategorien sollten Sie für Ihre Migration bewerten?
Wie sieht eine Data-Warehouse-Migration in den einzelnen Phasen aus?
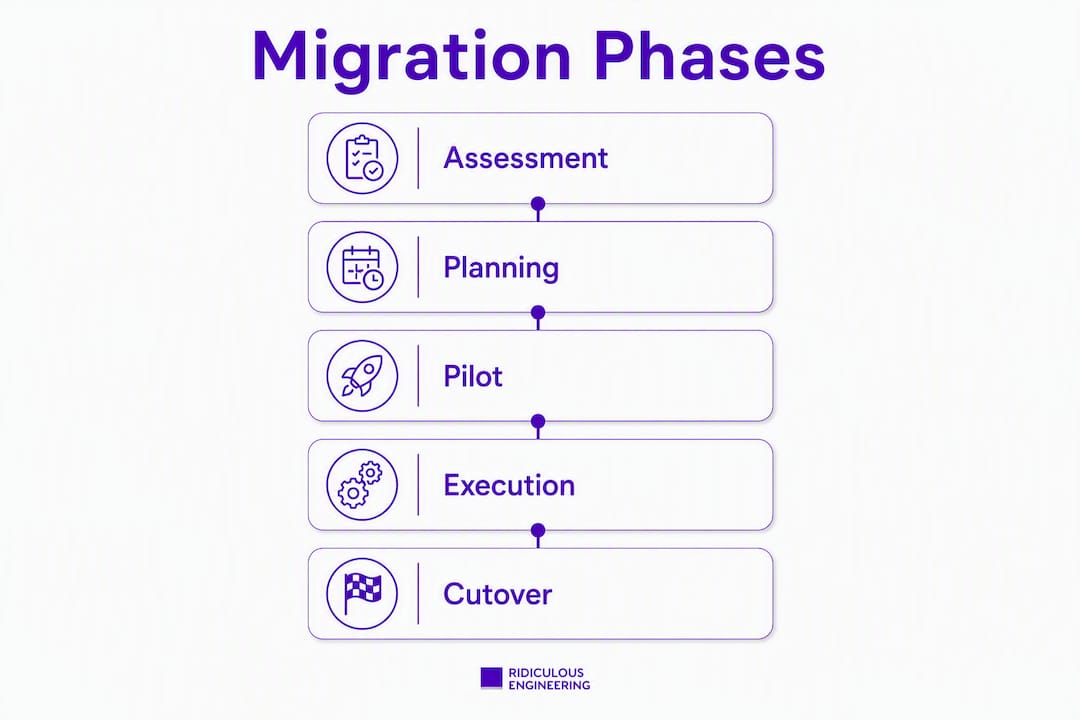
Die meisten erfolgreichen Migrationen verfolgen einen hybriden Ansatz statt einer einzigen Strategie. Dieser hybride Ansatz funktioniert jedoch nur, wenn jede Phase eine klare Eintrittsbedingung und ein definiertes Ergebnis hat. Die folgenden sechs Phasen bilden das maßgebliche Rahmenwerk.
-
Analyse — Ergebnis: Systeminventar, Datenflusskarte, Abhängigkeitsmatrix und Risikoregister. Erfolg bedeutet, dass Sie wissen, was in der Produktion läuft und was nicht.
-
Planung — Ergebnis: Migrations-Roadmap mit priorisierten Arbeitsströmen, Teamzuweisungen und einer Go-/No-Go-Bewertung für jedes Asset. Erfolg bedeutet, dass alle Stakeholder den Umfang freigegeben haben.
-
Design — Ergebnis: Entwürfe für das Zielschema, Namenskonventionen, Sicherheitsmodell und Strategie für die Materialisierung. Erfolg bedeutet, dass die Zielplattform entsprechend ihren eigenen Eigenschaften entworfen und nicht einfach aus dem Altsystem kopiert wurde.
-
Ausführung — Ergebnis: migrierte Daten, konvertierte ETL-/ELT-Pipelines und eine laufende parallele Umgebung. Erfolg bedeutet, dass Quelle und Ziel abgeglichen und synchron sind.
-
Tests und Umstellung — Ergebnis: Validierungsbericht, akzeptierte KPI-Vergleiche und ein unterzeichneter Umstellungsplan mit Auslösern für einen Rollback. Erfolg bedeutet, dass die Fachanwender die Datengleichheit freigegeben haben.
-
Optimierung nach der Migration — Ergebnis: Protokoll zur Abfrageoptimierung, Basis für Kosten-Governance, Dashboards zur Überwachung und Betriebsleitfäden. Erfolg bedeutet, dass die neue Plattform besser und nicht nur anders als das Altsystem arbeitet.
Entscheidungstore zwischen den Phasen:Wechseln Sie von der Bewertung zur Planung erst, wenn das Inventar vollständig ist und das Risikoregister überprüft wurde. Wechseln Sie von der Planung zum Design erst, wenn der Umfang festgelegt ist und die Migrationsstrategie (Lift-and-Shift, Replatforming oder Neugestaltung) für jedes Asset zugewiesen wurde. Wechseln Sie von der Ausführung zum Testen erst, wenn parallele Umgebungen laufen und die erste Abstimmung erfolgreich ist. Wechseln Sie vom Testen zum Cutover erst, wenn die Abnahmekriterien erfüllt sind und ein Rollback-Plan dokumentiert wurde.
Ein fokussierter Pilot, der auf eine einzelne Domäne, eine repräsentative ETL-Pipeline und eine Reporting-Workload begrenzt ist, ist der richtige Weg, um Tools und Vorgehensweise zu validieren, bevor Sie sich auf einen vollständigen Rollout festlegen.
Wie prüfen Sie Ihr Data Warehouse, bevor die Migration beginnt?
Die Bewertung ist die Phase, in die die meisten Teams zu wenig investieren, und sie entscheidet darüber, ob das restliche Projekt erfolgreich ist. Eine unvollständige Erfassung führt direkt dazu, dass ungenutzte Assets migriert werden und die Cloud-Kosten steigen. Betrachten Sie diese Phase als Gelegenheit, Überflüssiges zu entfernen, statt es zu replizieren.
Inventar-Checkliste
Erfassen Sie für jede Tabelle oder jedes Dataset:
-
Schemaname, Tabellenname und Eigentümer
-
Zeilenanzahl und ungefähre Speichergröße
-
Partitionierungs- und Indizierungsstrategie
-
Aktualisierungsintervall und SLA für Datenaktualität
-
Abfragehäufigkeit (aus Abfrageprotokollen ableiten, nicht aus Annahmen)
-
Abfragen mit dem höchsten Compute-Verbrauch
-
ETL-Laufzeit und Fehlerquote
-
Nachgelagerte Berichte, Dashboards und APIs, die von dieser Tabelle abhängen
-
Bewertung der geschäftlichen Kritikalität durch das zuständige Team
Techniken zur Erfassung
-
Automatisierte Katalogisierung: Tools wie Apache Atlas oder cloudnative Katalogdienste können Schemata scannen und die Datenherkunft automatisch sichtbar machen. Beginnen Sie damit, bevor Sie manuelle Arbeiten durchführen.
-
Analyse der Abfrageprotokolle: Exportieren Sie den Abfrageverlauf über mehrere Wochen, um zu ermitteln, welche Tabellen in der Produktion tatsächlich gelesen werden und welche nur in der Dokumentation existieren.
-
Nachverfolgung von Abhängigkeiten: Erfassen Sie Fremdschlüsselbeziehungen, View-Definitionen und Verweise aus gespeicherten Prozeduren, um einen Abhängigkeitsgraphen zu erstellen.
-
Interviews mit Stakeholdern: BI-Verantwortliche, Datenanalysten und Anwendungsbesitzer kennen undokumentierte Verhaltensweisen in der Produktion, die kein Katalogtool sichtbar machen kann.
Zu erfassende Kennzahlen pro Asset
Erfassen Sie Zeilenanzahlen, Abfragehäufigkeiten, Abfragen mit dem höchsten Verbrauch, ETL-Laufzeit, Kosten pro Abfrage und Zeitfenster der Datenaktualität. Diese Kennzahlen fließen direkt in das Bewertungsschema im späteren Bewertungsabschnitt dieses Leitfadens ein.
Profi-Tipp: Automatisieren Sie die erste Inventarabfrage mithilfe der Information-Schema-Views Ihres Data Warehouses (z. B. INFORMATION_SCHEMA.TABLES, INFORMATION_SCHEMA.COLUMNS) und der Tabellen mit dem Abfrageverlauf. Exportieren Sie die Daten in eine Tabellenkalkulation oder ein Katalogtool und ergänzen Sie anschließend manuelle Bewertungen der geschäftlichen Kritikalität aus Stakeholder-Interviews. Dieser hybride Ansatz verkürzt die Inventarisierungszeit im Vergleich zu einer vollständig manuellen Katalogisierung erheblich.
Ergebnisse dieser Phase: ein Systeminventar, eine Datenflusskarte, eine Abhängigkeitsmatrix, ein Risikoregister und eine Machbarkeits-Scorecard. Die Scorecard bildet die Grundlage für Ihre Entscheidungen zwischen Lift-and-Shift, Replatforming und Neugestaltung.
Welche Design- und Modellierungsentscheidungen sind auf der Zielplattform am wichtigsten?
Der häufigste Designfehler bei einer Data-Warehouse-Migration besteht darin, das Legacy-Schema auf die Zielplattform zu kopieren, ohne zu berücksichtigen, wie diese Plattform Compute und Speicher abrechnet. Plattformspezifisches Design bedeutet Partitionierung und Clustering für serverlose Engines wie BigQuery-ähnliche Plattformen sowie die sorgfältige Auswahl von Verteilungsschlüsseln für MPP-basierte Clouds. Legacy-Verteilungsschlüssel lassen sich nur selten gut übertragen.
Modellierungsmuster
-
Medallion-Architektur (Bronze/Silber/Gold): Rohdatenaufnahme in Bronze, bereinigte und vereinheitlichte Daten in Silber, geschäftsbereite Aggregate in Gold. Dieses Muster eignet sich gut für Cloud-Lakehouses und macht die Datenherkunft transparent.
-
Dimensionale gegenüber rohen Schichten: Behalten Sie eine Rohdatenschicht für die Auditierbarkeit bei und erstellen Sie darauf vereinheitlichte Dimensionen. Vermeiden Sie es, diese während der Migration zu einer einzigen Schicht zusammenzufassen.
-
Denormalisierungsentscheidungen:Cloud-Data-Warehouses mit spaltenbasierter Speicherung profitieren häufig von breiteren, denormalisierten Tabellen. Bewerten Sie die Join-Häufigkeit und Abfragemuster, bevor Sie sich entscheiden.
-
Spaltentypen und verschachtelte Felder:Verwenden Sie native Array- und Struct-Typen, wenn die Plattform sie unterstützt, um den Join-Overhead zu reduzieren, jedoch nur, wenn nachgelagerte Verbraucher die Struktur verarbeiten können.
Strategie für die Materialisierung
-
Verwenden Sie Viewsfür leichtgewichtige Transformationen, die selten ausgeführt werden oder bei denen Aktualität entscheidend ist.
-
Verwenden Sie materialisierte Viewsfür Aggregationen, die bei großen Datensätzen wiederholt abgefragt werden.
-
Verwenden Sie aggregierte Tabellen (vorberechnet) für Dashboards mit strengen Latenz-SLAs.
-
Berechnung beim Lesen ist für Abfragen mit geringer Häufigkeit günstiger; für häufige Abfragen sollten Sie vorab berechnen.
Checkliste für Sicherheit und Governance
-
Definieren Sie die rollenbasierte Zugriffskontrolle auf Schema- und Tabellenebene vor der Migration, nicht danach.
-
Klassifizieren Sie Daten nach ihrer Sensibilität (personenbezogene Daten, Gesundheitsdaten, vertraulich, öffentlich) und wenden Sie bei Bedarf eine Maskierung auf Spaltenebene an.
-
Verschlüsseln Sie Daten im Ruhezustand und bei der Übertragung; bestätigen Sie die standardmäßigen Verschlüsselungseinstellungen der Zielplattform.
-
Richten Sie eine Nachverfolgung der Datenherkunft von der Aufnahme über die Transformation bis zur Berichterstellung ein.
-
Dokumentieren Sie die Strategie für die Schemaentwicklung: Ausschließlich additive Änderungen (neue Spalten, neue Tabellen) sind abwärtskompatibel; Umbenennungen von Spalten und Typänderungen sind es nicht.
Namenskonventionen sind wichtiger, als Teams erwarten. Vereinbaren Sie einen Standard (snake_case, Präfix nach Schicht, Suffix nach Materialisierungstyp), bevor die Ausführung beginnt, und setzen Sie ihn in Code-Reviews durch.
Wie verschieben Sie Daten und konvertieren Pipelines während der Ausführung?
Bei der Ausführung treffen Pläne auf die Realität. Ziel ist es, Daten zuverlässig zu verschieben, ETL-/ELT-Logik korrekt zu konvertieren und Quelle und Ziel lange genug synchron zu halten, um die Übereinstimmung vor der Umschaltung zu validieren.
Muster für die Datenverschiebung
-
Vollständiges Laden der Historie:Extrahieren Sie den gesamten Datensatz einmal. Verwenden Sie dies für statische oder selten aktualisierte Tabellen. Einfach, aber es erstellt einen zeitpunktbezogenen Snapshot, der sofort veraltet, wenn die Quelle aktiv ist.
-
Inkrementelle Synchronisierung:Extrahieren Sie nur Datensätze, die seit dem letzten Lauf geändert wurden, anhand einer Watermark-Spalte (z. B.
updated_at). Schneller als vollständige Ladevorgänge, erfordert jedoch einen zuverlässigen Änderungsindikator in der Quelle. -
Change Data Capture (CDC):CDC ermöglicht eine Replikation nahezu in Echtzeit, indem es das Transaktionsprotokoll des Quellsystems liest. Im Vergleich zu ausschließlich massenbasierten Verfahren minimiert es die Zeitfenster für die Umschaltung und ist die richtige Wahl für aktive Transaktionsquellen.
Code-Migration
Automatisierte SQL-Übersetzer bewältigen Dialektunterschiede (z. B. Teradata SQL zu BigQuery SQL, Oracle zu Snowflake) bei standardmäßiger DML schneller und konsistenter als manuelle Neufassungen. Gespeicherte Prozeduren mit komplexen Kontrollabläufen, anbieterspezifischen Funktionen und dynamischem SQL erfordern jedoch meist eine manuelle Überarbeitung. Planen Sie dafür ausdrücklich Zeit ein; an diesen Stellen geraten Projekte häufig in Verzug.
Automatisierung verarbeitet Schemaänderungen und sich wiederholende Übersetzungsaufgaben zuverlässiger als handgeschriebene Skripte, was die Zuverlässigkeit der Umschaltung verbessert. Verwenden Sie ausgereifte Konnektoren und Übersetzer für wiederholbare Aufgaben und reservieren Sie Entwicklungszeit für die Logik, die tatsächlich menschliches Urteilsvermögen erfordert.
Orchestrierung und parallele Ausführung
-
Erstellen Sie idempotente Pipelines: Jeder Lauf sollte unabhängig davon, wie oft er ausgeführt wird, dasselbe Ergebnis liefern. Dadurch werden Wiederholungen sicher.
-
Implementieren Sie für vorübergehende Fehler Wiederholungsmechanismen mit exponentiellem Backoff.
-
Führen Sie Quell- und Ziel-Pipelines während der Ausführung parallel aus, damit der Abgleich kontinuierlich und nicht erst bei der Umschaltung erfolgen kann.
-
Überwachen Sie die Pipeline-Telemetrie (Zeilenanzahl, Latenz, Fehlerraten) ab dem ersten Ausführungstag, nicht nur während des Validierungszeitraums.
Das Verbinden von Legacy-Quellen mit modernen Zielenerfordert eine sorgfältige Planung hinsichtlich der Connector-Kompatibilität, insbesondere wenn sich Quellsysteme lokal und Zielsysteme in der Cloud befinden.
Wie validieren Sie Daten und planen einen sicheren Cutover?
Bei der Validierung stellen Teams fest, dass der Abgleich der Zeilenanzahl zwar notwendig, aber bei Weitem nicht ausreichend ist. Zeilenanzahlen erkennen nur die offensichtlichsten Probleme; parallele Läufe und die Validierung durch Fachanwender decken Logik- und semantische Fehler auf.
Validierungsschritte
-
Strukturelle Prüfungen: Bestätigen Sie, dass alle Tabellen, Spalten, Datentypen und Einschränkungen im Ziel vorhanden sind.
-
Abgleich der Zeilenanzahl: Gleichen Sie die Zeilenanzahl je Tabelle zwischen Quelle und Ziel ab.
-
Prüf- und Hashwertvergleiche: Berechnen Sie Prüfsummen für wichtige Spalten, um unbemerkte Datenbeschädigungen zu erkennen.
-
Aggregatvergleiche: Vergleichen Sie SUM, COUNT, AVG, MIN und MAX für wichtige Kennzahlen über übereinstimmende Zeiträume hinweg.
-
KPI-Abgleich: Führen Sie dieselben Geschäftsberichte auf beiden Systemen aus und vergleichen Sie die Ergebnisse.
-
Überprüfung von Beispieldatensätzen: Prüfen Sie einzelne Datensätze stichprobenartig in mehreren Tabellen, insbesondere Tabellen mit komplexen Transformationen.
-
Benchmarks der Abfrageleistung: Führen Sie die 20 wichtigsten Produktionsabfragen auf dem Ziel aus und vergleichen Sie die Ausführungszeiten mit dem Ausgangswert der Quelle.
Abnahmekriterien
Legen Sie diese fest, bevor die Ausführung beginnt, nicht während des Validierungszeitraums:
-
Schwellenwert für Datenparität (z. B. Aggregatwerte innerhalb von 0,01 % der Quelle)
-
SLA für die Abfrageleistung (z. B. P95-Abfragezeit innerhalb von 20 % des Ausgangswerts der Quelle)
-
Keine kritischen KPI-Abweichungen
-
Freigabe durch Fachanwender von mindestens einem Verantwortlichen je Domäne
Cutover-Optionen
| Strategie | Beschreibung | Komplexität des Rollbacks | Typischer Anwendungsfall |
|---|---|---|---|
| Paralleler Betrieb | Beide Systeme sind aktiv; der Datenverkehr wird schrittweise verlagert | Niedrig — Datenverkehr zur Quelle zurückleiten | Die meisten Migrationen; empfohlene Standardoption |
| Blue/Green | Vollständiger Cutover zu einem geplanten Zeitpunkt; die Quelle bleibt betriebsbereit | Mittel — DNS/Verbindungen zurückschalten | Gut getestete Umgebungen mit geringerem Risiko |
| Nach Domäne phasenweise | Führen Sie jeweils eine Geschäftsdomain nach der anderen um | Gering pro Domäne | Großes Enterprise-Data-Warehouse mit unabhängigen Domänen |
| Big Bang | Einmaliges Cutover-Ereignis; die Quelle wird sofort außer Betrieb genommen | Hoch – kein Fallback | Kleine Datensätze; selten empfohlen |
Reservieren Sie ein mehrtägiges Zeitfenster für den abschließenden Abgleich und Plausibilitätsprüfungen im Parallelbetrieb, bevor Sie das Legacy-System außer Betrieb nehmen. Teams unterschätzen dieses Zeitfenster durchweg, und die Kosten für eine Verlängerung sind weitaus geringer als die Kosten für ein Zurücksetzen einer verfrühten Stilllegung.
Kommunikationsplan für das Cutover:Weisen Sie jedem Schritt eine namentlich benannte verantwortliche Person zu, dokumentieren Sie Auslöser für ein Rollback (z. B. KPI-Abweichung über dem Schwellenwert, Pipeline-Fehlerrate über X %) und verteilen Sie den Plan mindestens 48 Stunden vor Beginn des Cutover-Zeitfensters an alle Beteiligten.
Was passiert nach dem Cutover, und warum ist das wichtig?
Die Optimierung nach der Migration ist eine geplante Phase, kein nachträglicher Gedanke. Ein migriertes Data Warehouse, das nicht für seine neue Umgebung optimiert wurde, ist häufig langsamer und teurer als das Legacy-System, das es ersetzt hat – ein schwer zu vermittelndes Ergebnis gegenüber der Geschäftsleitung.
Aufgaben für Optimierung und Wartung
-
Führen Sie eine Abfrageprofilierung für produktive Abfragen mit großer Wirkung durch und identifizieren Sie vollständige Tabellenscans, fehlende Clustering-Schlüssel und ineffiziente Join-Muster.
-
Optimieren Sie Partitionierung und Clustering auf Grundlage der tatsächlichen Abfragemuster nach der Migration, nicht aufgrund von Annahmen vor der Migration.
-
Führen Sie Vacuum- und Komprimierungsjobs für Tabellen mit hohen Aktualisierungs- oder Löschraten aus.
-
Bereinigen Sie migrierte Objekte, die bei der Bewertung als nachrangig eingestuft, aber dennoch übernommen wurden.
Kosten-Governance
Ohne Neugestaltung erhöhen Legacy-Abfragemuster und unnötige Joins die Rechenkosten in Cloud-Data-Warehouses, in denen die Rechenleistung pro Abfrage abgerechnet wird. Wichtige Kontrollen:
-
Legen Sie Richtlinien für den Speicherlebenszyklus fest, um selten benötigte Daten automatisch in günstigere Speicherklassen zu verschieben.
-
Implementieren Sie das Caching von Abfrageergebnissen, sofern die Plattform dies unterstützt.
-
Überwachen Sie Egress-Kosten, wenn sich Ihre Analytics-Nutzer in einer anderen Cloud-Region oder bei einem anderen Anbieter befinden.
-
Legen Sie Budgetwarnungen bei 80 % und 100 % des monatlichen Rechenbudgets fest.
Observability
-
Statten Sie Pipelines von Anfang an mit Metriken für Zeilenanzahl, Latenz und Fehlerrate aus.
-
Definieren Sie SLIs und SLOs für die Datenaktualität (z. B. „Die Silver-Schicht wird innerhalb von 30 Minuten nach dem Commit der Quelle aktualisiert“) und für die Abfragelatenz.
-
Richten Sie eine Anomalieerkennung für wichtige Metriken ein, damit stille Fehler sichtbar werden, bevor Geschäftsanwender sie bemerken.
Für Teams, die in Cloud-native-Architekturenskalieren, ist die Optimierung nach der Migration außerdem der richtige Zeitpunkt, um zu prüfen, ob das aktuelle Datenmodell die AI-/ML-Workloads unterstützt, die das Unternehmen als Nächstes ausführen möchte.
Welche Tool-Kategorien sollten Sie für Ihre Migration bewerten?
Die Auswahl von Tools, bevor Sie die spezifischen Anforderungen Ihrer Migration verstehen, gehört zu den kostspieligeren Fehlern, die ein Team machen kann. Bewerten Sie nach Leistungsumfang und Eignung, nicht nach Markenbekanntheit.
Zu bewertende Tool-Kategorien
-
Konnektoren und CDC-Plattformen: Achten Sie auf native Unterstützung für Ihr Quellsystem, den Umgang mit Schemaänderungen und idempotente Aufnahme. Stellen Sie sicher, dass der Konnektor den erforderlichen Replikationsmodus unterstützt (vollständig, inkrementell, CDC).
-
ETL-/ELT- und Transformations-Frameworks: Bewerten Sie den Umfang der automatisierten SQL-Übersetzung für Ihren Quelldialekt, die Unterstützung modularer Transformationen nach dbt-Art und die Fähigkeit zur Migration gespeicherter Prozeduren.
-
Orchestrierungsplattformen:Bewerten Sie die Wiederholungssemantik, das Abhängigkeitsmanagement, die Alarmierung und die Integration in Ihre bestehenden CI/CD-Tools.
-
Tools für Katalogisierung und Datenherkunft:Vergewissern Sie sich, dass sie Ihre Quell- und Zielschemata automatisch scannen und die Datenherkunft auf Spaltenebene sichtbar machen können.
-
Tools für Tests und Validierung:Achten Sie auf integrierte Aggregatvergleiche, den Abgleich von Zeilenanzahlen und die Möglichkeit, benutzerdefinierte Abnahmekriterien zu definieren.
Funktionscheckliste für jedes zu bewertende Tool
-
Erkennung und automatisierte Behandlung von Schemaänderungen
-
Automatische SQL-Übersetzung mit Abdeckungsberichten
-
Idempotente Datenaufnahme (sichere Wiederholungen)
-
Unterstützung für Rollback oder Zurücksetzen
-
Überwachung und Alarmierung ab Werk
-
Cloud-native Integration in Ihre Zielplattform
Leitfaden für Pilotprojekte
Beschränken Sie Ihr Pilotprojekt auf einen Geschäftsbereich, eine repräsentative ETL-Pipeline und eine Reporting-Workload. Legen Sie die Abbruchkriterien vor Beginn des Pilotprojekts fest: Mindestdurchsatz, maximale Fehlerquote und erfolgreiche Abstimmung der KPIs. Ein Pilotprojekt ohne Abbruchkriterien ist lediglich ein Proof of Concept, der nie endet.
Intelligente Praktiken für das Kostenmanagement während der Pilotphase, einschließlich der Überwachung des Speicher- und Rechenverbrauchs ab dem ersten Tag, verhindern, dass sich Kostenüberraschungen bis zur vollständigen Migration verstärken.
Welche Fehler machen Teams am häufigsten?
Die meisten Migrationsfehler sind vorhersehbar. Die Muster wiederholen sich in Projekten jeder Größe.
Checkliste zur Prävention
-
Frieren Sie den Umfang nach der Planungsphase ein. Änderungen am Migrationsumfang während der Durchführung sind die größte Einzelursache für Zeitplanüberschreitungen.
-
Prüfen Sie alle nachgelagerten Abhängigkeiten, bevor die Durchführung beginnt, nicht erst während des Validierungsfensters.
-
Planen Sie parallele Läufe für jeden Produktionsbereich ein, nicht nur für diejenigen, bei denen Sie am zuversichtlichsten sind.
-
Planen Sie nach der Umschaltung ein Validierungsfenster von mindestens 48 Stunden ein, bevor Sie das Altsystem außer Betrieb nehmen.
-
Weisen Sie jeder Tabelle im Inventar eine namentlich benannte verantwortliche Person zu. Assets ohne Verantwortliche werden zu Blockern.
-
Dokumentieren Sie die Auslöser für ein Rollback und testen Sie das Rollback-Verfahren, bevor das Umschaltungsfenster beginnt.
Häufige Fallstricke und Gegenmaßnahmen
-
Technische Schulden migrieren: Teams replizieren Legacy-Schemata, ohne zu prüfen, ob die zugrunde liegenden Modelle weiterhin den Geschäftsanforderungen entsprechen. Gegenmaßnahme: Verwenden Sie das Bewertungsraster der Analyse, um Assets mit hohen technischen Schulden für eine Neugestaltung statt für eine unveränderte Migration zu kennzeichnen.
-
Zeitaufwand für die Validierung der Umschaltung unterschätzen: Die Mindestdauer von 48 Stunden ist eine Untergrenze, kein Ziel. Komplexe Umgebungen mit vielen nachgelagerten Konsumenten benötigen mehr Zeit. Gegenmaßnahme: Fügen Sie bereits während der Planung einen Validierungspuffer in den Projektplan ein, nicht erst während der Durchführung.
-
Nachgelagerte Abhängigkeiten übersehen: Eine Tabelle, die in Abfrageprotokollen ungenutzt erscheint, kann von einem monatlichen Batchjob gelesen werden, der zuletzt vor sechs Wochen ausgeführt wurde. Gegenmaßnahme: Erweitern Sie die Analyse der Abfrageprotokolle auf mindestens 90 Tage und führen Sie Gespräche mit den Stakeholdern.
-
Kostensteuerung ignorieren: Teams konzentrieren sich auf Datenparität und ignorieren die Rechenkosten, bis die erste Cloud-Rechnung eintrifft. Gegenmaßnahme: Richten Sie Budgetwarnungen ein und überprüfen Sie die Kosten-Dashboards ab dem ersten Durchführungstag wöchentlich.
-
Change Management überspringen: Endbenutzer, die nicht über Zeitpläne für die Umschaltung und Schulungspläne informiert werden, werden das neue System umgehen oder Datenqualitätsprobleme eskalieren, die tatsächlich auf mangelnde Vertrautheit zurückzuführen sind. Gegenmaßnahme: Nehmen Sie einen Kommunikationsplan für Stakeholder ab dem ersten Tag in den Projektplan auf.
Wie lange dauert eine Migration, und was kostet sie?
Zeitplan und Budget variieren stärker, als die meisten Leitfäden zugeben. Die ehrliche Antwort hängt vom Datenvolumen, der Komplexität der Transformationen, den nachgelagerten Abhängigkeiten und davon ab, wie viel technische Altlasten Sie beheben möchten, statt sie weiterzutragen.
Beispielzeitpläne
-
Kleine Migration (einzelner Bereich, begrenzte Pipelines): Kleine Migrationen können in 4–6 Wochen abgeschlossen werden. Typisch ist dies für eine einzelne Geschäftseinheit, die einen gut dokumentierten Datensatz mit wenigen nachgelagerten Nutzern migriert.
-
Mittlere Migration (mehrere Bereiche, moderate Komplexität): Projekte mittlerer Komplexität laufen typischerweise 12–24 Wochen. Typisch ist dies für ein mittelgroßes Unternehmen, das mehrere Quellsysteme in einem Cloud-Data-Warehouse konsolidiert.
-
Modernisierung eines Enterprise-EDW: Modernisierungen im Enterprise-Umfeld können je nach Datenvolumen, Integrationskomplexität und nachgelagerten Abhängigkeiten 8–50 Wochen dauern. Planen Sie in komplexen Umgebungen einen Puffer ein.
Zu besetzende Teamrollen
-
Projektverantwortliche:r: verantwortlich für Umfang, Zeitplan und die Kommunikation mit Stakeholdern
-
Leitung Data Engineering: verantwortlich für die Konvertierung der Pipelines, die CDC-Implementierung und die Durchführung
-
Leitung Plattform/Infrastruktur: verantwortlich für die Konfiguration der Zielplattform, Sicherheit und Kostensteuerung
-
Leitung QA/Validierung: verantwortlich für Abnahmekriterien, Validierungsskripte und die Freigabe des Cutovers
-
BI-/Product-Owner: vertritt nachgelagerte Nutzer und gibt die KPI-Abstimmung frei
-
Change-Manager: verantwortlich für Schulungen, Dokumentation und die Kommunikation mit Endnutzer:innen
Kostentreiber
-
Datenvolumen und historische Tiefe (mehr Daten = mehr Rechenleistung für initiales Laden und Validierung)
-
Komplexität der Transformationen (gespeicherte Prozeduren und anbieterspezifische Funktionen erfordern manuellen Aufwand)
-
Erforderliche Ausfallzeittoleranz (geringere Toleranz = höhere Infrastrukturkosten für den Parallelbetrieb)
-
Tool-Lizenzen (Konnektoren, Orchestrierungsplattformen, Katalogisierungstools)
-
Engineering-Aufwand (interne Teamstunden zuzüglich externer Beratung, falls erforderlich)
-
Support nach der Migration (Optimierung, Pflege von Runbooks und laufende Kostensteuerung)
Planen Sie bei komplexen Migrationen einen Puffer von 30–50 % ein. Der Puffer ist kein Pessimismus, sondern die Kosten der Unwägbarkeiten, die in der Bewertungsphase noch nicht aufgedeckt wurden. Teams, die den Puffer auslassen, sind diejenigen, die in Woche acht dringende Änderungen des Umfangs anfordern.
Die Ausrichtung der Migrationsprioritäten an den Geschäftszielen statt an rein technischen Kriterien unterscheidet Migrationen, die messbaren ROI liefern, von solchen, die das Problem lediglich in eine teurere Umgebung verlagern.
Bewertungsrubrik für die Analyse von Ridiculous Engineering
Diese Rubrik wandelt Erkenntnisse aus der Bestandsaufnahme in eine priorisierte Entscheidungsliste um. Bewerten Sie jedes Asset anhand von fünf Dimensionen, addieren Sie die Punkte und wenden Sie die folgenden Aktionsregeln an.
Bewertungsdimensionen (jeweils auf einer Skala von 1–5)
| Dimension | 1 (Niedrig) | 3 (Mittel) | 5 (Hoch) |
|---|---|---|---|
| Geschäftskritikalität | Selten verwendet, keine SLA | Wöchentlich verwendet, informelle SLA | Tägliche Nutzung, formelle SLA, umsatzgebunden |
| Abfragehäufigkeit | < 1 Abfrage/Tag | 1–50 Abfragen/Tag | > 50 Abfragen/Tag |
| Technische Schulden | Sauber, dokumentiert | Teilweise undokumentierte Logik | Viele gespeicherte Prozeduren, keine Dokumentation |
| Datenqualität | Bekannte Probleme, geringes Vertrauen | Gelegentliche Anomalien | Hohes Vertrauen, regelmäßig validiert |
| Nachgelagerte Abhängigkeiten | 0–1 Konsumenten | 2–5 Konsumenten | 6+ Konsumenten |
Beispielinventar mit Prioritätsbewertungen
| Asset | Kritikalität | Abfragehäufigkeit | Technische Schulden | Datenqualität | Abhängigkeiten | Gesamt |
|---|---|---|---|---|---|---|
orders_fact |
5 | 5 | 3 | 4 | 5 | — |
legacy_staging_v2 |
1 | 1 | 5 | 2 | 1 | — |
customer_dim |
4 | 4 | 2 | 5 | 4 | — |
archive_raw |
1 | 1 | 1 | 3 | 1 | 7 |
marketing_agg |
3 | 3 | 4 | 3 | 3 | — |
Aktionsregeln
-
Punktzahl 18–25: Neuplattformierung mit Neugestaltung. Diese Assets sind geschäftskritisch und weisen eine so hohe technische Verschuldung oder nachgelagerte Komplexität auf, dass eine reine Lift-and-Shift-Migration zu anhaltenden Problemen führen würde.
-
Punktzahl 12–17: Neuplattformierung mit gezielter Optimierung. Verschieben Sie die Assets auf die Zielplattform und beheben Sie die problematischsten Elemente, eine vollständige Neugestaltung ist jedoch nicht erforderlich.
-
Punktzahl 7–11: Lift-and-Shift-Migration oder Archivierung. Aufgrund der geringen Kritikalität und der niedrigen Abfragehäufigkeit eignen sich diese Assets für eine direkte Migration oder Stilllegung.
-
Punktzahl unter 7: Archivieren oder stilllegen. Stimmen Sie dies mit dem zuständigen Team ab und entfernen Sie die Assets anschließend aus dem Umfang.
Checkliste, den Bewertungsergebnissen zugeordnet
-
[ ] Jedem Asset im Inventar eine Punktzahl zuweisen, bevor die Planung beginnt
-
[ ] Alle Assets mit einer Punktzahl von 18 oder höher für eine Überprüfung der Neugestaltung mit der Leitung der Datenentwicklung kennzeichnen
-
[ ] Kandidaten für die Stilllegung vor dem Entfernen aus dem Umfang mit den Fachverantwortlichen bestätigen
-
[ ] Die Begründung für die Bewertung jedes Assets im Risikoregister dokumentieren
-
[ ] Die Bewertungen nach Gesprächen mit Stakeholdern überprüfen, da sich die geschäftliche Kritikalität häufig ändert
Profi-Tipp: Füllen Sie die Anfangsbewertungen für Abfragehäufigkeit und technische Verschuldung automatisch aus, indem Sie das Informationsschema Ihres Data Warehouse und die Tabellen mit der Abfragehistorie abfragen. Verwenden Sie ein einfaches SQL-Skript, um die Abfragen pro Tabelle innerhalb der letzten 90 Tage zu zählen und Tabellen mit Abhängigkeiten von gespeicherten Prozeduren zu kennzeichnen. Die manuelle Bewertung der geschäftlichen Kritikalität und Datenqualität dauert pro Stakeholder-Interview eine Stunde; automatisieren Sie alles andere.
Wichtigste Erkenntnisse
Eine phasenbasierte Data-Warehouse-Migration mit einer hybriden Strategie (Replatforming für kritische Assets, Neugestaltung, wenn technische Altlasten die Skalierung behindern, Lift-and-Shift für Assets mit niedriger Priorität) übertrifft Ansätze mit nur einer Strategie konsequent hinsichtlich Kosten, Zuverlässigkeit und Zeit bis zur Wertschöpfung.
| Punkt | Details |
|---|---|
| Die Bewertung bestimmt jede Entscheidung | Eine unvollständige Bestandsaufnahme führt dazu, dass ungenutzte Assets migriert werden und die Cloud-Kosten steigen. Katalogisieren Sie die Produktionstabellen, bevor die Planung beginnt. |
| Eine hybride Strategie ist besser als ein einzelner Modus | Weisen Sie jedem Asset anhand eines bewerteten Kriterienrasters Lift-and-Shift, Replatforming oder Neugestaltung zu, statt eine pauschale Regel anzuwenden. |
| Die Validierung dauert länger als geplant | Planen Sie nach der Umstellung ein ausreichend langes Zeitfenster für den Parallelbetrieb ein, bevor Sie das Legacy-System außer Betrieb nehmen. |
| Die Zeit nach der Migration ist eine geplante Phase | Planen Sie von Anfang an Budget für Abfrageoptimierung, Kosten-Governance und Observability ein. Dies sind keine optionalen Aufräumarbeiten. |
| Ridiculous Engineering als Ihr Partner | Ridiculous Engineering bietet Assessments, Replatforming-Projekte und Optimierung nach der Migration für Teams, die erfahrene externe Unterstützung benötigen. |
Wie Ridiculous Engineering Ihre Migration unterstützt
Datenbankmigrationen sind eine der folgenreicheren Infrastrukturentscheidungen, die ein Unternehmen trifft, und der Unterschied zwischen einer gut durchgeführten Migration und einer unzureichend abgegrenzten zeigt sich unmittelbar in den Cloud-Kosten, der Produktivität von Analysten und der Zuverlässigkeit jedes nachgelagerten Berichts. Ridiculous Engineerings individuellen Software- und Data-Engineering-Services sind genau für diese Art von anspruchsvollem, komplexem Projekt ausgelegt.
Das Team von Ridiculous Engineering führt strukturierte Assessments durch, die das in diesem Leitfaden beschriebene Inventar, die Abhängigkeitsmatrix und das Kriterienraster erstellen. So beginnen Sie die Umsetzung mit einer klaren, priorisierten Roadmap statt mit einer Liste von Annahmen. Anschließend übernimmt das Team Replatforming- und Refactoring-Projekte, die Implementierung von CDC und Orchestrierung sowie die Optimierung und Kosten-Governance nach der Migration. Für Organisationen, die nach der Umstellung laufende Unterstützung benötigen, bietet Ridiculous Engineering Engineering auf Retainer-Basis und anteilsmäßige technische Führung.
Wenn Sie am Anfang einer Migration stehen und vor der Festlegung eines vollständigen Projektplans ein klares Bild von Umfang, Risiken und Zeitplan benötigen, ist ein fokussiertes Discovery-Engagement der richtige nächste Schritt. Ridiculous Engineering kontaktieren , um ein auf Ihre Umgebung zugeschnittenes Assessment zu besprechen.
Nützliche Quellen und weiterführende Literatur
Die folgenden Quellen wurden für diesen Leitfaden herangezogen und sollten für vertiefende technische Details direkt durchgesehen werden:
-
Leitfaden und Best Practices für Data-Warehouse-Migrationen (ER/Studio) — Behandelt hybride Migrationsstrategien, plattformspezifische Designabwägungen und Validierungsansätze. Nützlich für die Bewertungs- und Designphasen.
-
Datenmodellierung bei der Migration in die Cloud einsetzen (ER/Studio) — Erklärt, warum Assessments undokumentierte Produktionsverhalten aufdecken und wie Datenmodellierung als Migrationswerkzeug statt nur als Dokumentationsaufgabe eingesetzt werden kann.
-
Tools und Automatisierung für Datenbankmigrationen (Fivetran) — Praktische Hinweise zu Automatisierungsmöglichkeiten, dem Umgang mit Schemaänderungen und den Bereichen, in denen manuelle Arbeit unvermeidbar ist.
-
Best Practices und Zeitpläne für Datenmigrationen (Fivetran) — Behandelt Validierungsfenster für die Umstellung, den Umfang von Pilotprojekten und die Zeitplanung. Die Empfehlung eines Validierungsfensters von mindestens 48 Stunden stammt aus dieser Quelle.
-
Data-Warehouse-Migration: Vollständige Strategie und Projektplan (Exasol) — Detaillierte Hinweise zur Projektplanung mit Zeitspannen für kleine bis hin zu unternehmensweiten Migrationen.
-
Ihr Leitfaden zur Data-Warehouse-Migration (Atlan) — Behandelt CDC-Muster ausführlich und zeigt, wie sie Umstellungsfenster für aktive Transaktionsquellen verkürzen.
Häufig gestellte Fragen
Was ist eine Data-Warehouse-Migration?
Eine Data-Warehouse-Migration ist der Prozess, Daten, Schemata, Pipelines und Reporting-Workloads aus einem Legacy- oder lokalen Warehouse auf eine neue Plattform zu übertragen, typischerweise auf ein Cloud-Data-Warehouse. Dazu gehören Bewertung, Design, Datenübertragung, ETL-Konvertierung, Validierung und Optimierung nach der Migration.
Welche vier Arten der Datenmigration gibt es?
Die vier gängigen Arten sind Speichermigration (Verschieben von Daten zwischen Speichersystemen), Datenbankmigration (Verschieben zwischen Datenbank-Engines), Anwendungsmigration (Verschieben von Daten im Rahmen einer Anwendungsänderung) und Geschäftsprozessmigration (Umstrukturierung von Daten zur Unterstützung neuer Workflows). Eine Warehouse-Migration kombiniert typischerweise Datenbank- und Anwendungsmigration.
Ist ETL dasselbe wie Datenmigration?
ETL (Extrahieren, Transformieren, Laden) ist eine Technik, die im Rahmen einer Datenmigration eingesetzt wird, aber kein Synonym dafür. Die Migration ist das übergeordnete Projekt; ETL oder ELT ist der Mechanismus zum Verschieben und Transformieren von Daten als Teil dieses Projekts.
Welche Toolkategorien eignen sich am besten für die Datenmigration?
Kein einzelnes Tool erfüllt alle Anforderungen. Die meisten Teams verwenden eine Kombination aus einer CDC- oder Konnektorplattform für die Datenübertragung, einem Transformations-Framework (z. B. dbt) für die SQL-Konvertierung, einer Orchestrierungsplattform für die Pipelineverwaltung und einem Katalogisierungstool für die Datenherkunft. Bewerten Sie jede Kategorie anhand Ihrer spezifischen Quell- und Zielsysteme, bevor Sie eine Auswahl treffen.
Wie lange dauert eine Data-Warehouse-Migration typischerweise?
Kleine Migrationen können in 4–6 Wochen abgeschlossen werden; Projekte mittlerer Komplexität dauern typischerweise 12–24 Wochen; Modernisierungen von Enterprise-Data-Warehouses können je nach Datenvolumen, Integrationskomplexität und nachgelagerten Abhängigkeiten zwischen 8 und 50 Wochen dauern.