Datenqualitätsmanagement: Ein praktischer Leitfaden für 2026
Datenqualitätsmanagement: Ein praktischer Leitfaden für 2026 Datenqualitätsmanagement (DQM) ist die Gesamtheit von Praktiken, Regeln und operativen Kontrollen, die Ihre Daten genau, vollständig, konsistent und für Analytik und KI geeignet halten.
Datenqualitätsmanagement: Ein praktischer Leitfaden für 2026
Datenqualitätsmanagement (DQM) ist die Gesamtheit von Praktiken, Regeln und operativen Kontrollen, die Ihre Daten genau, vollständig, konsistent und für Analytik und KI geeignet halten. Es ist kein einmaliges Bereinigungsprojekt. Es ist ein fortlaufendes operatives Programm, und Organisationen, die es als etwas Geringeres behandeln, neigen dazu, die Lücke zu entdecken, wenn ein Modell versagt oder ein Executive-Dashboard sich in einer Vorstandssitzung widerspricht.
Das Nützlichste, was Sie kurzfristig tun können, ist, Ihre kritischsten Datensätze zu profilieren und mehrere automatisierte Regeln zu implementieren, die Format, Vollständigkeit und Eindeutigkeit abdecken. Dieser enge Umfang ist in etwa einem Monat erreichbar und generiert die Beweise, die Sie benötigen, um ein breiteres Programm zu finanzieren.
Was Sie jetzt tun sollten:
-
Identifizieren Sie die Datensätze, von denen Ihre Analytik- und KI-Pipelines am stärksten abhängen (beginnen Sie mit Kunden-, Produkt- oder Transaktionsdaten).
-
Führen Sie einen Profilierungslauf durch, um Basislinien für Vollständigkeit und Duplikatraten zu etablieren.
-
Implementieren Sie drei automatisierte Regeln: eine Format-/Regex-Prüfung, eine Null-/Leer-Prüfung und eine Eindeutigkeitsprüfung auf Primärschlüssel.
-
Weisen Sie einen benannten Dateneigentümer für jeden Datensatz zu, bevor Sie eine einzige Regel schreiben.
Profi-Tipp: Beginnen Sie mit dem Datensatz, der Ihren am häufigsten genutzten Bericht oder Ihr Modell mit höchsten Einsätzen speist. Die Behebung der Qualität dort erzeugt schnell sichtbare geschäftliche Auswirkungen, genau das, was Sie benötigen, um Budget für den Rest des Programms zu sichern.
Wichtige Erkenntnisse
Effektives Datenqualitätsmanagement ist ein operatives Programm, kein Projekt. Es erfordert benannte Eigentümerschaft, automatisierte Regeln und KPIs, die an Geschäftsergebnisse gebunden sind, um Ergebnisse über Zeit aufrechtzuerhalten.
| Punkt | Details |
|---|---|
| Beginnen Sie mit Profilierung | Profilieren Sie zuerst Ihre Top-fünf-Datensätze, um Vollständigkeits-, Eindeutigkeits- und Gültigkeitsbasislinien zu etablieren, bevor Sie Regeln schreiben. |
| Automatisieren Sie sofort drei Regeln | Implementieren Sie Format-, Null-/Leer- und Eindeutigkeitsprüfungen in Ihrer bestehenden Pipeline innerhalb von 30 Tagen für schnelle, sichtbare Auswirkungen. |
| Weisen Sie Eigentümerschaft vor Regeln zu | Jeder Datensatz benötigt einen benannten Dateneigentümer; eine Regel ohne Eigentümer ist ein Alarm ohne jemanden, der darauf antwortet. |
| Binden Sie Metriken an Geschäftsergebnisse | Verfolgen Sie die Adoption zertifizierter Datensätze, MTTD und MTTR zusammen mit Vollständigkeitswerten, um Executive-Unterstützung aufrechtzuerhalten. |
| Ridiculous Engineering | Ridiculous Engineering liefert abgegrenzte DQM-Piloten in 30–90 Tagen, von Profilierung und Regeldesign bis zur Übergabe zertifizierter Datensätze. |
Inhaltsverzeichnis
-
Standards und Frameworks, die es wert sind, übernommen zu werden
-
Ridiculous Engineering baut DQM-Programme, die tatsächlich in Produktion laufen
Was Data-Quality-Management tatsächlich abdeckt
DQM erstreckt sich über den gesamten Datenlebenszyklus: vom Moment, in dem Daten in Ihre Systeme gelangen, über Transformation und Anreicherung, bis hin zu Masterdaten- und Analyseschichten und schließlich zur Archivierung oder Löschung. Es kombiniert Profiling (Messung dessen, was Sie haben), Regeln (Definition, wie „gut“ aussieht), Sanierung (Behebung von Fehlern) und Überwachung (Erkennung von Drift im Laufe der Zeit). Das Ziel ist Zweckmäßigkeit, nicht Perfektion im Abstrakten.
Wo Teams oft verwirrt sind, ist die Überschneidung mit angrenzenden Disziplinen. Die folgende Tabelle verdeutlicht die Unterschiede.
| Disziplin | Primärer Fokus | Wichtigste Ergebnisse | Typischer Verantwortlicher |
|---|---|---|---|
| Data-Quality-Management | Genauigkeit, Vollständigkeit, Konsistenz und Zweckmäßigkeit von Datenwerten | Regeln, Profile, Sanierungsworkflows, zertifizierte Datensätze | Datenverantwortliche, Dateningenieure |
| Data-Governance | Richtlinien, Eigentum, Verantwortlichkeit und Compliance über Datenbestände hinweg | Richtlinien, Rollen, Datenkatalog, Herkunftsdokumentation | Chief Data Officer, Governance-Rat |
| Masterdatenmanagement | Einzelner maßgeblicher Datensatz für Kerneinheiten (Kunde, Produkt, Standort) | Golden Records, Entitätsauflösung, MDM-Hub | MDM-Plattformteam, Dateneigentümer |
| Ad-hoc-Datenbereinigung | Einmalige Korrektur eines bestimmten Datensatzes | Bereinigte Datei oder Tabelle | Analyst oder Ingenieur auf Anfrage |
DQM ist die operative Ebene, die Governance-Richtlinien real macht. Governance sagt Ihnen, was die Regeln sein sollten; DQM ist die Maschinerie, die sie durchsetzt, Compliance misst und Ausnahmen an die richtigen Personen weiterleitet. Masterdatenmanagement hängt von DQM ab, um Golden Records im Laufe der Zeit vertrauenswürdig zu halten.
Speziell für Analytik und KI fügt DQM zwei Anliegen hinzu, die traditionelles Datenmanagement oft ignoriert: prüfbare Herkunft (damit Sie Trainingsdaten eines Modells bis zur Quelle zurückverfolgen können) und Drift-Erkennung (damit Sie erkennen, wenn Produktionsdaten von der Verteilung abweichen, mit der das Modell trainiert wurde). TechTargets Anleitung rahmt Governance-Integration als Mechanismus, der Rollen, Metadaten, Herkunft und Qualitätsmetriken in ein kohärentes System bindet, anstatt eine Sammlung getrennter Werkzeuge zu sein.
Die Verantwortlichkeit verteilt sich typischerweise auf vier Rollen: Dateneigentümer (verantwortlich für eine Domäne), Datenverantwortliche (verantwortlich für tägliche Qualitätsentscheidungen), Dateningenieure (die die Pipelines und Regelinfrastruktur bauen und warten) und QA- oder Analytik-Ingenieure (die Ausgaben validieren, bevor sie Verbraucher erreichen).
Die kanonischen Dimensionen, die Sie messen müssen
Jedes DQM-Programm bildet auf eine Reihe von Dimensionen ab. Dies sind keine theoretischen Kategorien; jede entspricht einer Klasse von Fehlern, die echten geschäftlichen Schaden verursachen.
| Dimension | Geschäftliche Auswirkungen bei Verletzung | Einfache Prüfung oder Metrik |
|---|---|---|
| Genauigkeit | Falsche Entscheidungen, regulatorische Risiken | Stichprobenprüfung: % der Datensätze, die mit der maßgeblichen Quelle übereinstimmen |
| Vollständigkeit | Fehlende Felder brechen Modelle und Berichte | Vollständigkeit % = (nicht-null Werte / gesamte erwartete Werte) × 100 |
| Konsistenz | Widersprüchliche Werte über Systeme hinweg untergraben Vertrauen | Systemübergreifende Übereinstimmungsrate bei gemeinsamen Schlüsseln |
| Aktualität / Aktualität | Veraltete Daten führen zu veralteten Erkenntnissen | Alter des Datensatzes vs. SLA-Schwelle (z. B. innerhalb von 24 Stunden aktualisiert) |
| Eindeutigkeit | Doppelte Datensätze blähen Zählungen auf und verzerren Analysen | Duplikatrate = (doppelte Zeilen / gesamte Zeilen) × 100 |
| Gültigkeit / Konformität | Ungültige Formate scheitern in der nachgelagerten Verarbeitung | % der Werte, die dem definierten Format oder der Aufzählung entsprechen |
| Integrität / Herkunft | Gebrochene Beziehungen korrumpieren Joins und Aggregationen | Referenzielle Integritätsprüfung: verwaiste Fremdschlüssel / gesamte FKs |
| Relevanz | Irrelevante Daten erhöhen Speicherkosten und Rauschen | % der Felder, die aktiv von nachgelagerten Verbrauchern genutzt werden |
Genauigkeit und Vollständigkeit sind für strukturierte Analysen meist am wichtigsten.
Für KI- und ML-Workloads empfiehlt der AISI-Leitfaden zum Datenqualitätsmanagement , Annotationsqualität, Bias-Erkennung, Versionskontrolle und Drift-Überwachung als separate Prüfungen zu behandeln, die über den kanonischen Dimensionen liegen, anstatt sie darin zu integrieren. Annotationsqualität ist ein eigener Fehlermodus: Ein Label, das technisch „vollständig“ ist, kann dennoch systematisch falsch sein. Drift-Überwachung gehört in die Modell-Serving-Schicht, nicht nur in die Erfassung. Diese sollten Sie zu Ihrem Dimensionsinventar hinzufügen, wenn Sie ML-Modelle erstellen oder warten. Weitere Informationen zum Zusammenhang zwischen Datenqualität und KI-Zuverlässigkeit finden Sie im Ridiculous Engineering-Beitrag über KI und Datenqualität, der die praktischen Auswirkungen eingehend behandelt.
Kernfähigkeiten, die Ihr DQM-Programm haben muss
Ein DQM-Programm ist nur so stark wie die operative Maschinerie dahinter. Die folgenden Fähigkeiten sind die minimale tragfähige Menge für ein produktionsreifes Programm.
Profiling ist die Grundlage. Bevor Sie eine Regel schreiben, müssen Sie wissen, wie Ihre Daten tatsächlich aussehen: Null-Raten, Wertverteilungen, Kardinalität und Formatmuster. Profiling-Tools generieren diese Basislinie automatisch und decken Anomalien auf, die Sie durch Stichprobenbetrachtung nicht finden würden.
Eine Regel-Engine ist der Punkt, an dem Richtlinie zur Durchsetzung wird. Die Dokumentation von Microsoft Purview beschreibt ein praktisches Drei-Teile-Modell für benutzerdefinierte Regeln: einen Zeilenausdruck (die Kernprüfung), einen Filterausdruck (auf welche Zeilen die Regel angewendet wird) und einen Null-Ausdruck (wie mit fehlenden Werten umgegangen wird). Diese Struktur behandelt die Randfälle, die einfache Regex-Prüfungen übersehen. Regeltypen, die Sie mindestens benötigen: Regex-/Formatübereinstimmung, Datentypvalidierung, Null-/Leerzeichen-Erkennung, Eindeutigkeitsprüfungen, Tabellen-Nachschlagevalidierung gegen Referenzdaten und benutzerdefinierte Zeilenausdrücke für Geschäftslogik.
Abgleich und Deduplizierung löst die Eindeutigkeitsdimension im großen Maßstab. Exakter Abgleich per Deduplizierung behandelt einfache Fälle; probabilistisches Matching (unscharfer Name, Adressnormalisierung) ist für Kunden- und Lieferantendaten erforderlich, wenn Datensätze aus mehreren Quellen mit inkonsistenter Formatierung eintreffen.
Sanierungsworkflows schließen den Kreislauf. Drei Muster decken die meisten Situationen ab: automatische Korrektur (sicher für deterministische Korrekturen wie Datumsformatnormalisierung), gestaffelte Quarantäne (Datensatz zurückhalten, kennzeichnen und verhindern, dass er nachgelagerte Verbraucher erreicht, bis er geprüft wurde) und tickerbasierte Steward-Workflows (Ausnahme an einen benannten Eigentümer mit Kontext und Frist weiterleiten). Automatische Korrektur ist schnell, aber riskant, wenn die Korrekturlogik falsch ist. Quarantäne ist der sicherste Standard für mehrdeutige Fälle.
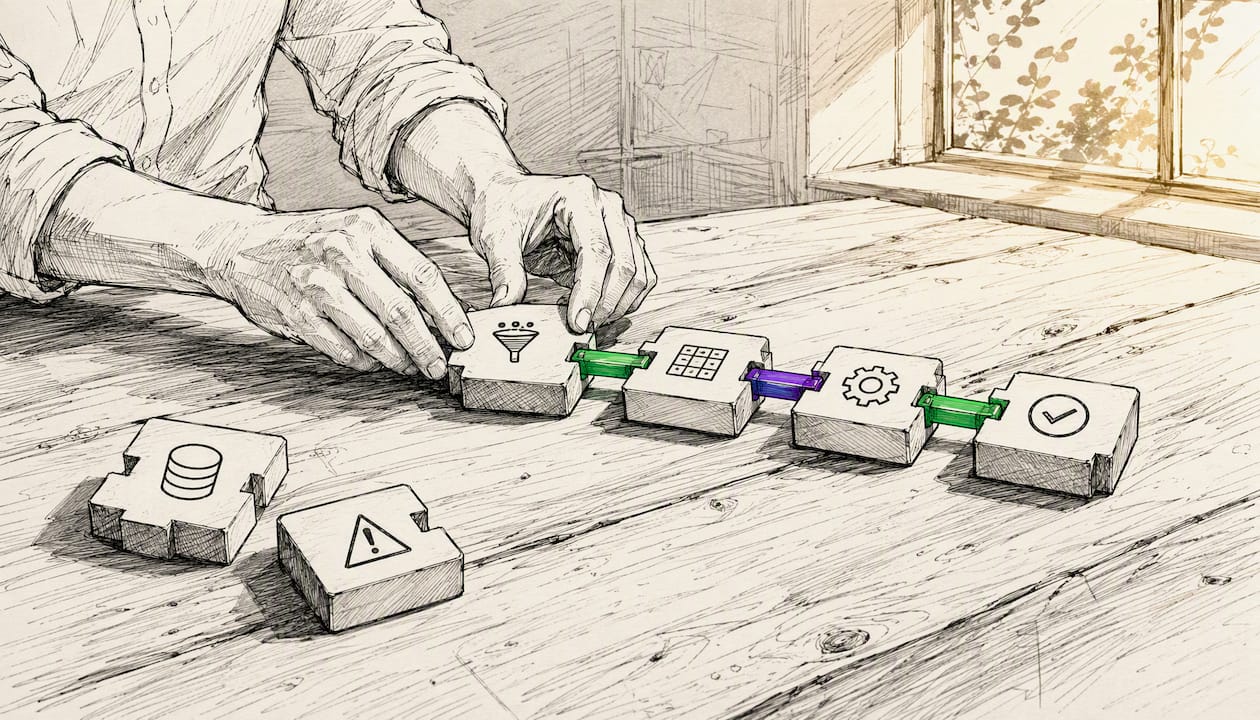
Herkunft und Beobachtbarkeit ermöglichen es Ihnen, die Frage zu beantworten, die sich jeder Prüfer und Modellentwickler irgendwann stellt: Woher stammen diese Daten und was ist mit ihnen passiert? Ohne Herkunftsnachweis können Sie einen Datensatz nicht für Modelltraining oder regulatorische Berichterstattung zertifizieren.
Profi-Tipp: Priorisieren Sie Regeln nach nachgelagerter Auswirkung, nicht nach Implementierungsaufwand. Ordnen Sie jede vorgeschlagene Regel der Pipeline oder dem Bericht zu, den sie schützt, und bewerten Sie dann nach geschäftlicher Kritikalität.
So erstellen Sie ein effektives DQM-Programm
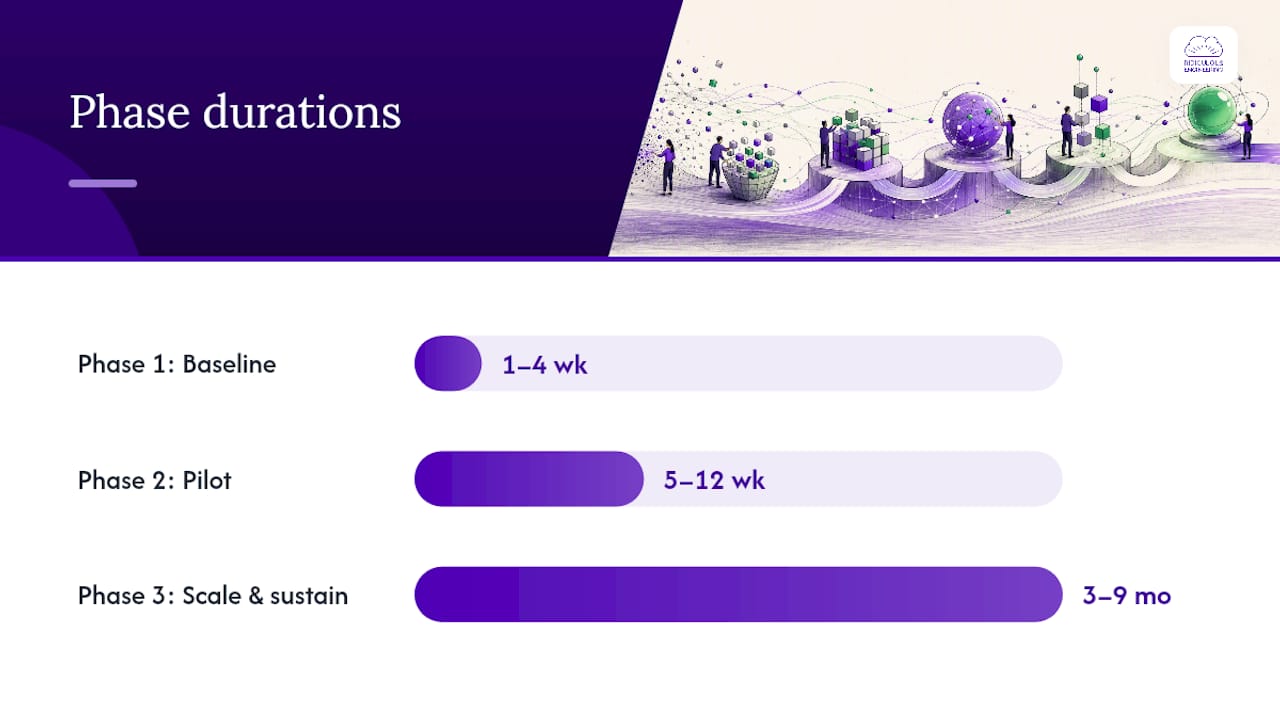
Der Aufbau einer DQM-Fähigkeit ist ein phasenweiser Aufwand. Der Versuch, alles auf einmal zu steuern, ist der häufigste Weg, nichts zu steuern.
Phase 1: Baseline und Umfang (Wochen 1–4)
-
Führen Sie eine Reifegradbewertung durch: dokumentieren Sie aktuelle Profilierungsabdeckung, bestehende Regeln, Eigentumslücken und bekannte Qualitätsvorfälle.
-
Identifizieren Sie kritische Datenelemente (CDEs) – die Felder und Datensätze, die direkt Umsatz, Compliance oder Modellleistung beeinflussen.
-
Profilieren Sie CDEs, um Baseline-Metriken für Vollständigkeit, Eindeutigkeit und Gültigkeit festzulegen.
-
Definieren Sie SLAs: was „gut genug“ für jede Dimension auf jedem Datensatz bedeutet.
Phase 2: Pilot (Wochen 5–12)
-
Entwerfen und implementieren Sie einen Regelsatz für eine hochprioritäre Domäne (Kundendaten sind ein üblicher Ausgangspunkt).
-
Richten Sie Sanierungsworkflows ein: mindestens eine Quarantänewarteschlange und einen Steward-Benachrichtigungsprozess.
-
Automatisieren Sie die Regelausführung in Ihrem ETL oder Ihrer Datenplattform.
-
Veröffentlichen Sie ein einfaches KPI-Dashboard, das Baseline- vs. aktuelle Qualitätswerte zeigt.
Phase 3: Skalieren und aufrechterhalten (Monate 3–9)
-
Erweitern Sie die Regelabdeckung auf zusätzliche Domänen basierend auf CDE-Priorität.
-
Integrieren Sie Qualitätsprüfungen in CI/CD-Pipelines für Datenbestände.
-
Richten Sie einen zertifizierten Datensatzkatalog ein: eine verwaltete Liste von Datensätzen, die definierte Qualitätsschwellen bestanden haben und für Analyse- und Modellnutzung genehmigt sind.
-
Führen Sie vierteljährliche Management-Reviews gegen Qualitäts-KPIs durch, wie vom DAMA-NL DQMS-Framework empfohlen.
Rollen und Verantwortlichkeiten:
-
Executive Sponsor: genehmigt Umfang, Budget und Eskalationspfad; überprüft KPIs vierteljährlich.
-
Dateneigentümer: verantwortlich für Qualitätsergebnisse in ihrer Domäne; genehmigen Regeländerungen.
-
Datenverwalter: lösen Ausnahmen, pflegen Referenzdaten und besitzen Sanierungswarteschlangen.
-
Dateningenieure: bauen und warten Regelinfrastruktur, Pipelines und Überwachung.
-
QA-/Analyseingenieure: validieren Ausgaben vor der Beförderung in den zertifizierten Status.
Die drei Fallstricke, die die meisten Programme zum Scheitern bringen: Übersteuerung (Hunderte von Regeln schreiben, bevor eine durchgesetzt wird), fehlendes Eigentum (Regeln ohne benannten Verwalter werden zu verwaisten Warnungen) und Ignorieren nachgelagerter Verbraucher (Regeln erstellen, die das Datenteam zufriedenstellen, aber nicht die Analysten oder Modellentwickler, die die Daten tatsächlich nutzen). Gartner empfiehltKombination aus Profiling, Monitoring, Stewardship und Governance, während Qualitätsverbesserungen an messbare Geschäftsergebnisse gekoppelt werden – der letzte Teil ist das, was das Programm über das erste Quartal hinaus finanziert.
Profi-Tipp: Führen Sie Ihren Piloten mit dem Datensatz aus, der den Bericht speist, den der ranghöchste Stakeholder jede Woche ansieht. Wenn sich die Qualitätswerte verbessern und der Bericht nicht mehr mit sich selbst in Konflikt gerät, haben Sie eine Geschichte, die die nächste Phase ohne langwierigen Business Case finanziert.
Wo Prüfungen im Datenlebenszyklus anzuwenden sind
Qualitätsprüfungen gehören an mehrere Punkte im Datenlebenszyklus, nicht nur ans Ende. Je weiter stromabwärts ein schlechter Datensatz reist, desto teurer ist die Behebung.
| Lebenszyklusphase | Empfohlene Prüfungen | Prävention oder Erkennung |
|---|---|---|
| Design / Erfassung | Schemadefinition, Aufzählungsbeschränkungen, Pflichtfeld-Durchsetzung an der Quelle | Prävention |
| Erfassung (API, Datei, Stream) | Schemavalidierung, Formatprüfungen, Null-Erkennung, referenzielle Integrität | Prävention |
| Transformation (ETL/ELT) | Vollständigkeit, Eindeutigkeit, tabellenübergreifende Konsistenz, Geschäftsregel-Validierung | Erkennung |
| Stammdaten-/MDM-Ebene | Deduplizierung, Entitätsauflösung, Golden-Record-Zertifizierung | Prävention + Erkennung |
| Analytik / Modelltraining | Label-Konsistenz, Bias-Prüfungen, Verteilungsdrift, Versionskontrolle | Erkennung |
| Bereitstellung / Nutzung | SLA-Zeitnähe-Prüfungen, Validierung des zertifizierten Datensatz-Flags | Erkennung |
| Archivierung | Vollständigkeitsaudit, Lineage-Snapshot | Erkennung |
Präventionsprüfungen an der Quelle sind pro erkanntem Fehler günstiger, erfordern jedoch Koordination mit den Upstream-Systembesitzern, was oft das schwierigere organisatorische Problem ist. Erkennungsprüfungen nach der Erfassung sind einfacher unilateral umzusetzen, lassen aber schlechte Daten weiter reisen, bevor sie erkannt werden.
Ein praktisches Pipeline-Beispiel: Für eine API-Erfassung, die ein Kundenanalytikmodell speist, wenden Sie Schema- und Formatprüfungen am API-Gateway an (Prävention), Vollständigkeits- und Eindeutigkeitsprüfungen in der ETL-Ebene (Erkennung) sowie Label-Konsistenz- und Driftprüfungen in der Modelltraining-Pipeline (Erkennung). Der AISI-Leitfaden empfiehlt ausdrücklich Versionskontrolle und Driftüberwachung als Prüfungen, die zur Modelltraining-Phase gehören, nicht nur zur Erfassung. Der Ridiculous Engineering-Beitrag über operative Datenpipelines behandelt, wie diese Muster in Produktionsumgebungen angewendet werden.
Welche Metriken und KPIs den DQM-Wert tatsächlich belegen
Qualitätsmetriken erhalten nur dann Führungsunterstützung, wenn sie mit Ergebnissen verbunden sind, die das Unternehmen bereits verfolgt.
Primäre zu verfolgende Metriken:
-
Vollständigkeitswert: (Nicht-Null-Werte / Gesamte erwartete Werte) × 100, pro Datensatz und pro CDE.
-
Duplikatrate: (Duplikatzeilen / Gesamte Zeilen) × 100; Ziel variiert je nach Domäne, aber unter 1 % ist ein vernünftiger Ausgangs-SLA für Kundenhauptdaten.
-
Genauigkeitsrate: % der Stichproben-Datensätze, die mit einer maßgeblichen Quelle übereinstimmen; eine Stichprobe von 200–500 Datensätzen pro Datensatz und Quartal ist für die meisten Programme ausreichend.
-
Einhaltung der Aktualitäts-SLA: % der Datensätze, die innerhalb des definierten Aktualitätsfensters aktualisiert wurden.
-
Übernahme zertifizierter Datensätze: % der Analyse- und Modell-Workloads, die Daten aus dem zertifizierten Katalog verbrauchen, im Vergleich zu nicht zertifizierten Quellen.
-
Mittlere Erkennungszeit (MTTD): durchschnittliche Zeit vom Auftreten eines Qualitätsproblems bis zur Kennzeichnung durch Überwachung.
-
Mittlere Behebungszeit (MTTR): durchschnittliche Zeit von der Erkennung bis zur Lösung; ein Steward-Workflow mit klarer Zuständigkeit reduziert die MTTR typischerweise stärker als Automatisierung allein.
Praktische Programme messen Übernahme und Ergebnisse statt Aktivitätszahlen, so das Governance-Playbook von InfiniSynapse. Kennzahlen wie die Nutzung zertifizierter Datensätze, die Reduzierung von Berichtskonflikten und die Zeit bis zur Prüfung sind diejenigen, die bei Finanz- und Betriebsleitern Anklang finden.
Eine einfache KPI-Dashboard-Zeile sieht so aus: Kennzahlname, aktueller Wert, Ziel/SLA, Trend (auf/ab/stabil) und Verantwortlicher. Die monatliche Veröffentlichung dieses Dashboards für Stakeholder ist effektiver als eine vierteljährliche Tiefenanalyse, da sie die Qualität als operatives Anliegen sichtbar macht und nicht als periodische Prüfung.
So bewerten Sie die Technologielandschaft
Die Tool-Auswahl sollte der Strategie folgen, nicht vorausgehen. Klären Sie Ihre Domänen, Workflows und Erfolgskennzahlen, bevor Sie Plattformen bewerten.
Zu berücksichtigende Tool-Kategorien:
-
Datenprofilierung und -beobachtbarkeit: automatisierte Basismessung, Anomalieerkennung und Drift-Warnung. Diese Tools generieren die Nachweise, die Regelinvestitionen rechtfertigen.
-
Datenkataloge und Herkunft: Metadatenverwaltung, Datensatzdokumentation und End-to-End-Herkunftsverfolgung. Kritisch für zertifizierte Datensatzprogramme und Prüfungsbereitschaft.
-
Regel-Engines und Validatoren: die Durchsetzungsebene. Achten Sie auf Unterstützung für die Regeltypen, die im Regel-Autorenleitfaden von Microsoft Purview dokumentiert sind: Regex, Datentyp, Null/leer, Eindeutigkeit, Tabellennachschlag und benutzerdefinierte Zeilenausdrücke mit Null-Behandlung.
-
Abgleich- und Deduplizierungs-Engines: probabilistischer und deterministischer Abgleich für die Entitätsauflösung.
-
MDM-Plattformen: Golden-Record-Verwaltung für Kerneinheiten.
-
Orchestrierung und Überwachung: Pipeline-Planung, Warnung und SLA-Verfolgung.
Kaufen vs. Bauen: Kaufen Sie eine integrierte Plattform, wenn Sie Herkunft, Katalog und Zertifizierung in einem einzigen System mit Prüfprotokollen und rollenbasierter Zugriffskontrolle benötigen. Bauen Sie (oder stellen Sie Best-of-Breed zusammen), wenn Ihr Anwendungsfall eng ist, Ihr bestehender Stack die meisten Funktionen bereits abdeckt oder Sie eine tiefe Integration mit einer bestimmten Datenplattform benötigen. Das Risiko bei Best-of-Breed sind Integrationslücken: Metadaten fließen nicht automatisch zwischen Tools, und Sie müssen eine benutzerdefinierte Orchestrierungsebene pflegen, die selbst zur Wartungslast wird.
Checkliste für nicht-funktionale Anforderungen: Skalierbarkeit auf Ihr Datenvolumen, prüfbare Protokolle für Compliance, rollenbasierte Zugriffskontrolle, API-first-Integration für Pipeline-Einbettung und KI-Bereitschaft (die Fähigkeit, Datensätze für die Modellnutzung zu zertifizieren und Datensatzversionen zu verfolgen). Für Teams, die KI-nahe Datenprodukte entwickeln, kann eine strukturierte Datenprüfung Schema-Konformitätslücken aufdecken, die die LLM-Bereitschaft beeinträchtigen, bevor sie das Modelltrainingsstadium erreichen.
Standards und Frameworks, die es wert sind, übernommen zu werden
Sie müssen nicht jede Klausel jedes Standards implementieren. Der Wert von Standards liegt darin, dass sie Ihnen ein prüfungsbereites Vokabular und eine Checkliste von Kontrollen geben, die Sie sonst möglicherweise übersehen.
-
ISO/IEC 5259-3:2024 ist der direkt relevanteste Standard für analytik- und ML-fokussiertes DQM. Er definiert Anforderungen für die Verwaltung der Datenqualität über den Analyse- und Maschinenlern-Lebenszyklus, mit Schwerpunkt auf prüfbaren Kontrollen und vertrauenswürdigen Ergebnissen. Nutzen Sie ihn, um Ihre Lebenszyklusabdeckung zu validieren und Anforderungen für regulierte oder risikoreiche KI-Anwendungen zu formulieren.
-
DAMA-NL DQMS-Framework übersetzt technische DQM-Kontrollen in eine Managementsystemstruktur: Richtlinie, kritische Datenelemente, Verbesserungsmaßnahmen, Regeln, Überwachung und Zertifizierung. Es ist besonders nützlich, wenn Sie interne Prüfdokumentation vorbereiten oder wenn eine Compliance-Funktion Nachweise dafür möchte, dass Qualität systematisch und nicht ad hoc verwaltet wird.
-
AISI-Leitfaden zur Datenqualitätsverwaltung bietet praktische, KI-spezifische Anleitung zu Annotationsqualität, Bias-Erkennung, Versionskontrolle und Drift-Überwachung. Behandeln Sie es als Ergänzung zu ISO/IEC 5259-3 für ML-lastige Programme.
-
Gartner- und TechTarget-Analystenleitfaden bieten Perspektiven zur Programmgestaltung und Governance-Integration, die für die Rahmung von Führungsgesprächen und Anbieterbewertungen nützlich sind.
So nutzen Sie diese Standards praktisch: Wählen Sie die Klauseln aus, die für Ihren aktuellen Reifegrad am relevantesten sind, ordnen Sie sie Ihren bestehenden Kontrollen zu und behandeln Sie die Lücken als priorisierten Rückstand. Eine vollständige ISO-Implementierung ist ein mehrjähriges Unterfangen; die Verwendung des Standards als Audit-Checkliste für einen 90-Tage-Pilotversuch ist sofort nützlich und kostet nichts.
Wie Ridiculous Engineering DQM-Engagements angeht
Die Engagements, die gut laufen, folgen einem gemeinsamen Muster: eine straffe Discovery-Phase, ein Pilot, der auf einen Bereich beschränkt ist, und eine Übergabe, die es dem Team des Kunden ermöglicht, das Programm ohne laufende Abhängigkeit von externer Hilfe zu betreiben.
Discovery und Umfangsfestlegung (Wochen 1–2): Wir inventarisieren Datenbestände, ordnen CDEs Geschäftsprozessen zu und identifizieren die drei bis fünf Datensätze mit dem höchsten Qualitätsrisiko und Geschäftseinfluss. Das Ergebnis ist eine priorisierte Datenbestandsinventur und ein Umfangsdokument, das Pilotgrenzen, Erfolgskennzahlen und Rollen definiert.
Profilierung und Basislinie (Wochen 2–4): Automatisierte Profilierung über die Prioritätsdatensätze legt Basislinien für Vollständigkeit, Eindeutigkeit, Gültigkeit und Aktualität fest. Wir dokumentieren die Ergebnisse in einem Profilbericht, der den Vorzustand für die KPI-Verfolgung darstellt.
Pilotregelentwicklung und Automatisierung (Wochen 4–8): Wir entwerfen einen Regelsatz für den höchstpriorisierten Bereich, implementieren ihn in der bestehenden Datenplattform oder Pipeline-Tooling des Kunden und richten einen Quarantäne- und Steward-Benachrichtigungsworkflow ein. Liefergegenstände: eine Regelbibliothek, ein Sanierungshandbuch und eine funktionierende automatisierte Pipeline.
Skalierung und Übergabe (Wochen 8–16): Wir erweitern die Abdeckung auf zusätzliche Bereiche, richten einen zertifizierten Datensatzkatalog ein, veröffentlichen ein KPI-Dashboard und führen Onboarding-Sitzungen mit Dateneigentümern und Stewards durch. Das endgültige Liefergegenstand ist ein dokumentiertes Programm, das das Team des Kunden unabhängig betreiben und erweitern kann.
Häufige Fallstricke, die wir sehen, und wie wir sie angehen:
-
Umfangserweiterung: Wir legen die Pilotbereichsgrenze im Umfangsdokument fest und verlangen eine formelle Änderungsanfrage zur Erweiterung. Das klingt bürokratisch, bis in der dritten Woche jemand sechs weitere Datensätze hinzufügen möchte.
-
Fehlende Eigentümerschaft: Wir verlangen einen benannten Dateneigentümer für jeden Datensatz, bevor wir eine Regel schreiben. Eine Regel ohne Eigentümer ist eine Warnung ohne jemanden, der darauf antwortet.
-
Unterinvestition in Sanierungsautomatisierung: Teams verbringen oft 80% ihrer Anstrengung mit Regelautorentätigkeit und 20% mit Sanierung. Das Verhältnis sollte näher an 50/50 liegen. Ein unkorrigierter Fehler, der wiederholt erkannt wird, ist schlechter für die Moral als ein Fehler, der nie erkannt wird.
Checkliste zur Anbieterbewertung: Fragen Sie bei der Bewertung eines Beratungsunternehmens oder internen Plans nach einem Beispielprofilbericht aus einem früheren Engagement, einer Regelbibliothek mit mindestens 10 dokumentierten Regeln und deren geschäftlicher Begründung, einem Sanierungshandbuch mit Eskalationspfaden und einer KPI-Dashboard-Vorlage. Wenn ein Anbieter diese Artefakte nicht produzieren kann, verkauft er Governance-Theater, kein funktionierendes Programm.
Was in diesem Quartal zu priorisieren ist
Drei bis fünf fokussierte Aktionen liefern mehr Wert als eine breite Initiative, die in der Planungsphase ins Stocken gerät.
Für Führungssponsoren:
-
Weisen Sie diese Woche einen benannten Dateneigentümer für Ihre Top-fünf-Datensätze zu. Ohne Eigentümerschaft ist jede andere Investition in Qualität fragil.
-
Genehmigen Sie einen 30-tägigen Profilierungs-Sprint mit definiertem Ergebnis: Basislinien für Vollständigkeit, Eindeutigkeit und Gültigkeit für CDEs.
-
Verpflichten Sie sich zu einem vierteljährlichen KPI-Überprüfungsrhythmus, bevor das Programm startet, nicht danach.
Für Engineering- und Datenteams:
-
Profilieren Sie die fünf Datensätze, die Ihre kritischsten Berichte oder Modelle speisen. Dokumentieren Sie Nullraten, Duplikatraten und Formatverletzungen.
-
Implementieren Sie drei automatisierte Regeln in Ihrer bestehenden Pipeline: eine Format-/Regex-Prüfung, eine Null-/Leer-Prüfung und eine Eindeutigkeitsprüfung auf Primärschlüsseln.
-
Richten Sie eine Quarantäne-Warteschlange und eine Steward-Benachrichtigung für Regelverletzungen ein. Selbst eine einfache E-Mail-Warnung an einen benannten Eigentümer ist besser als stilles Versagen.
-
Erstellen Sie eine zertifizierte Datensatzliste: ein einfaches Register von Datensätzen, die definierte Qualitätsschwellen bestanden haben und für die nachgelagerte Nutzung genehmigt sind.
Der Beitrag zum Datenaustausch und Governance von Ridiculous Engineering behandelt die Stakeholder-Koordinationsseite dieser Arbeit, die oft das schwierigere Problem ist als die technische Implementierung.
Ridiculous Engineering baut DQM-Programme, die tatsächlich in der Produktion laufen
Die meisten Organisationen haben bereits die Datenplattformen und Pipeline-Tools, die sie benötigen, um ein solides DQM-Programm auszuführen. Was ihnen fehlt, ist die Architektur, das Regeldesign und die operative Struktur, um es zuverlässig in großem Maßstab zum Laufen zu bringen. Das ist die Lücke, die Ridiculous Engineering füllt.
Wir arbeiten mit Mid-Market- und Enterprise-Teams zusammen, um Systeme für Datenqualität und Analytik zu entwerfen und zu implementieren, die direkt mit Geschäftsergebnissen verbunden sind: weniger Abstimmungszyklen, schnellere Zeit bis zur Erkenntnis und Trainingsdaten für Modelle, die Sie tatsächlich zertifizieren können. Unsere Engagements sind darauf ausgelegt, in 30–90 Tagen einen funktionierenden Pilot zu liefern, mit einer klaren Übergabe, sodass Ihr Team das Programm langfristig besitzt.
Wenn Sie bereit sind, von Profiling zu produktionsreifen Kontrollen überzugehen, sprechen Sie mit dem Ridiculous Engineering-Team über ein abgegrenztes DQM-Engagement.
Quellen
-
Microsoft Purview: Einheitlicher Katalog – Datenqualitätsregeln
-
Rahmenwerk für Datenqualitätsmanagementsysteme – DAMA-NL (2024 v12)
-
So entwickeln Sie eine Daten-Governance-Strategie: 7 wichtige Schritte – TechTarget
FAQ
Was ist Datenqualitätsmanagement?
Datenqualitätsmanagement ist die Gesamtheit von Praktiken, Regeln und operativen Kontrollen, die Organisationsdaten genau, vollständig, konsistent und für ihren beabsichtigten Einsatz in Analytik, KI und Geschäftsentscheidungen geeignet halten. Es deckt den gesamten Datenlebenszyklus von der Erfassung bis zur Archivierung ab.
Was sind die vier C’s der Datenqualität?
Definitionen variieren je nach Rahmenwerk, aber eine gängige Version umfasst Korrektheit (Genauigkeit), Vollständigkeit, Konsistenz und Aktualität (Rechtzeitigkeit). Diese vier Dimensionen erscheinen in den meisten DQM-Rahmenwerken als Kernmaßstäbe dafür, ob Daten für Entscheidungsfindung zuverlässig sind.
Was sind die fünf wichtigsten Maße der Datenqualität?
Die am häufigsten zitierten Maße sind Genauigkeit, Vollständigkeit, Konsistenz, Aktualität und Eindeutigkeit. Viele Programme fügen auch Gültigkeit (Konformität mit definierten Formaten oder Aufzählungen) und Integrität (referenzielle Beziehungen zwischen Datensätzen) hinzu, wenn das Programm reift.
Was sind die Kernprinzipien der Datenqualität?
Die vier Prinzipien, auf die sich die meisten Governance-Rahmenwerke einigen, sind Zweckmäßigkeit (Daten erfüllen die Bedürfnisse ihrer Nutzer), Verantwortlichkeit (benannte Eigentümer für jeden Datensatz), Messbarkeit (Qualität wird mit definierten Metriken und SLAs verfolgt) und kontinuierliche Verbesserung (Qualität wird als laufende operative Aktivität überwacht und behoben, nicht als einmalige Korrektur).