Kubernetes-Kostenoptimierung: Ein DevOps-Leitfaden für 2026
Kubernetes-Kostenoptimierung: Ein DevOps-Leitfaden für 2026 Kubernetes-Kostenoptimierung ist die Praxis, Verschwendung von Cloud-Infrastruktur zu reduzieren und gleichzeitig die Zuverlässigkeit zu wahren, indem Ressourcen richtig dimensioniert, die Skalierung automatisiert und vergünstigte Compute-Optionen genutzt werden.
Kubernetes-Kostenoptimierung: Ein DevOps-Leitfaden für 2026
Kubernetes-Kostenoptimierung ist die Praxis, Verschwendung von Cloud-Infrastruktur zu reduzieren und gleichzeitig die Zuverlässigkeit zu wahren, indem Ressourcen richtig dimensioniert, die Skalierung automatisiert und vergünstigte Compute-Optionen genutzt werden. Das Kernproblem ist struktureller Natur: Kubernetes-Abrechnungen basieren auf Pod-Ressourcenanforderungen, nicht auf der tatsächlichen Nutzung, sodass Cluster auch bei geringem Datenverkehr teuer bleiben. Die durchschnittliche CPU-Auslastung in Produktionsclustern liegt bei nur 8–12 % der bereitgestellten Kapazität, was bedeutet, dass die meisten Teams jede Stunde eines jeden Tages für ungenutzte Rechenleistung zahlen. Die gute Nachricht ist, dass Teams, die Strategien zur richtigen Dimensionierung, automatischen Skalierung und Spot-Instanzen anwenden, konsequent 30–60 % Reduzierung der Kubernetes-Ausgaben erreichen, wobei viele bereits im ersten Monat bedeutende Einsparungen sehen.
Wie treibt die richtige Dimensionierung von Pod-Ressourcenanforderungen Kubernetes-Kosteneinsparungen voran?
Die richtige Dimensionierung ist der stärkste Hebel in jedem Kostensenkungsprozess. Kubernetes plant Pods basierend auf ihren deklarierten Ressourcen-anforderungen, nicht auf dem, was sie tatsächlich verbrauchen. Ein Pod, der 2 CPU-Kerne anfordert, reserviert diese Kapazität auf einem Knoten, unabhängig davon, ob er zur Laufzeit 0,2 Kerne nutzt. Diese Lücke zwischen Anforderungen und tatsächlicher Nutzung ist der Ort, an dem sich das meiste Budget verschwendet.
Die praktische Lösung besteht darin, Anforderungen auf das 99. Perzentil der historischen Nutzung plus 20 % Puffer zu setzen. Ein bis zwei Wochen Überwachung geben genügend Signal, um die Differenz zwischen dem, was Pods anfordern, und dem, was sie tatsächlich verbrauchen, zu identifizieren. Diese Differenz ist oft eine 3- bis 8-fache Überschätzung, was bedeutet, dass Ihr Cluster mit einem Bruchteil seiner aktuellen Knotenanzahl betrieben werden könnte.
Wichtige Praktiken für sichere richtige Dimensionierung:
-
Zuerst prüfen. Ziehen Sie tatsächliche Nutzungsmetriken aus Prometheus oder der nativen Überwachung Ihres Cloud-Anbieters, bevor Sie Anforderungen ändern.
-
Verwenden Sie den Vertical Pod Autoscaler (VPA) im Empfehlungsmodus. VPA analysiert historische Nutzung und schlägt richtig dimensionierte Werte vor, ohne sie automatisch anzuwenden, und gibt Ihnen Kontrolle, bevor Sie sich festlegen.
-
Setzen Sie Speicherlimits sorgfältig. Speicher-OOMKill-Ereignisse lassen Pods abstürzen. Halten Sie Speicherlimits daher leicht über den Anforderungen, anstatt sie gleichzusetzen.
-
Vermeiden Sie es, CPU-Anforderungen gleich CPU-Limits zu setzen. CPU-Drosselung unter Limits verursacht Latenzspitzen, ohne den Pod abstürzen zu lassen, was die Erkennung erschwert.
-
Iterieren Sie zuerst in der Staging-Umgebung. Wenden Sie neue Anforderungswerte auf Nicht-Produktions-Workloads an, messen Sie eine Woche lang die Stabilität und rollen Sie dann in die Produktion aus.
Ergebnisse aus der Praxis bestätigen diesen Ansatz. Fallstudien zeigen monatliche Rechnungen, die innerhalb weniger Monate nach richtiger Dimensionierung in Kombination mit automatischer Skalierung von 52.000 $ auf 23.000 $ und von 85.000 $ auf 34.000 $ sinken. Die Einsparungen sind nicht theoretisch.
Profi-Tipp: Setzen Sie CPU-Anforderungen in der Produktion niemals gleich CPU-Limits. Drosselung ist still und verschlechtert die Leistung, ohne Alarme auszulösen, was sie zu einer der häufigsten versteckten Ursachen für Latenz in Kubernetes-Workloads macht.
Welche Autoskalierungsstrategien optimieren die Workload-Elastizität?
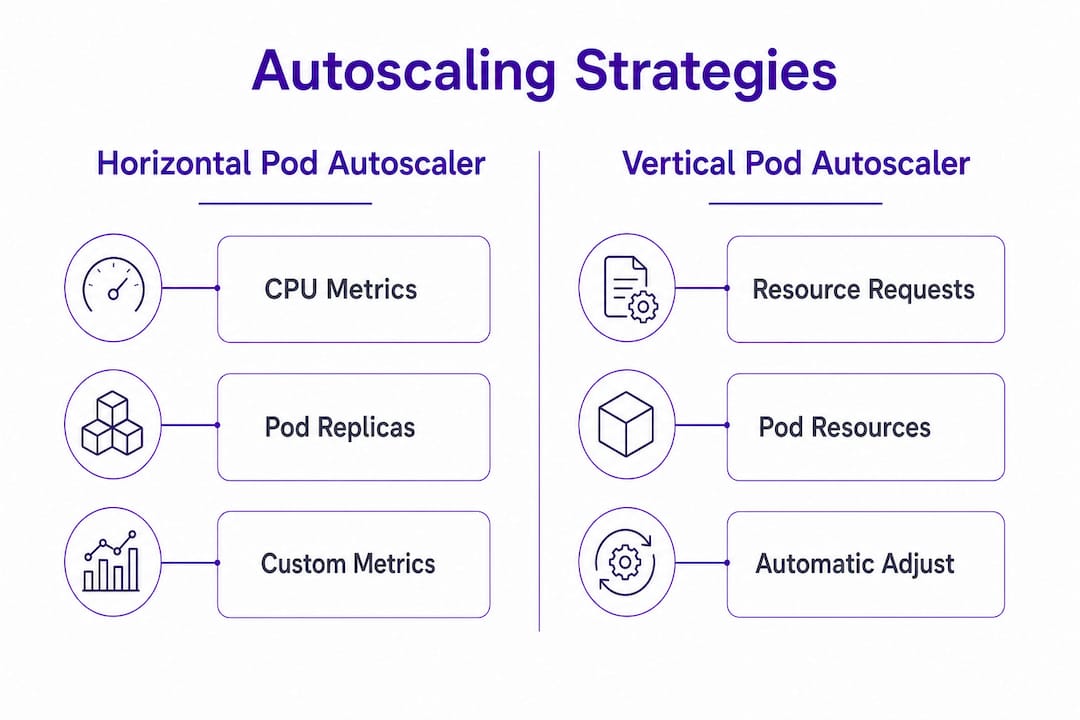
Statische Ressourcenzuweisung ist der Feind der Kosteneffizienz. Autoskalierung ersetzt feste Kapazität durch dynamische Kapazität, die der tatsächlichen Nachfrage folgt. Drei Tools decken das gesamte Spektrum der Skalierungsanforderungen ab: der Horizontal Pod Autoscaler (HPA), der Vertical Pod Autoscaler (VPA) und KEDA (Kubernetes Event-Driven Autoscaler).
HPA skaliert Pod-Replikate horizontal basierend auf CPU- oder benutzerdefinierten Metriken. VPA passt einzelne Pod-Ressourcenanforderungen im Laufe der Zeit vertikal an. KEDA erweitert HPA um ereignisgesteuerte Skalierung aus Quellen wie Kafka, SQS oder HTTP-Anfragewarteschlangen und unterstützt kritischerweise Scale-to-Zero für Workloads, die Kaltstarts tolerieren können. Die Trennung der Zuständigkeiten über diese drei Tools gibt Teams präzise Kontrolle: VPA verwaltet die Speichergröße, HPA verwaltet CPU-gesteuerte Replikatanzahlen und KEDA verwaltet ereignisgesteuerte Spitzen- und Leerlaufmuster.
Die Knotenbereitstellung ist der Bereich, in dem die größten Infrastruktureinsparungen auftreten. Karpenter reduziert Compute-Verschwendung um 15–30 % im Vergleich zum älteren Cluster Autoscaler, indem es dynamisch die kosteneffizientesten Instanztypen aus Tausenden von Optionen auswählt. Karpenter unterstützt auch automatisierte Knotenkonsolidierung, die Workloads auf weniger Knoten bündelt und unterausgelastete beendet. Dies ist der Mechanismus hinter den größten dokumentierten Kostensenkungen. Für Teams, die Ereignisse mit hohem Datenverkehr verwalten, schafft die Kombination von Karpenter mit HPA ein System, das schnell hochskaliert und aggressiv wieder herunterskaliert.
Bewährte Praktiken für Autoscaling, die Sie sofort umsetzen sollten:
-
Konfigurieren Sie HPA-Abskalierungs-Stabilisierungsfenster auf 5–10 Minuten statt der Standardeinstellung von 5 Minuten, um Flattern zu vermeiden, aber stellen Sie die Hochskalierung so ein, dass sie innerhalb von 60 Sekunden reagiert.
-
Nutzen Sie Karpenter-Konsolidierungsrichtlinien, um überdimensionierte Knoten während Zeiten geringer Nachfrage automatisch durch kleinere, günstigere zu ersetzen.
-
Legen Sie KEDA-Trigger fest, um Batch-Jobs zwischen den Ausführungen auf null zu skalieren und so Leerlauf-Pod-Kosten vollständig zu eliminieren.
Profi-Tipp: Konfigurieren Sie HPA mit aggressivem Abskalierungsverhalten, indem Sie scaleDown.stabilizationWindowSeconds auf 300 und percentPod -Richtlinien so einstellen, dass 50 % der überschüssigen Pods pro Minute entfernt werden. Allein das kann die Nebenzeiten-Computekosten für variable Workloads um 20–40 % senken.
Wie können Spot-Instanzen und Architekturänderungen Einsparungen verstärken?
Entscheidungen auf Infrastrukturebene verstärken die Einsparungen durch Rightsizing und Autoscaling. Spot-Instanzen bieten Einsparungen von 60–90 % gegenüber On-Demand-Preisen und sind damit der wirkungsvollste Preismechanismus, der verfügbar ist. Der Haken ist das Unterbrechungsrisiko. Spot-Instanzen können vom Cloud-Anbieter mit einer Ankündigungsfrist von zwei Minuten zurückgefordert werden, daher ist die Auswahl der Workloads entscheidend.
Zustandslose Workloads, Batch-Jobs und CI/CD-Runner sind ideale Kandidaten für Spot. Zustandsbehaftete Workloads, Datenbanken und alles, was persistente Verbindungen erfordert, sollten auf On-Demand-Knoten bleiben. Implementieren Sie Spot sicher, indem Sie Pod-Disruption-Budgets mit Node-Toleranzen kombinieren, die auf Spot-Node-Pools abzielen. Karpenter übernimmt den Spot-Fallback automatisch und wechselt zu On-Demand, wenn Spot-Kapazität nicht verfügbar ist.
| Optimierung | Geschätzte Einsparungen | Implementierungskomplexität |
|---|---|---|
| Spot-Instanzen (zustandslose Workloads) | 60–90 % bei berechtigter Compute-Leistung | Mittel |
| Graviton-ARM-Prozessoren | ~20 % Kostensenkung | Niedrig bis Mittel |
| gp3-EBS-Volume-Migration | ~20 % Speicherkostensenkung | Niedrig |
| Konsolidierte Ingress-Controller | Variabel, reduziert die Anzahl der Load Balancer | Niedrig |
| NAT-Gateway-VPC-Endpunkte | Reduziert Datenübertragungsgebühren | Niedrig |
Die Migration zu ARM-basierten Graviton-Instanzen führt zu etwa 20 % geringeren Kosten bei vergleichbarer oder besserer Leistung für die meisten Workloads. Karpenter kann Graviton automatisch anvisieren, wenn Sie ARM als bevorzugte Architektur in Ihrer NodePool-Konfiguration angeben. Die Migration von gp2 zu gp3-EBS-Volumes senkt die Speicherkosten um etwa 20 % ohne Ausfallzeiten, da die Migration online erfolgt. Dies sind Änderungen mit geringem Aufwand und garantierten Erträgen.
Netzwerkkosten werden häufig übersehen. NAT-Gateway-Datenübertragungsgebühren summieren sich schnell in Clustern mit starkem Egress. Das Hinzufügen von VPC-Endpunkten für Dienste wie S3 und ECR leitet Datenverkehr privat und umgeht NAT vollständig. Die Konsolidierung mehrerer Ingress-Controller in einem einzigen gemeinsamen Controller reduziert auch die Anzahl der bereitgestellten Cloud-Load-Balancer, was die monatlichen Fixkosten direkt senkt.
Welche Governance-Praktiken erhalten die Kubernetes-Kostenoptimierung aufrecht?
Technische Optimierungen verfallen ohne Governance. Teams kehren zur Überdimensionierung zurück, wenn keine Transparenz darüber besteht, wer welche Ausgaben verursacht. Kostenallokation durch Showback und Chargeback gibt Engineering-Teams direkte Einblicke in die Kosten ihrer Workloads, was das Verhalten zuverlässiger ändert als jedes Richtliniendokument.
Die Grundlage ist konsistentes Labeling. Jeder Namespace, jedes Deployment und jedes persistente Volume sollte Labels für Team, Umgebung und Kostenstelle tragen. Die Durchsetzung von Labeling mit Admission-Controllern wie OPA Gatekeeper oder Kyverno verhindert, dass nicht gekennzeichnete Ressourcen überhaupt erstellt werden. Ohne Durchsetzung verschlechtert sich die Label-Abdeckung im Laufe der Zeit, da Teams schnell arbeiten und das Tagging überspringen.
Governance-Praktiken, die Einsparungen aufrechterhalten:
-
Führen Sie wöchentliche Kostenüberprüfungen mit OpenCost oder Kubecost durch, um Trends bei den Ausgaben auf Namespace-Ebene sichtbar zu machen.
-
Legen Sie Budgetwarnungen auf Namespace-Ebene fest, damit Teams Benachrichtigungen erhalten, bevor sie zu viel ausgeben, nicht danach.
-
Planen Sie monatliche Bereinigungen von verwaisten PersistentVolumeClaims, inaktiven Namespaces und veralteten ConfigMaps.
-
Weisen Sie jedem Team einen FinOps-Champion zu, der Kostenkennzahlen neben Zuverlässigkeitskennzahlen verwaltet.
Kultureller Wandel ist genauso wichtig wie technische Feinabstimmung. Die Einbettung von Kostenverantwortung in Sprint-Reviews und Engineering-OKRs sichert langfristige Einsparungen. Teams, die Cloud-Ausgaben als gemeinsame Engineering-Kennzahl betrachten und nicht als Finanzproblem, übertreffen durchweg diejenigen, die Optimierung als einmaliges Projekt behandeln. Die Dimension der Engineering-Kultur von DevOps ist der Ort, an dem dauerhafte Kostendisziplin lebt.
Profi-Tipp: Beginnen Sie mit Showback vor Chargeback. Wenn Sie Teams ihre Kosten zeigen, ohne sie zunächst zu belasten, schafft das Bewusstsein und Akzeptanz. Chargeback ohne Kontext erzeugt Reibung und Widerstand statt Eigenverantwortung.
Wichtige Erkenntnisse
Effektive Kubernetes-Kostenoptimierung erfordert zuerst die richtige Dimensionierung von Ressourcenanfragen, dann die Schichtung von Autoscaling und vergünstigtem Rechnen und schließlich die Einbettung von Governance, um Verschwendung zu verhindern.
| Punkt | Details |
|---|---|
| Pod-Anfragen zuerst richtig dimensionieren | Setzen Sie Anfragen auf P99-Nutzung plus 20% Puffer; verwenden Sie VPA im Empfehlungsmodus, bevor Sie Änderungen anwenden. |
| Auf jeder Ebene autoskalieren | Kombinieren Sie HPA, VPA, KEDA und Karpenter, um Kapazität dynamisch an die Nachfrage anzupassen. |
| Spot- und Graviton-Instanzen verwenden | Spot spart 60–90% bei geeigneten Workloads; Graviton senkt Rechenkosten um etwa 20%. |
| Beschriftung und Zuordnung durchsetzen | Verwenden Sie OPA Gatekeeper oder Kyverno, um Labels vorzuschreiben; führen Sie Showback-Berichte aus, um Teamverantwortung aufzubauen. |
| Messen, bevor Sie kürzen | Stellen Sie Kostentransparenz mit OpenCost oder Kubecost her, bevor Sie Infrastrukturänderungen vornehmen. |
Was ich aus realer Kubernetes-Kostenarbeit gelernt habe
Der häufigste Fehler, den ich bei Teams sehe, ist, direkt zu Spot-Instanzen oder Load-Balancer-Konsolidierung zu springen, bevor sie ihre Ressourcenanfragen korrigieren. Das sind echte Einsparungen, aber sie sind Multiplikatoren auf einer kaputten Basislinie. Wenn Ihre Pods das 4-fache dessen anfordern, was sie nutzen, bleibt bei Spot-Preisen für diese Pods der meiste Abfall intakt.
Die Reihenfolge ist wichtig: zuerst Transparenz, dann richtige Dimensionierung, dann Preisoptimierung. Teams, die dieser Reihenfolge folgen, erzielen konsequent größere und dauerhaftere Reduktionen als Teams, die schnelle Erfolge außerhalb der Reihenfolge jagen. Ich habe gesehen, wie Organisationen ihre Rechnungen innerhalb von 90 Tagen halbiert haben, indem sie dieser Sequenz folgten, und ich habe andere gesehen, die Monate mit Reserved-Instance-Verhandlungen verbrachten, während ihre Cluster bei 10% Auslastung liefen.
Das schwierigere Problem ist organisatorisch. Ingenieure überdimensionieren nicht aus Nachlässigkeit. Sie tun es, weil sie an Zuverlässigkeit gemessen werden, nicht an Kosten. Bis Kosten im selben Dashboard wie Betriebszeit und Latenz erscheinen, bleiben sie unsichtbar. Die Teams, die Einsparungen aufrechterhalten, sind diejenigen, die Kosten zu einer erstklassigen Engineering-Kennzahl machen, die im selben Meeting überprüft wird, in dem sie SLOs überprüfen. Diese Verschiebung ist schwieriger als jede Karpenter-Konfiguration und sie zählt mehr.
— Paul CEO
Ridiculousengineering kann Ihnen helfen, Kubernetes-Kosten zu senken
Kubernetes-Kostenreduzierung ist eine technische und organisatorische Herausforderung. Es richtig zu machen erfordert genaue Workload-Analyse, gut gestaltete Automatisierung und Governance-Systeme, die unter echtem Engineering-Teamdruck standhalten.
Ridiculousengineering arbeitet mit IT-Managern und DevOps-Teams zusammen, um die Cloud-Infrastruktur, Automatisierung und Governance-Tools zu entwerfen und zu bauen, die Kosteneffizienz nachhaltig machen. Von der Dimensionierungsanalyse bis zu maßgeschneiderten Cloud-Architektur- und DevOps-Diensten, bringt das Team sowohl die technische Tiefe als auch die organisatorische Erfahrung mit, um Ihre Kubernetes-Ausgaben in die richtige Richtung zu bewegen. Wenn Ihre Cluster-Rechnungen nicht Ihre tatsächliche Workload widerspiegeln, ist diese Lücke es wert, geschlossen zu werden.
FAQ
Was ist der schnellste Weg, um Kubernetes-Kosten zu senken?
Die richtige Dimensionierung von Pod-Ressourcenanfragen liefert die schnellsten Einsparungen. Teams sehen üblicherweise 20–30% Reduktionen im ersten Monat, indem sie Anfragen an die tatsächliche Nutzung anpassen und inaktive Workloads entfernen.
Wie unterscheidet sich Karpenter vom Cluster Autoscaler?
Karpenter stellt Knoten dynamisch über Tausende von Instanztypen bereit und unterstützt automatisierte Konsolidierung, wodurch Rechenabfall um 15–30% im Vergleich zum statischen Knotengruppen-Ansatz des Cluster Autoscaler reduziert wird.
Sind Spot-Instanzen sicher für Produktions-Kubernetes-Workloads?
Spot-Instanzen sind sicher für zustandslose Workloads, Batch-Jobs und CI/CD-Runner. Zustandsbehaftete Workloads und Datenbanken sollten auf On-Demand-Knoten bleiben, um Unterbrechungen durch Spot-Rückforderungsereignisse zu vermeiden.
Welche Tools bieten Transparenz über Kubernetes-Kosten?
OpenCost und Kubecost sind die führenden Open-Source- und kommerziellen Optionen für die Kostenverteilung auf Namespace-Ebene. Beide integrieren sich mit Prometheus und unterstützen Showback- und Chargeback-Berichte.
Wie reduzieren Labels und Admission Controller Kubernetes-Verschwendung?
Konsistente Labels ermöglichen eine genaue Kostenzuordnung nach Team und Umgebung. Admission Controller wie OPA Gatekeeper oder Kyverno erzwingen die Beschriftung bei der Ressourcenerstellung und verhindern, dass unbeschriftete und unverfolgte Ressourcen sich ansammeln.