Tabellen ersetzen: Ein Migrationsleitfaden für Operationsleiter
Tabellen ersetzen: Ein Migrationsleitfaden für Operationsleiter Der schnellste Weg, Tabellen zu ersetzen, besteht darin, sie nicht länger als führendes System zu behandeln und kritische Daten in eine einzige aktuelle Quelle zu überführen: eine relationale Low-Code-Plattform für moderate Komplexität oder eine maßgeschneiderte interne Anwendung mit PostgreSQL oder SQL Server, wenn mehr auf dem Spiel steht. Beide Wege führen weg von Dateien in E-Mail-Verläufen und hin zu einer Datenbank mit echten Zugriffskontrollen, Audit-Trails und Automatisierung.
Tabellen ersetzen: Ein Migrationsleitfaden für Operationsleiter
Der schnellste Weg, Tabellen zu ersetzen, besteht darin, sie nicht länger als führendes System zu behandeln und kritische Daten in eine einzige aktuelle Quelle zu überführen: eine relationale Low-Code-Plattform für moderate Komplexität oder eine maßgeschneiderte interne Anwendung mit PostgreSQL oder SQL Server, wenn mehr auf dem Spiel steht. Beide Wege führen weg von Dateien in E-Mail-Verläufen und hin zu einer Datenbank mit echten Zugriffskontrollen, Audit-Trails und Automatisierung.
Die Argumente für diesen Schritt liegen auf der Hand. Unternehmen, die Tabellen-Workflows in interne Low-Code-Anwendungen verlagern, berichten von weniger Synchronisationskonflikten, besserer Datenintegrität und Daten, die tatsächlich für KI-gesteuerte Workflows nutzbar sind, da Automatisierung auf strukturierten, relationalen Daten statt auf verstreuten Tabellenblättern beruht. Gartner verfolgt seit Langem, wie Low-Code zur Standardgrundlage für neue Geschäftsanwendungen wird und nicht die Ausnahme bleibt.
Ihr nächster Schritt erfordert keinen sechsmonatigen Projektplan. Er erfordert:
-
Eine Tabelle auszuwählen, deren weitere Beschädigung sich Ihr Team nicht leisten kann
-
Sie als CSV zu exportieren, um zu sehen, wie die Daten tatsächlich aussehen
-
Eine zweistündige Scoping-Sitzung mit Stakeholdern oder einem Team wie Ridiculousengineering zu planen, um zu ermitteln, was ein echter Ersatz erfordern würde
Wichtigste Erkenntnisse
Das Ersetzen von Tabellen durch eine Low-Code-Plattform oder eine maßgeschneiderte interne Anwendung auf einer relationalen Datenbank ist der zuverlässigste Weg, Versionschaos zu beheben, die Auditierbarkeit wiederherzustellen und Daten für die Automatisierung vorzubereiten.
| Punkt | Details |
|---|---|
| Tabellen scheitern strukturell | Flache Dateien bieten keine Beziehungen, erzwungenen Datentypen und keine echten Audit-Trails, sobald mehrere Teams von ihnen abhängen. |
| Eine Kategorie auswählen, keinen Anbieter | Wählen Sie je nach Datenkomplexität zwischen Tabellen-Hybriden, Low-Code-Plattformen, maßgeschneiderten Anwendungen oder gehosteten Datenbanken. |
| Eine sequenzielle Migration durchführen | Bestandsaufnahme, Bereinigung, Modellierung, Migration, Wiederaufbau der Logik, Tests und Einführung in Phasen statt alles auf einmal. |
| Governance bewusst neu aufbauen | Rollenbasierter Zugriff, unveränderliche Audit-Logs und verschlüsselte Backups ersetzen, was Tabellendateien nie hatten. |
| Ridiculousengineering ermittelt den Umfang vor der Entwicklung | Discovery, Schemadesign und ein funktionsfähiger Pilot kommen vor jeder Verpflichtung zu einer vollständigen Migration. |
Inhaltsverzeichnis
-
So ersetzen Sie eine Tabelle: Eine schrittweise Migrations-Checkliste
-
Wie Ridiculous Engineering Ihnen dabei helfen kann, Tabellen hinter sich zu lassen
Warum Tabellen für wachsende Teams nicht mehr skalieren
Tabellen versagen nicht auf einmal. Sie versagen schichtweise, und jede Schicht verschlimmert die nächste.
Versionschaos tritt meist zuerst auf. Jemand verschickt „Budget_FINAL_v3_ACTUAL.xlsx“ per E-Mail, und drei Personen bearbeiten vor dem Mittagessen verschiedene Kopien. Danach folgt der manuelle Abgleich: Jeden Freitagnachmittag vergleicht jemand Tabellenblätter, die eigentlich bereits übereinstimmen sollten. Formeln werden mit zunehmendem Alter fragiler. Eine gelöschte Spaltenreferenz oder eine versehentlich überschriebene Zelle kann ein Modell wochenlang unbemerkt beschädigen.
Dann gibt es das strukturelle Problem. Tabellen sind flache Dateien, die Datenbanken vortäuschen. Sie kennen keine echten Beziehungen zwischen Datensätzen, erzwingen keine Datentypen und können nicht verhindern, dass jemand „N/A“ in eine Spalte eingibt, die ein Datum erwartet. Microsoft Access, das klassische nächsthöhere Werkzeug, ist weiterhin auf 2 GB pro Datenbank und ungefähr 255 gleichzeitige Verbindungen begrenzt. Das wird zu einer echten Obergrenze, sobald ein Team über eine einzelne Abteilung hinauswächst.
Parallel dazu sinkt die Leistung. Sobald eine Arbeitsmappe Zehntausende Zeilen und ein Dutzend querverweisende Tabellenblätter enthält, wird bereits das Öffnen der Datei zur Kaffeepause. Reporting-APIs, die auf Tabellenexporten aufbauen, kommen mit Datensätzen nicht zurecht, für deren Verarbeitung sie nie konzipiert wurden.
Eine einzige falsch eingegebene Formel oder ein überschriebenes Makro kann eine gesamte Reporting-Pipeline tagelang lahmlegen, und niemand bemerkt es, bis ein Kunde fragt, warum seine Lieferung das Lager nie verlassen hat.
Nichts davon bedeutet, dass Tabellen wertlos sind. Für eine einmalige Analyse, einen schnellen Prototyp oder einen persönlichen Notizblock sind sie nach wie vor das richtige Werkzeug. Das Problem beginnt, wenn eine Tabelle zum führenden System wird, auf das mehrere Teams für Entscheidungen, Compliance oder kundenseitige Daten angewiesen sind. Dann ist es Zeit, sie außer Betrieb zu nehmen.
Realistische Ansätze zum Ersetzen von Tabellen
Es gibt keinen einzelnen „Tabellenkiller“. Es gibt fünf Kategorien von Ersatzlösungen, und die richtige Wahl hängt von der Komplexität Ihrer Daten und davon ab, wie viel Entwicklungsaufwand Sie investieren möchten.
Moderne Tabellen-Hybride. Tools wie Google Sheets stehen Tabellen näher als Datenbanken, lösen das Problem des Versionschaos jedoch durch Zusammenarbeit in Echtzeit und eine Änderungshistorie. Für Teams, die schon morgen früh etwas Besseres als E-Mail-Anhänge brauchen, sind sie ein sinnvoller Zwischenschritt, aber kein Ziel.
No-Code- und Low-Code-relationale Plattformen. Airtable, Coda und Baserow setzen eine tabellenähnliche Oberfläche auf eine echte relationale Struktur. Sie erhalten verknüpfte Datensätze, Ansichten und Automatisierung, ohne SQL schreiben zu müssen. Diese Lösungen passen zu Teams, die über flache Dateien hinausgewachsen sind, aber nicht über die Entwicklungskapazitäten für eine vollständig maßgeschneiderte Lösung verfügen. Notion nimmt eine ähnliche Position ein, tendiert jedoch stärker zu Hybriden aus Dokumenten und Datenbanken als zu einer rein relationalen Modellierung.
Maßgeschneiderte interne Anwendungen auf einer echten Datenbank. Wenn Workflows wirklich komplex werden, bieten zweckgebundene Anwendungen auf PostgreSQL oder SQL Server vollständige Kontrolle über Geschäftslogik, Validierung und Integrationen. Dies ist der aufwendigste Weg und führt zum nachhaltigsten Ergebnis. Er ist die richtige Wahl, wenn eine Tabelle Produktionsentscheidungen, Finanzberichte oder etwas mit Compliance-Risiken steuert.
Gehostete Datenbanken plus BI und Reporting. Die Kombination von SQL Server oder PostgreSQL mit Power BI trennt die Zuständigkeiten sauber: Die Datenbank übernimmt Speicherung und Integrität, die BI-Schicht Dashboards und Analysen. Für Finanz- und Betriebsteams, die ein kontrolliertes Reporting benötigen, ohne eine vollständige Anwendung zu entwickeln, ist dies ein häufiges Zielbild.
Automatisierungs- und Orchestrierungsschichten. Zapier und ähnliche Tools ersetzen den Datenspeicher nicht, verbinden Ihr neues System jedoch mit den anderen Tools, die Ihr Team bereits verwendet. Dadurch müssen Daten nicht manuell zwischen Plattformen erneut eingegeben werden.
Das können Sie unabhängig von der Kategorie von jedem soliden Ersatz erwarten:
-
Eine relationale Struktur, die Datentypen und Beziehungen erzwingt, statt der Zellformatierung zu vertrauen
-
Rollenbasierte Zugriffskontrolle bis auf Datensatz- oder Feldebene
-
Automatisierung, die bei Datenänderungen ausgelöst wird, statt darauf angewiesen zu sein, dass jemand an die Aktualisierung eines Tabellenblatts denkt
-
Native Integrationen mit den Tools, die Ihr Team bereits verwendet
-
Ein Audit-Trail, der auch dann bestehen bleibt, wenn jemand das Unternehmen verlässt
Profi-Tipp: Bevor Sie eine Tool-Entscheidung treffen, wählen Sie einen kanonischen Datensatz aus und erfassen Sie zuerst seine Primärschlüssel. Teams, die diesen Schritt überspringen, enden mit drei „Wahrheitsquellen“ statt einer – genau das Problem, das sie eigentlich lösen wollten.
So ersetzen Sie eine Tabelle: Eine schrittweise Migrations-Checkliste
Das Ersetzen einer Tabelle ist kein Wochenendprojekt, muss aber auch keine achtzehnmonatige Initiative sein. Hier ist die Reihenfolge, die funktioniert.
-
Erfassen und bewerten Sie das Risiko jeder relevanten Tabelle. Notieren Sie, wem sie gehört, wer sie verwendet und was nachgelagert ausfallen würde, wenn sie einen Tag lang nicht verfügbar wäre.
-
Erstellen Sie ein Datenprofil und bereinigen Sie die Daten. Suchen Sie vor dem Entwurf nach uneinheitlichen Formaten, doppelten Datensätzen und verwaisten Referenzen. Dieser Schritt dauert fast immer länger als erwartet.
-
Definieren Sie Ihr Schema und Ihre Primärschlüssel. Legen Sie fest, was ein „Datensatz“ tatsächlich ist, bevor Sie entscheiden, welche Software ihn speichern soll.
-
Kümmern Sie sich um Export und Import. Bei flachen Tabellendateien bedeutet dies in der Regel einen unkomplizierten CSV-Massenimport in die neue Plattform. Für Microsoft-Access-Datenbanken konvertiert Microsofts SQL Server Migration Assistant Tabellen, Schlüssel, Indizes und viele Einschränkungen direkt. Formulare, Berichte und VBA-Module werden jedoch nicht automatisch konvertiert und müssen neu erstellt werden.
-
Konvertieren Sie Formeln und Geschäftslogik in Datenbankabfragen oder Anwendungslogik, statt Tabellenformeln unverändert zu übernehmen.
-
Erstellen Sie Zugriffskontrollen und Audit-Logging bevor echte Benutzer das System verwenden, nicht danach.
-
Testen Sie mit tatsächlichen Endbenutzern, nicht nur mit dem Projektteam, und beobachten Sie, wo sie stecken bleiben.
-
Führen Sie die Lösung schrittweise ein, beginnend mit dem Team oder Workflow mit dem geringsten Risiko.
-
Überwachen Sie Nutzung und Datenqualität in den ersten Wochen und beheben Sie auftretende Probleme schnell.
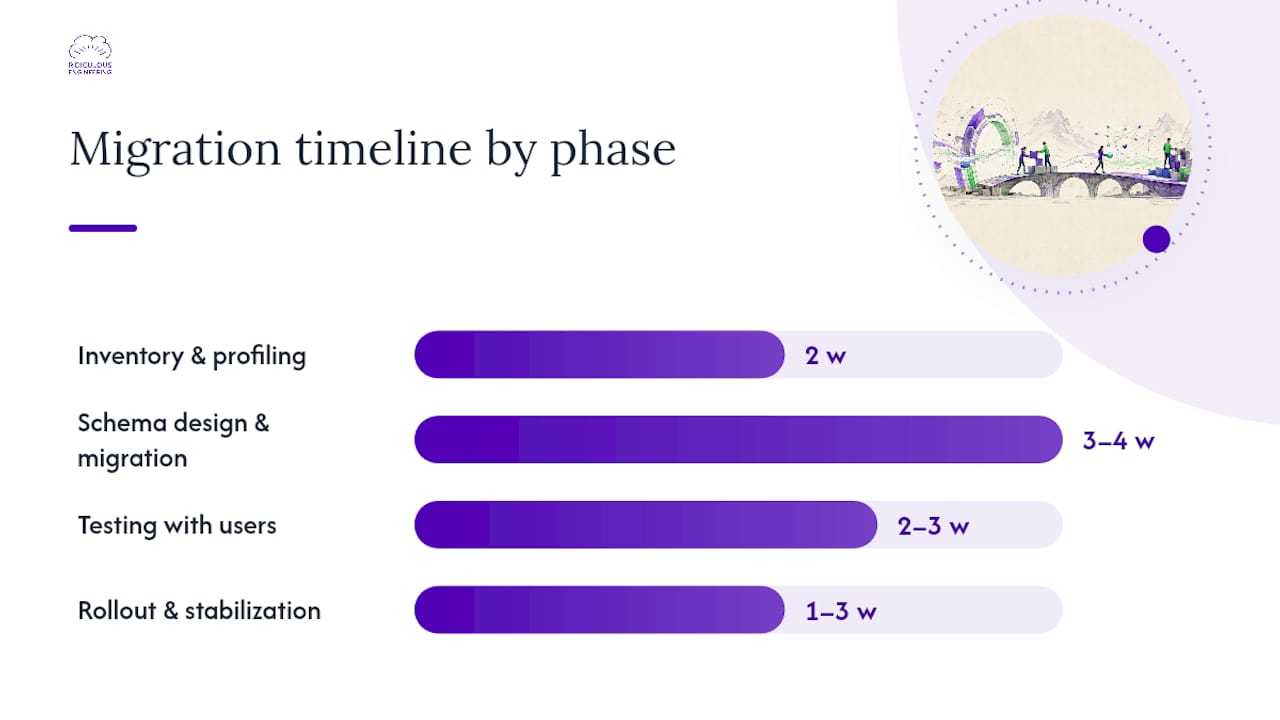
Eine realistische Zeitplanung für eine Migration mittlerer Komplexität umfasst etwa 8 bis 12 Wochen: zwei Wochen für Bestandsaufnahme und Datenprofiling, drei bis vier Wochen für Schemadesign und Migration, zwei bis drei Wochen für Tests und die verbleibende Zeit für schrittweise Einführung und Stabilisierung. Benennen Sie einen fachlich Verantwortlichen, der den Workflow versteht, einen Data Steward für die Datenqualität, einen Entwickler für die Umsetzung, einen QA-Leiter und eine Person, die für die Kommunikation der Einführung verantwortlich ist.
Ordnen Sie in jeder Phase das passende Tool der jeweiligen Aufgabe zu: Datenprofiler für die Bestandsaufnahme, ETL- oder Massenladeprogramme für die Migration, Low-Code-App-Builder oder individuelle Entwicklung für die Oberfläche und BI-Tools für das Reporting. Wenn Access beteiligt ist, übernimmt SSMA den Schema- und Datenkonvertierung, erfordert jedoch bestimmte SQL-Server-Rollenmitgliedschaften und jemanden, der weiß, was „db_ddladmin“ bedeutet. In der Regel ist dies der Punkt, an dem sich ein spezialisierter Engineering-Partner bezahlt macht.
Profi-Tipp: Erstellen Sie vor Beginn jeder Migration mit Schreibzugriff ein unveränderliches Backup jeder Quellentabelle oder -datenbank. „Unveränderlich“ bedeutet, dass niemand – auch Sie nicht – sie bearbeiten kann. Sie werden sich beim ersten Mapping-Fehler, der eine Tabelle beschädigt, dafür danken.
Governance, Sicherheit und die fehlende Auditierbarkeit
Tabellen erzeugen Governance-Lücken, die die meisten Teams erst bemerken, wenn ein Audit oder eine Sicherheitsprüfung sie zum Handeln zwingt. Berechtigungen auf Dateiebene sind ganz oder gar nicht: Jemand kann die Datei entweder öffnen oder nicht. Es gibt keine Möglichkeit, einem Finanzanalysten die Bearbeitung von Umsatzzahlen zu erlauben und gleichzeitig den Zugriff auf Gehaltsdaten in derselben Arbeitsmappe zu sperren. Außer „Änderungen nachverfolgen“, das jeder deaktivieren kann, gibt es keinen echten Audit-Trail. Und Backups bestehen meistens aus dem, was letzten Dienstag im Download-Ordner einer Person gelandet ist.
Echte Governance wiederherzustellen bedeutet, diese Kontrollen bewusst neu aufzubauen:
-
Rollenbasierte Zugriffskontrolle, die Berechtigungen nach Datensatz, Feld oder Workflow-Phase begrenzt
-
Unveränderliche Audit-Logs, die festhalten, wer was wann geändert hat, ohne Möglichkeit, sie zu deaktivieren
-
Multi-Faktor-Authentifizierung für jedes Konto mit Schreibzugriff
-
Verschlüsselung ruhender und übertragener Daten für alle Inhalte mit Finanz- oder personenbezogenen Daten
-
Automatisierte Backups mit einer definierten Aufbewahrungsrichtlinie statt eines Ordners mit manuellen Exporten
-
Servicekonten mit minimalen Berechtigungen für jede Automatisierung, die auf die Datenbank zugreift
Einige Plattformen zeigen bereits, wie das in der Praxis aussieht. Kollaborative Dokumenttools mit Unterstützung für Berechtigungen auf Abschnittsebene ermöglichen es einem Eigentümer, Bearbeitungszugriff auf einen Abschnitt eines Dokuments zu gewähren und andere auf Nur-Lesen zu beschränken. Das ist dasselbe Prinzip, das eine Datenbank auf Tabellen- oder Zeilenebene über Rollenmitgliedschaften und eine zentrale Identitätsverwaltung anwendet. Vergleichen Sie dies mit einer Tabellendatei, die überhaupt kein Konzept für einen „Abschnitt“ kennt, sondern nur ein ganzes Dokument, das entweder freigegeben ist oder nicht.
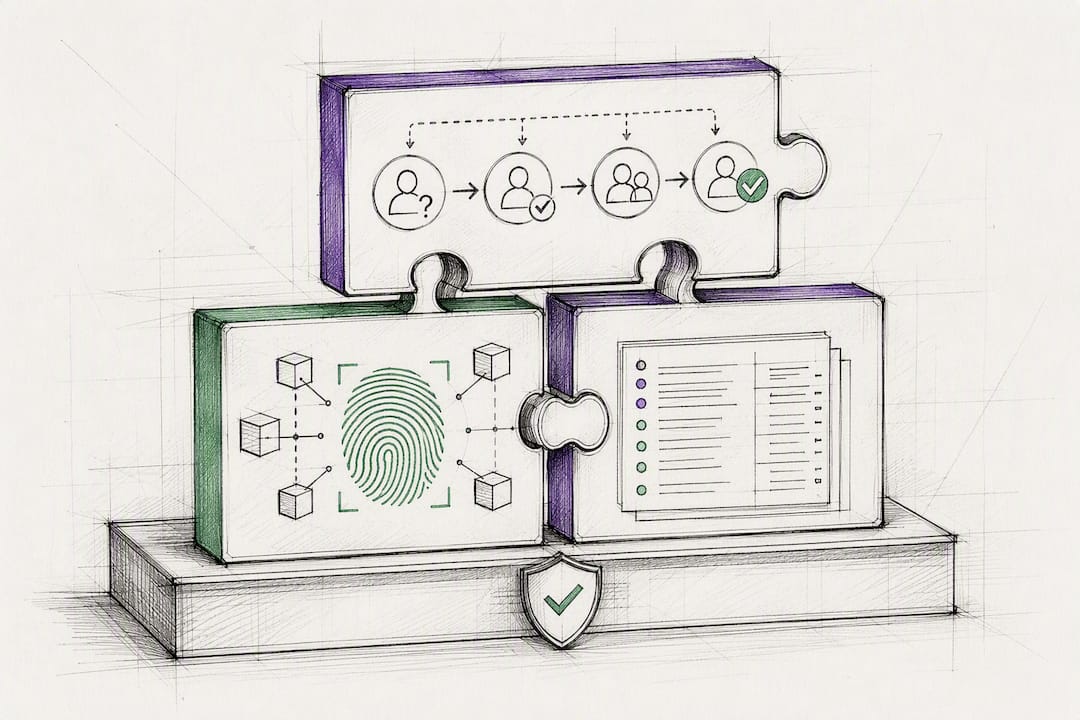
Wenn eine vollständige Migration nicht sofort umsetzbar ist, kann eine direkt zu Tabellen hinzugefügte Governance-Schicht Zeit verschaffen. Genehmigungs-Workflows, Versionsfingerabdrücke und zentrale Änderungsprotokolle können ein reguliertes Modell ohne Neuaufbau auditierbar machen. Das ist für Teams unter Compliance-Druck wichtig, die nicht ein ganzes Quartal auf ein neues System warten können. Migrationen, die Daten vollständig zentralisieren, beseitigen jedoch tendenziell einen größeren Teil des manuellen Abgleichs als Governance-Schichten allein.
Profi-Tipp: Testen Sie Ihr Berechtigungsmodell vor der Migration eines einzigen Produktions-Workflows zunächst mit einem kleinen, unkritischen Datensatz. Beobachten Sie, was ein normaler Benutzer sehen, bearbeiten und exportieren kann, und prüfen Sie anschließend, ob das Audit-Log dies tatsächlich erfasst. Eine Berechtigungslücke bei zehn Testdatensätzen zu beheben, ist günstig. Nach dem Go-live ist es das nicht.
So wählen Sie den richtigen Ersatz für Ihr Team
Richten Sie die Lösung an Ihren tatsächlichen Einschränkungen aus, nicht an der Lösung, die die letzte Anbieterdemo am einfachsten erscheinen ließ.
-
Bewerten Sie Ihre Größenordnung. Ein einzelnes Team, das den Bestand verfolgt, benötigt weniger als ein Unternehmen, das die Finanzen über fünf Abteilungen hinweg betreibt.
-
Erfassen Sie die Komplexität Ihres Datenmodells. Flache Daten in einer einzigen Tabelle passen zu einer Low-Code-Plattform. Daten mit echten Beziehungen (Kunden zu Bestellungen zu Lieferungen) benötigen eine relationale Datenbank.
-
Prüfen Sie Ihre regulatorischen Anforderungen. Alles, was Finanzberichte, Gesundheitsdaten oder personenbezogene Informationen berührt, benötigt von Anfang an Auditierbarkeit und darf nicht erst später nachgerüstet werden.
-
Zählen Sie Ihre Wartungskapazitäten. Eine maßgeschneiderte Anwendung ohne jemanden, der sie wartet, wird zur Legacy-Tabelle von morgen.
-
Bestätigen Sie die Integrationsanforderungen. Wenn Sie eine Verbindung zu fünf anderen Systemen benötigen, wägen Sie dies gegen die Unterstützung nativer Konnektoren der jeweiligen Plattform ab.
Drei schnelle Szenarien: Ein kleines Betriebsteam, das Lieferantenverträge verfolgt, ist mit einem modernen Tabellen-Hybriden oder einer schlanken No-Code-Plattform gut bedient und kann oft innerhalb weniger Tage starten. Ein Team mit echten relationalen Anforderungen, etwa der projektübergreifenden Nachverfolgung von Kunden und Liefergegenständen, passt zu einer relationalen Low-Code-Plattform, die typischerweise innerhalb weniger Wochen produktiv ist. Ein produktionskritisches Finanzmodell mit umfangreichen nachgelagerten Integrationen gehört auf eine maßgeschneiderte interne Anwendung auf SQL Server oder PostgreSQL. Das dauert länger, zahlt sich aber durch Kontrolle und Nachhaltigkeit aus.
Ein Engineering-First-Ansatz zum Ersetzen von Tabellen
Ridiculousengineering geht das Ersetzen von Tabellen so an, wie es jedes solide Engineering-Team tun sollte: zuerst den Umfang bestimmen, klein entwickeln, den Ansatz beweisen und anschließend skalieren.
Ein typisches Engagement sieht so aus:
-
Discovery. Wir setzen uns mit den Personen zusammen, die die Tabelle tatsächlich täglich verwenden, nicht nur mit der Führungskraft, die das Projekt angefordert hat, und erfassen, was die Daten wirklich leisten müssen.
-
Schemadesign. Wir definieren die relationale Struktur und das Zugriffsmodell, bevor wir eine einzige Zeile Anwendungscode schreiben.
-
Prototyp. Ein funktionsfähiger Pilot mit echten (oder realistischen) Daten wird früh den Benutzern vorgelegt, damit Probleme sichtbar werden, bevor das gesamte System auf einer falschen Annahme aufbaut.
-
Migration. Die Daten werden mit Validierungsprüfungen bei jedem Schritt übertragen und nicht in einem einzigen großen Massenimport, den niemand überprüft.
-
Qualitätssicherung. Tatsächliche Endbenutzer testen das System bei ihrer tatsächlichen Arbeit und nicht in einer vorgeführten Demo.
-
Einführung und Überwachung. Wir führen den Start phasenweise durch und beobachten Datenqualität und Nutzung in den ersten Wochen genau.
Ein typischer Zeitplan umfasst zwei Wochen für Discovery, weitere vier Wochen für Prototyp und Migration sowie sechs bis zwölf Wochen für Einführung und Stabilisierung – abhängig vom Umfang. Kunden sollten messbare Ergebnisse erwarten: weniger Zeit für den manuellen Abgleich von Zahlen, weniger manuelle Änderungen, die nachgelagerte Fehler verursachen, schnellere Reporting-Zyklen und einen Audit-Trail, der einer Prüfung tatsächlich standhält. Jedes Engagement umfasst eine transparente Umfangsdefinition zu Beginn und Wissenstransfer am Ende, damit das System nach Abschluss des Projekts nicht zu einer Blackbox wird.
Wie Ridiculous Engineering Ihnen helfen kann, Tabellen hinter sich zu lassen
Wenn Sie bis hierhin gelesen haben, wissen Sie bereits, dass es beim Ersetzen einer Tabelle nicht um den Kauf von Software geht. Es geht darum, das Datenmodell richtig zu gestalten, echte Zugriffskontrollen aufzubauen und sicherzustellen, dass die Personen, die das System täglich verwenden, ihm tatsächlich vertrauen.
Ridiculousengineering führt vor jeder Verpflichtung zu einer vollständigen Entwicklung einen unverbindlichen Discovery-Prozess durch: eine Scoping-Sitzung, einen Blick auf Ihre tatsächlichen Daten und eine klare Antwort darauf, ob eine Low-Code-Plattform oder eine maßgeschneiderte interne Anwendung besser geeignet ist. Sie erhalten einen Migrationsplan, eine grobe Kostenschätzung und in vielen Fällen eine funktionsfähige Pilotanwendung – nicht nur eine Präsentation. Anschließend erwarten Sie technisches Scoping, praktisches Datenprofiling und ein Lieferplan mit echten Meilensteinen statt vager Versprechen über „Modernisierung“.
Wenn eine Tabelle derzeit einen Teil Ihres Geschäfts betreibt, den Sie nicht länger ständig nachbessern können, beginnen Sie mit unserem Team ein Gespräch über maßgeschneiderte Softwareentwicklung und erhalten Sie einen konkreten Umfang und Zeitplan statt eines weiteren Verkaufsgesprächs.
Quellen
Einige Ressourcen sollten Sie mit einem Lesezeichen versehen, bevor Sie mit dem Scoping Ihrer eigenen Migration beginnen:
-
Verbindung mit SQL Server (AccessToSQL) – SQL Server | Microsoft Learn
-
Wie Unternehmen Tabellen durch interne Low-Code-Anwendungen in 2026 ersetzen
FAQ
Welche guten Alternativen zu Excel gibt es für Tabellen?
Airtable, Coda, Baserow und Notion bieten tabellenähnliche Oberflächen auf relationaler Struktur, während Google Sheets als kollaborativer Zwischenschritt funktioniert. Für produktionskritische Daten bietet die Kombination von PostgreSQL oder SQL Server mit Power BI eine kontrollierte Datenbank- und Reporting-Schicht statt einer flachen Datei.
Wie ersetze ich eine Tabelle?
Beginnen Sie mit der Erfassung von Risiko und Nutzung der Tabelle und profilieren und bereinigen Sie anschließend die Daten, bevor Sie ein Schema mit eindeutigen Primärschlüsseln definieren. Migrieren Sie die Daten, bauen Sie Formeln als Datenbanklogik oder Anwendungscode neu auf, testen Sie mit echten Benutzern und führen Sie die Lösung schrittweise ein. Bewahren Sie dabei ein unveränderliches Backup der Originaldatei auf.
Was wird Excel ersetzen?
Kein einzelnes Tool ersetzt Excel für jeden Anwendungsfall. Die meisten Organisationen verlagern kritische Workflows auf eine Kombination aus relationalen Low-Code-Plattformen, maßgeschneiderten internen Anwendungen auf SQL Server oder PostgreSQL und BI-Tools wie Power BI, während sie Excel oder Google Sheets für schnelle, unkritische Analysen beibehalten.
Gibt es eine kostenlose Version von Excel-Tabellen?
Ja. LibreOffice Calc bietet eine kostenlose Open-Source-Tabellenoberfläche, und Google Sheets ist für Einzelpersonen und kleine Teams kostenlos. Keine der beiden Lösungen bietet die relationale Struktur, unternehmensweiten Zugriffskontrollen oder Audit-Trails, die erforderlich sind, sobald mehrere Teams von einer Tabelle abhängen.