Gestión de la calidad de los datos: guía práctica para 2026
Gestión de la calidad de los datos: guía práctica para 2026. La gestión de la calidad de los datos (DQM) es el conjunto de prácticas, reglas y controles operativos que mantienen tus datos precisos, completos, coherentes y aptos para el análisis y la IA.
Gestión de la calidad de los datos: guía práctica para 2026
La gestión de la calidad de los datos (DQM) es el conjunto de prácticas, reglas y controles operativos que mantienen tus datos precisos, completos, coherentes y aptos para el análisis y la IA. No es un proyecto de limpieza puntual. Es un programa operativo continuo, y las organizaciones que lo tratan como algo menos suelen descubrir la brecha cuando un modelo falla o un panel ejecutivo se contradice durante una reunión del consejo.
Lo más útil que puedes hacer a corto plazo es perfilar tus conjuntos de datos más críticos e implementar varias reglas automatizadas que cubran el formato, la completitud y la unicidad. Este alcance limitado puede lograrse en aproximadamente un mes y genera las pruebas que necesitas para financiar un programa más amplio.
Qué hacer ahora mismo:
-
Identifica los conjuntos de datos de los que más dependen tus canalizaciones de análisis e IA (empieza por los datos de clientes, productos o transacciones).
-
Ejecuta un perfilado para establecer las líneas base de completitud y las tasas de duplicados.
-
Implementa tres reglas automatizadas: una comprobación de formato o expresión regular, una comprobación de valores nulos o en blanco y una comprobación de unicidad en las claves principales.
-
Asigna un propietario de datos identificado a cada conjunto de datos antes de escribir una sola regla.
Consejo profesional: Empieza por el conjunto de datos que alimenta tu informe más utilizado o tu modelo de mayor riesgo. Mejorar su calidad produce rápidamente un impacto empresarial visible, justo lo que necesitas para conseguir presupuesto para el resto del programa.
Conclusiones clave
La gestión eficaz de la calidad de los datos es un programa operativo, no un proyecto. Requiere propietarios identificados, reglas automatizadas e indicadores clave de rendimiento vinculados a los resultados empresariales para mantener los resultados a lo largo del tiempo.
| Punto | Detalles |
|---|---|
| Empezar con el perfilado | Primero, perfila tus cinco conjuntos de datos principales para establecer las líneas base de completitud, unicidad y validez antes de escribir reglas. |
| Automatizar inmediatamente tres reglas | Implementa comprobaciones de formato, valores nulos o en blanco y unicidad en tu canalización existente en un plazo de 30 días para lograr un impacto rápido y visible. |
| Asignar la propiedad antes que las reglas | Cada conjunto de datos necesita un propietario de datos identificado; una regla sin propietario es una alerta sin nadie que la atienda. |
| Vincular las métricas a los resultados empresariales | Realiza un seguimiento de la adopción de conjuntos de datos certificados, el MTTD y el MTTR junto con las puntuaciones de completitud para mantener el apoyo de la dirección. |
| Ridiculous Engineering | Ridiculous Engineering ofrece proyectos piloto de DQM con un alcance definido en un plazo de 30 a 90 días, desde el perfilado y el diseño de reglas hasta la entrega del conjunto de datos certificado. |
Índice de contenidos
-
Dónde aplicar comprobaciones a lo largo del ciclo de vida de los datos
-
Qué métricas e indicadores clave demuestran realmente el valor de la DQM
-
Ridiculous Engineering crea programas de DQM que realmente funcionan en producción
Qué abarca realmente la gestión de la calidad de los datos
La gestión de la calidad de los datos abarca todo el ciclo de vida de los datos: desde el momento en que entran en tus sistemas durante la ingesta, pasando por la transformación y el enriquecimiento, hasta las capas de datos maestros y analítica, y finalmente su archivado o eliminación. Combina la elaboración de perfiles (medir lo que tienes), las reglas (definir cómo es algo «correcto»), la remediación (corregir lo que falla) y la monitorización (detectar cambios con el tiempo). El objetivo es que los datos sean adecuados para su propósito, no alcanzar una perfección abstracta.
Donde los equipos suelen confundirse es en la coincidencia con disciplinas relacionadas. La siguiente tabla aclara las diferencias.
| Disciplina | Enfoque principal | Resultados clave | Responsable habitual |
|---|---|---|---|
| Gestión de la calidad de los datos | Exactitud, completitud, coherencia y adecuación al propósito de los valores de los datos | Reglas, perfiles, flujos de trabajo de remediación y conjuntos de datos certificados | Responsables de datos e ingenieros de datos |
| Gobernanza de datos | Políticas, propiedad, responsabilidad y cumplimiento en todos los activos de datos | Políticas, roles, catálogo de datos y documentación del linaje | Director de Datos y consejo de gobernanza |
| Gestión de datos maestros | Registro único y autorizado de las entidades principales (cliente, producto, ubicación) | Registros maestros, resolución de entidades y plataforma de gestión de datos maestros | Equipo de la plataforma de gestión de datos maestros y propietarios de los datos |
| Limpieza de datos ad hoc | Corrección puntual de un conjunto de datos específico | Archivo o tabla depurados | Analista o ingeniero bajo demanda |
La gestión de la calidad de los datos es la capa operativa que hace realidad la política de gobernanza. La gobernanza te indica cuáles deberían ser las reglas; la gestión de la calidad de los datos es la maquinaria que las hace cumplir, mide el cumplimiento y dirige las excepciones a las personas adecuadas. La gestión de datos maestros depende de la gestión de la calidad de los datos para mantener la fiabilidad de los registros maestros a lo largo del tiempo.
En el caso concreto de la analítica y la IA, la gestión de la calidad de los datos añade dos aspectos que la gestión de datos tradicional suele pasar por alto: un linaje auditable (para poder rastrear los datos de entrenamiento de un modelo hasta su origen) y la detección de cambios (para detectar cuándo los datos de producción se desvían de la distribución con la que se entrenó el modelo). La guía de TechTarget presenta la integración de la gobernanza como el mecanismo que vincula los roles, los metadatos, el linaje y las métricas de calidad en un sistema coherente, en lugar de tratarlos como una colección de herramientas desconectadas.
La responsabilidad suele distribuirse entre cuatro roles: propietarios de los datos (responsables de un dominio), responsables de los datos (responsables de las decisiones cotidianas sobre la calidad), ingenieros de datos (que crean y mantienen las canalizaciones y la infraestructura de reglas) e ingenieros de control de calidad o de analítica (que validan los resultados antes de que lleguen a los consumidores).
Las dimensiones fundamentales que debes medir
Todo programa de DQM se asigna a un conjunto de dimensiones. No son categorías teóricas; cada una corresponde a una clase de fallos que causa un perjuicio empresarial real.
| Dimensión | Impacto empresarial si se incumple | Comprobación o métrica sencilla |
|---|---|---|
| Exactitud | Decisiones erróneas, exposición normativa | Auditoría de muestra: % de registros que coinciden con la fuente autorizada |
| Completitud | Los campos que faltan rompen los modelos y los informes | % de completitud = (valores no nulos / total de valores esperados) × 100 |
| Coherencia | Los valores contradictorios entre sistemas erosionan la confianza | Tasa de coincidencia entre sistemas en claves compartidas |
| Puntualidad / actualidad | Los datos obsoletos producen información desactualizada | Antigüedad del registro frente al umbral del SLA (p. ej., actualizado en las últimas 24 horas) |
| Unicidad | Los registros duplicados inflan los recuentos y distorsionan los análisis | Tasa de duplicados = (filas duplicadas / total de filas) × 100 |
| Validez / conformidad | Los formatos no válidos impiden el procesamiento posterior | % de valores que coinciden con el formato o la enumeración definidos |
| Integridad / linaje | Las relaciones rotas corrompen las combinaciones y las agregaciones | Comprobación de integridad referencial: claves foráneas huérfanas / total de claves foráneas |
| Relevancia | Los datos irrelevantes aumentan el coste de almacenamiento y el ruido | % de campos utilizados activamente por los consumidores posteriores |
La exactitud y la completitud suelen ser lo más importante para los análisis estructurados.
En el caso de las cargas de trabajo de IA y ML, la Guía de gestión de la calidad de los datos de AISI recomienda tratar la calidad de las anotaciones, la detección de sesgos, el control de versiones y la supervisión de la deriva como comprobaciones independientes que se añaden a las dimensiones canónicas, en lugar de integrarlas en ellas. La calidad de las anotaciones constituye su propio modo de fallo: una etiqueta que técnicamente está «completa» aún puede ser sistemáticamente incorrecta. La supervisión de la deriva corresponde a la capa de servicio del modelo, no solo a la ingesta. Conviene añadir estos aspectos al inventario de dimensiones si está creando o manteniendo modelos de ML. Para obtener más información sobre la relación entre la calidad de los datos y la fiabilidad de la IA, la publicación Ridiculous Engineering sobre IA y calidad de los datos explica en profundidad sus implicaciones prácticas.
Capacidades esenciales que debe tener su programa de DQM
Un programa de DQM solo es tan sólido como la infraestructura operativa que lo respalda. Las siguientes capacidades constituyen el conjunto mínimo viable para un programa de nivel de producción.
La elaboración de perfiles es la base. Antes de escribir una regla, necesita saber qué aspecto tienen realmente sus datos: tasas de nulos, distribuciones de valores, cardinalidad y patrones de formato. Las herramientas de elaboración de perfiles generan esta línea base automáticamente y ponen de manifiesto anomalías que no encontraría examinando una muestra a simple vista.
Un motor de reglas es donde la política se convierte en aplicación efectiva. La documentación de Microsoft Purview describe un modelo práctico de tres partes para las reglas personalizadas: una expresión de fila (la comprobación principal), una expresión de filtro (a qué filas se aplica la regla) y una expresión de nulos (cómo gestionar los valores que faltan). Esta estructura aborda los casos extremos que las comprobaciones sencillas con expresiones regulares no detectan. Tipos de reglas que necesita como mínimo: coincidencia de expresiones regulares o formatos, validación del tipo de datos, detección de valores nulos o en blanco, comprobaciones de unicidad, validación mediante consulta de tabla frente a datos de referencia y expresiones de fila personalizadas para la lógica empresarial.
Coincidencia y deduplicación resuelven la dimensión de unicidad a escala. La deduplicación mediante coincidencia exacta aborda los casos sencillos; la coincidencia probabilística (nombres aproximados, normalización de direcciones) es necesaria para los datos de clientes y proveedores, cuyos registros proceden de múltiples fuentes con formatos incoherentes.
Los flujos de trabajo de remediación cierran el ciclo. Tres patrones cubren la mayoría de las situaciones: corrección automatizada (segura para arreglos deterministas, como la normalización del formato de fecha), cuarentena provisional (retener el registro, marcarlo e impedir que llegue a los consumidores posteriores hasta que se revise) y flujos de trabajo de responsables mediante tickets (dirigir la excepción a un responsable identificado, con contexto y una fecha límite). La corrección automatizada es rápida, pero arriesgada si la lógica de corrección es incorrecta. La cuarentena es la opción predeterminada más segura para los casos ambiguos.
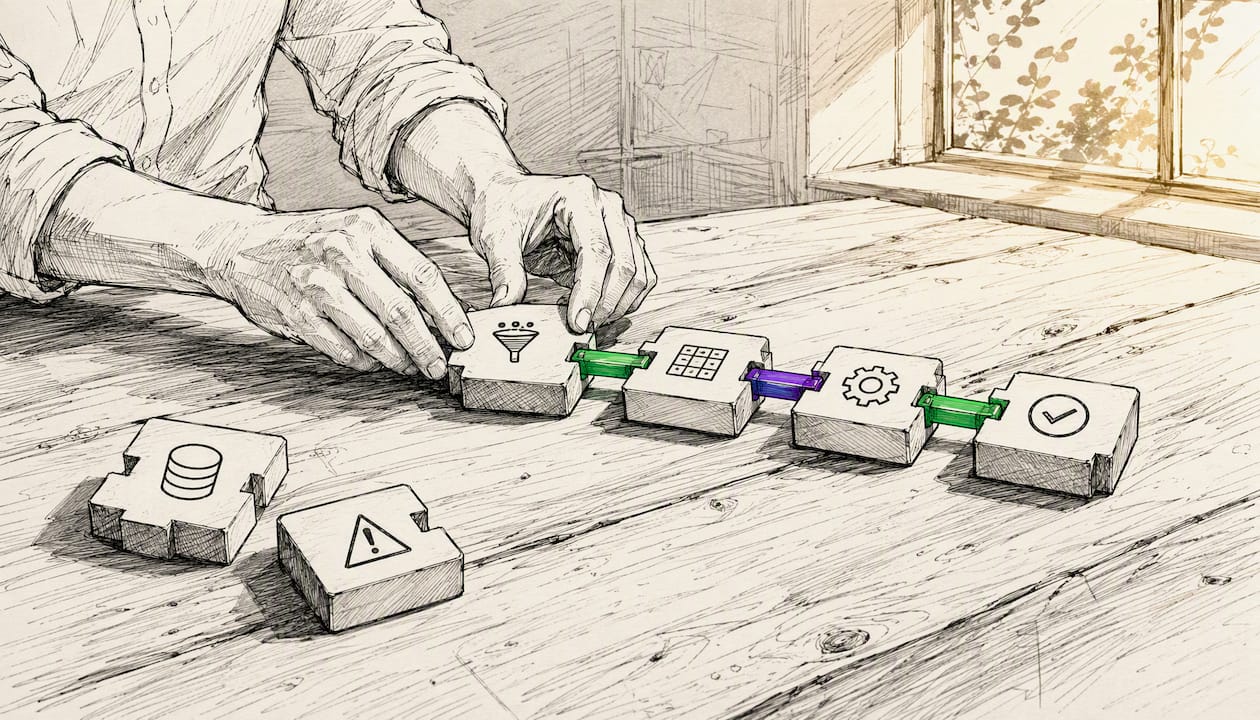
El linaje y la observabilidad permiten responder a la pregunta que todo auditor e ingeniero de modelos acaba haciendo: ¿de dónde proceden estos datos y qué les ha ocurrido? Sin linaje, no se puede certificar un conjunto de datos para el entrenamiento de modelos ni para la elaboración de informes regulatorios.
Consejo profesional: Prioriza las reglas según su impacto posterior, no según la facilidad de implementación. Asocia cada regla propuesta con la canalización o el informe que protege y, a continuación, ordénalas por importancia empresarial.
Cómo crear un programa eficaz de gestión de la calidad de los datos
Crear una capacidad de gestión de la calidad de los datos es un esfuerzo por fases. Intentar gobernarlo todo a la vez es la forma más habitual de acabar sin gobernar nada.
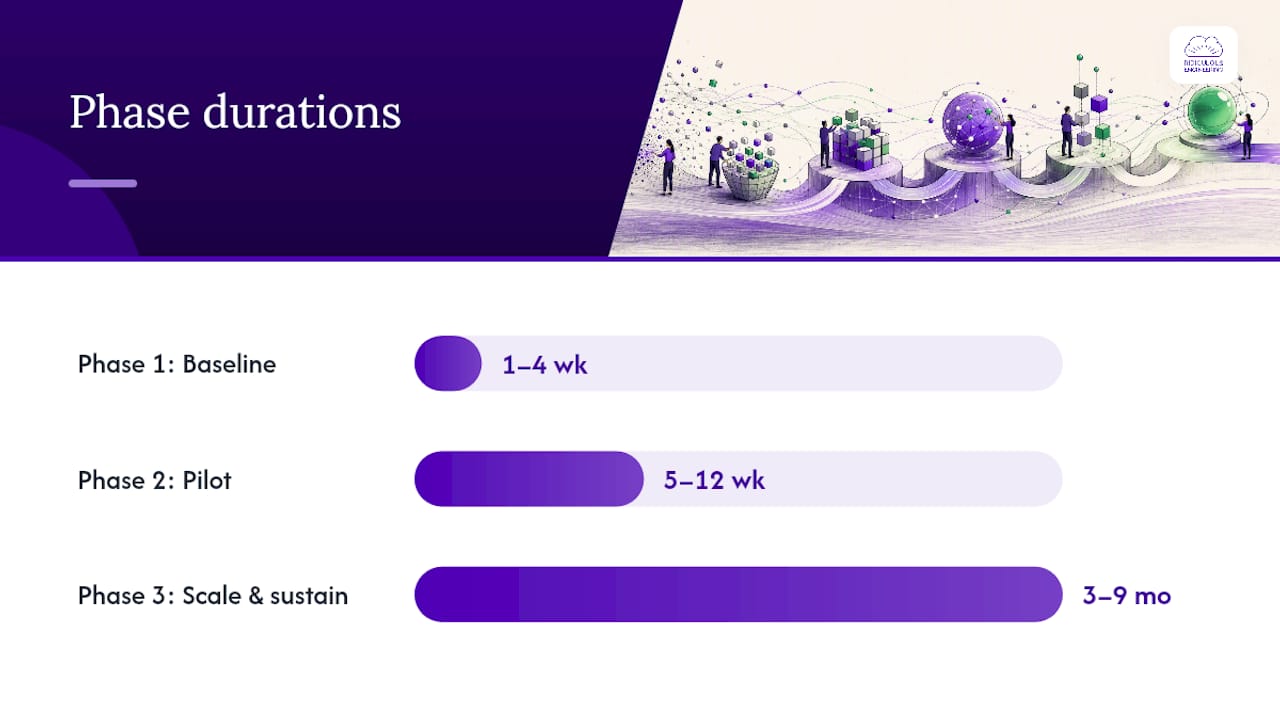
Fase 1: Establecimiento de la línea base y alcance (semanas 1-4)
-
Realiza una evaluación de madurez: documenta la cobertura actual de la elaboración de perfiles, las reglas existentes, las carencias de responsabilidades y los incidentes de calidad conocidos.
-
Identifica los elementos de datos críticos (CDE): los campos y conjuntos de datos que afectan directamente a los ingresos, al cumplimiento normativo o al rendimiento de los modelos.
-
Elabora perfiles de los CDE para establecer métricas de referencia de completitud, unicidad y validez.
-
Define los SLA: qué significa «suficientemente bueno» para cada dimensión en cada conjunto de datos.
Fase 2: Piloto (semanas 5-12)
-
Diseña e implementa un conjunto de reglas para un dominio de alta prioridad (los datos de clientes son un punto de partida habitual).
-
Implementa flujos de trabajo de remediación: como mínimo, una cola de cuarentena y un proceso de notificación a los responsables de los datos.
-
Automatiza la ejecución de las reglas en tu proceso ETL o plataforma de datos.
-
Publica un panel de KPI sencillo que muestre las puntuaciones de calidad de referencia frente a las actuales.
Fase 3: Escalado y sostenibilidad (meses 3-9)
-
Amplía la cobertura de reglas a dominios adicionales según la prioridad de los CDE.
-
Integra las comprobaciones de calidad en las canalizaciones de CI/CD de los activos de datos.
-
Establece un catálogo de conjuntos de datos certificados: una lista gobernada de conjuntos de datos que han superado los umbrales de calidad definidos y están aprobados para análisis y uso en modelos.
-
Realiza revisiones trimestrales de gestión frente a los KPI de calidad, según recomienda el marco DAMA-NL DQMS.
Funciones y responsabilidades:
-
Patrocinador ejecutivo: aprueba el alcance, el presupuesto y la vía de escalado; revisa los KPI trimestralmente.
-
Responsables de los datos: son responsables de los resultados de calidad en su dominio y aprueban los cambios en las reglas.
-
Responsables de la gestión de datos: resuelven excepciones, mantienen los datos de referencia y gestionan las colas de remediación.
-
Ingenieros de datos: crean y mantienen la infraestructura de reglas, las canalizaciones y la supervisión.
-
Ingenieros de QA y analítica: validan los resultados antes de promoverlos al estado de certificados.
Los tres escollos que descarrilan la mayoría de los programas: gobernar en exceso (redactar cientos de reglas antes de hacer cumplir ninguna), la falta de responsables (las reglas sin un responsable asignado se convierten en alertas huérfanas) e ignorar a los consumidores posteriores (crear reglas que satisfacen al equipo de datos, pero no a los analistas o ingenieros de modelos que realmente utilizan los datos). Gartner recomienda que combina perfilado, supervisión, administración y gobernanza, vinculando al mismo tiempo las mejoras de calidad con resultados empresariales medibles; esta última parte es la que mantiene la financiación del programa más allá del primer trimestre.
Consejo profesional: Ejecuta el piloto sobre el conjunto de datos que alimenta el informe que consulta semanalmente la parte interesada de mayor rango. Cuando mejoren las puntuaciones de calidad y el informe deje de contradecirse, tendrás un caso que financiará la siguiente fase sin necesidad de un extenso caso de negocio.
Dónde aplicar comprobaciones a lo largo del ciclo de vida de los datos
Las comprobaciones de calidad deben realizarse en varios puntos del ciclo de vida de los datos, no solo al final. Cuanto más avance un registro defectuoso hacia las etapas posteriores, más caro será corregirlo.
| Etapa del ciclo de vida | Comprobaciones recomendadas | Prevención o detección |
|---|---|---|
| Diseño / recopilación | Definición del esquema, restricciones de enumeración, aplicación de campos obligatorios en el origen | Prevención |
| Ingesta (API, archivo, flujo) | Validación del esquema, comprobaciones de formato, detección de nulos, integridad referencial | Prevención |
| Transformación (ETL/ELT) | Completitud, unicidad, coherencia entre tablas, validación de reglas de negocio | Detección |
| Capa de datos maestros / MDM | Deduplicación, resolución de entidades, certificación del registro maestro | Prevención + detección |
| Analítica / entrenamiento de modelos | Coherencia de etiquetas, comprobaciones de sesgo, deriva de la distribución, control de versiones | Detección |
| Servicio / consumo | Comprobaciones de puntualidad del SLA, validación de indicadores de conjuntos de datos certificados | Detección |
| Archivado | Auditoría de completitud, instantánea del linaje | Detección |
Las comprobaciones de prevención en el origen son más económicas por defecto detectado, pero requieren coordinación con los responsables de los sistemas ascendentes, que a menudo constituye el problema organizativo más difícil. Las comprobaciones de detección posteriores a la ingesta son más fáciles de implementar unilateralmente, pero permiten que los datos defectuosos sigan avanzando antes de detectarlos.
Un ejemplo práctico de canalización: para una ingesta mediante API que alimenta un modelo de analítica de clientes, aplica comprobaciones de esquema y formato en la puerta de enlace de la API (prevención), comprobaciones de completitud y unicidad en la capa ETL (detección), y comprobaciones de coherencia de etiquetas y deriva en la canalización de entrenamiento del modelo (detección). La guía de AISI recomienda específicamente el control de versiones y la supervisión de la deriva como comprobaciones propias de la etapa de entrenamiento del modelo, no solo de la ingesta. La publicación Ridiculous Engineering sobre canalizaciones de datos operativas explica cómo se aplican estos patrones en entornos de producción.
Qué métricas y KPI demuestran realmente el valor de la GDC
Las métricas de calidad solo mantienen el respaldo de los directivos cuando se conectan con resultados que la empresa ya supervisa.
Métricas principales que se deben seguir:
-
Puntuación de completitud: (valores no nulos / valores totales esperados) × 100, por conjunto de datos y por CDE.
-
Tasa de duplicados: (filas duplicadas / filas totales) × 100; el objetivo varía según el dominio, pero menos del 1 % es un SLA inicial razonable para los datos maestros de clientes.
-
Tasa de precisión: % de registros muestreados que coinciden con una fuente autorizada; para la mayoría de los programas, es suficiente muestrear entre 200 y 500 registros por conjunto de datos cada trimestre.
-
Cumplimiento del SLA de puntualidad: % de registros actualizados dentro de la ventana de vigencia definida.
-
Adopción de conjuntos de datos certificados: % de las cargas de trabajo de análisis y modelos que consumen datos del catálogo certificado frente a fuentes no certificadas.
-
Tiempo medio de detección (MTTD): tiempo medio desde que se produce un problema de calidad hasta que la monitorización lo señala.
-
Tiempo medio de resolución (MTTR): tiempo medio desde la detección hasta la resolución; un flujo de trabajo de administración con responsabilidades claras suele reducir el MTTR más que la automatización por sí sola.
Según el manual de gobernanza de InfiniSynapse, los programas prácticos miden la adopción y los resultados, no los recuentos de actividad. Métricas como el uso de conjuntos de datos certificados, la reducción de conflictos entre informes y el tiempo necesario para realizar una auditoría son las que resultan relevantes para los responsables de finanzas y operaciones.
Una fila sencilla de un panel de KPI se ve así: nombre de la métrica, valor actual, objetivo/SLA, tendencia (ascendente/descendente/estable) y responsable. Publicar ese panel para las partes interesadas mensualmente es más eficaz que realizar un análisis exhaustivo trimestral, porque mantiene la calidad visible como una cuestión operativa y no como una auditoría periódica.
Cómo evaluar el panorama tecnológico
La selección de herramientas debe seguir a la estrategia, no precederla. Aclara tus dominios, flujos de trabajo y métricas de éxito antes de evaluar las plataformas.
Categorías de herramientas que debes considerar:
-
Perfilado y observabilidad de datos: medición automatizada de la línea base, detección de anomalías y alertas de deriva. Estas herramientas generan las evidencias que justifican la inversión en reglas.
-
Catálogos y linaje de datos: gestión de metadatos, documentación de conjuntos de datos y seguimiento del linaje de extremo a extremo. Son fundamentales para los programas de conjuntos de datos certificados y la preparación para auditorías.
-
Motores de reglas y validadores: la capa de aplicación. Busca compatibilidad con los tipos de reglas documentados en la guía de creación de reglas de Microsoft Purview: expresiones regulares, tipo de datos, nulos/en blanco, unicidad, búsqueda en tablas y expresiones personalizadas por fila con gestión de nulos.
-
Motores de coincidencia y deduplicación: coincidencia probabilística y determinista para la resolución de entidades.
-
Plataformas MDM: gestión de registros maestros para las entidades principales.
-
Orquestación y monitorización: programación de canalizaciones, alertas y seguimiento de SLA.
Comprar frente a desarrollar: compra una plataforma integrada cuando necesites linaje, catálogo y certificación en un único sistema con registros de auditoría y acceso basado en roles. Desarrolla (o reúne las mejores soluciones) cuando tu caso de uso sea limitado, tu pila existente ya cubra la mayoría de las capacidades o necesites una integración profunda con una plataforma de datos específica. El riesgo de las mejores soluciones es que existan brechas de integración: los metadatos no fluyen automáticamente entre las herramientas y acabas manteniendo una capa de orquestación personalizada que se convierte en su propia carga de mantenimiento.
Lista de comprobación de requisitos no funcionales: escalabilidad para tu volumen de datos, registros auditables para el cumplimiento, control de acceso basado en roles, integración basada en API para incorporar canalizaciones y preparación para la IA (la capacidad de certificar conjuntos de datos para su uso en modelos y realizar un seguimiento de las versiones de los conjuntos de datos). Para los equipos que desarrollan productos de datos relacionados con la IA, una auditoría de datos estructurados puede revelar brechas de conformidad del esquema que afectan a la preparación para LLM antes de que lleguen a la fase de entrenamiento del modelo.
Estándares y marcos que merece la pena adoptar
No necesitas implementar todas las cláusulas de todos los estándares. El valor de los estándares es que te proporcionan un vocabulario preparado para auditorías y una lista de comprobación de controles que, de otro modo, podrías pasar por alto.
-
ISO/IEC 5259-3:2024 es el estándar más directamente relevante para la gestión de la calidad de los datos (DQM) centrada en análisis y aprendizaje automático. Define requisitos para gestionar la calidad de los datos durante todo el ciclo de vida del análisis y el aprendizaje automático, con énfasis en controles auditables y resultados fiables. Úsalo para validar la cobertura de tu ciclo de vida y definir requisitos para aplicaciones de IA reguladas o de alto impacto.
-
Marco DAMA-NL DQMS traduce los controles técnicos de DQM a una estructura de sistema de gestión: políticas, elementos de datos críticos, acciones de mejora, reglas, monitorización y certificación. Es especialmente útil al preparar documentación para auditorías internas o cuando la función de cumplimiento necesita evidencias de que la calidad se gestiona sistemáticamente y no de forma ad hoc.
-
Manual de gestión de la calidad de los datos de AISIofrece orientación práctica específica para la IA sobre la calidad de las anotaciones, la detección de sesgos, el control de versiones y la supervisión de la deriva. Considéralo un complemento de ISO/IEC 5259-3 para programas con un uso intensivo de ML.
-
Orientación de analistas de Gartner y TechTargetofrecen perspectivas sobre el diseño de programas y la integración de la gobernanza que resultan útiles para preparar conversaciones con ejecutivos y evaluar proveedores.
Cómo utilizar estas normas en la práctica:elige las cláusulas más relevantes para tu nivel actual de madurez, relaciónalas con tus controles existentes y trata las brechas como una lista de tareas priorizada. Una implementación completa de ISO es un esfuerzo de varios años; utilizar la norma como lista de comprobación para una auditoría piloto de 90 días resulta útil de inmediato y no cuesta nada.
Cómo Ridiculous Engineering aborda los proyectos de DQM
Los proyectos que salen bien comparten un patrón común: una fase de descubrimiento concisa, un piloto limitado a un dominio y una transferencia que deja al equipo del cliente preparado para operar el programa sin depender continuamente de ayuda externa.
Descubrimiento y definición del alcance (semanas 1–2):Inventariamos los activos de datos, relacionamos los CDE con los procesos empresariales e identificamos los tres a cinco conjuntos de datos con mayor riesgo de calidad e impacto empresarial. El resultado es un inventario de conjuntos de datos priorizado y un documento de definición del alcance que establece los límites del piloto, las métricas de éxito y las funciones.
Perfilado y línea base (semanas 2–4):El perfilado automatizado de los conjuntos de datos prioritarios establece las líneas base de completitud, unicidad, validez y actualidad. Documentamos los resultados en un informe de perfilado que se convierte en el estado inicial para el seguimiento de los KPI.
Desarrollo y automatización de reglas del piloto (semanas 4–8):Diseñamos un conjunto de reglas para el dominio prioritario, lo implementamos en la plataforma de datos o las herramientas de canalización existentes del cliente y configuramos un flujo de trabajo de cuarentena y notificación a los responsables de los datos. Entregables: una biblioteca de reglas, un manual de remediación y una canalización automatizada operativa.
Escalado y transferencia (semanas 8–16):Ampliamos la cobertura a dominios adicionales, ponemos en funcionamiento un catálogo certificado de conjuntos de datos, publicamos un panel de KPI y realizamos sesiones de incorporación con los propietarios y responsables de los datos. El entregable final es un programa documentado que el equipo del cliente puede operar y ampliar de forma independiente.
Errores habituales que observamos y cómo los abordamos:
-
Ampliación descontrolada del alcance:Fijamos el límite del dominio piloto en el documento de definición del alcance y exigimos una solicitud formal de cambio para ampliarlo. Parece burocrático hasta la tercera semana, cuando alguien quiere añadir seis conjuntos de datos más.
-
Falta de responsables:Exigimos un propietario de datos identificado para cada conjunto de datos antes de escribir una regla. Una regla sin propietario es una alerta sin nadie que responda a ella.
-
Inversión insuficiente en la automatización de la remediación:Los equipos suelen dedicar el 80 % de su esfuerzo a crear reglas y el 20 % a la remediación. La proporción debería acercarse al 50/50. Un defecto sin corregir que se detecta repetidamente es peor para la moral que un defecto que nunca se detecta.
Lista de comprobación para evaluar proveedores:al evaluar una consultoría o un plan interno, pide un informe de perfilado de muestra de un proyecto anterior, una biblioteca de reglas con al menos 10 reglas documentadas y su justificación empresarial, un manual de remediación con vías de escalado y una plantilla de panel de KPI. Si un proveedor no puede presentar estos materiales, está vendiendo teatro de gobernanza, no un programa operativo.
Qué priorizar este trimestre
Tres a cinco acciones concretas aportan más valor que una iniciativa amplia que se estanca en la fase de planificación.
Para los patrocinadores ejecutivos:
-
Asigna esta semana un propietario de datos identificado a tus cinco conjuntos de datos principales. Sin responsables, cualquier otra inversión en calidad es frágil.
-
Aprueba un sprint de perfilado de 30 días con un resultado definido: puntuaciones de línea base de completitud, unicidad y validez para los CDE.
-
Comprométete con una periodicidad trimestral de revisión de KPI antes de que comience el programa, no después.
Para los equipos de ingeniería y datos:
-
Perfila los cinco conjuntos de datos que alimentan tus informes o modelos más críticos. Documenta las tasas de valores nulos, las tasas de duplicados y las infracciones de formato.
-
Implementa tres reglas automatizadas en tu canalización existente: una comprobación de formato o expresión regular, una comprobación de valores nulos o en blanco y una comprobación de unicidad en las claves principales.
-
Configura una cola de cuarentena y una notificación al responsable cuando fallen las reglas. Incluso una alerta sencilla por correo electrónico a un propietario identificado es mejor que un fallo silencioso.
-
Crea una lista certificada de conjuntos de datos: un registro sencillo de los conjuntos de datos que han superado unos umbrales de calidad definidos y están aprobados para su uso posterior.
El artículo sobre intercambio de datos y gobernanza de Ridiculous Engineering aborda el aspecto de coordinación entre las partes interesadas de este trabajo, que a menudo es un problema más difícil que la implementación técnica.
Ridiculous Engineering crea programas de DQM que realmente funcionan en producción
La mayoría de las organizaciones ya cuentan con las plataformas de datos y las herramientas de canalización necesarias para ejecutar un programa de DQM sólido. Lo que les falta es la arquitectura, el diseño de reglas y la estructura operativa para que funcione de forma fiable a escala. Esa es la brecha que Ridiculous Engineering cubre.
Trabajamos con equipos de empresas medianas y grandes para diseñar e implementar sistemas de calidad de datos y analítica que se conectan directamente con los resultados empresariales: menos ciclos de conciliación, menor tiempo hasta obtener información útil y datos de entrenamiento para modelos que realmente puedes certificar. Nuestros proyectos están definidos para ofrecer un piloto operativo en 30–90 días, con una transferencia clara para que tu equipo sea propietario del programa a largo plazo.
Si estás listo para pasar del perfilado a controles de nivel de producción, habla con el equipo de Ridiculous Engineering sobre un proyecto de DQM con alcance definido.
Fuentes
-
Microsoft Purview: catálogo unificado — reglas de calidad de datos
-
Marco de sistemas de gestión de la calidad de los datos — DAMA-NL (2024 v12)
-
Cómo desarrollar una estrategia de gobernanza de datos: 7 pasos clave — TechTarget
Preguntas frecuentes
¿Qué es la gestión de la calidad de los datos?
La gestión de la calidad de los datos es el conjunto de prácticas, reglas y controles operativos que mantienen los datos de una organización precisos, completos, coherentes y adecuados para su uso previsto en analítica, IA y decisiones empresariales. Abarca todo el ciclo de vida de los datos, desde la ingesta hasta el archivado.
¿Cuáles son las cuatro C de la calidad de los datos?
Las definiciones varían según los marcos, pero una versión común incluye corrección (precisión), completitud, coherencia y actualidad (puntualidad). Estas cuatro dimensiones aparecen en la mayoría de los marcos de DQM como medidas fundamentales para determinar si los datos son fiables para la toma de decisiones.
¿Cuáles son las cinco medidas clave de la calidad de los datos?
Las medidas más citadas son precisión, completitud, coherencia, puntualidad y unicidad. Muchos programas también incorporan la validez (conformidad con formatos o enumeraciones definidos) y la integridad (relaciones referenciales entre conjuntos de datos) a medida que el programa madura.
¿Cuáles son los principios fundamentales de la calidad de los datos?
Los cuatro principios en los que coinciden la mayoría de los marcos de gobernanza son la adecuación al propósito (los datos satisfacen las necesidades de sus consumidores), la responsabilidad (propietarios identificados para cada conjunto de datos), la medibilidad (la calidad se supervisa mediante métricas y SLA definidos) y la mejora continua (la calidad se supervisa y corrige como una actividad operativa continua, no como una solución puntual).