Gobernanza de LLM: un marco práctico para líderes empresariales
Gobernanza de LLM: un marco práctico para líderes empresariales La gobernanza de LLM es el conjunto de políticas, funciones y controles en tiempo de ejecución que gestionan cómo se implementan, supervisan y responsabilizan los modelos de lenguaje de gran tamaño en producción.
Gobernanza de LLM: un marco práctico para líderes empresariales
La gobernanza de LLM es el conjunto de políticas, funciones y controles en tiempo de ejecución que gestionan cómo se implementan, supervisan y responsabilizan los modelos de lenguaje de gran tamaño en producción. A diferencia de la gobernanza tradicional de la IA, que principalmente comprueba un modelo antes del lanzamiento y sigue adelante, la gobernanza de LLM considera la implementación como el inicio de la ventana de riesgo, no como su final.
Si diriges la tecnología o la gestión de riesgos en tu organización, estos son los cinco primeros pasos:
- Clasifica por niveles de riesgo cada caso de uso según el impacto empresarial y la autonomía, no solo la sensibilidad de los datos.
- Asigna un responsable a cada modelo o agente implementado, no solo un responsable de la «IA» en general.
- Implementa observabilidad en tiempo de ejecución para poder ver las indicaciones, respuestas y desviaciones mientras ocurren.
- Controla el tráfico en la capa API para filtrar las salidas incorrectas antes de que lleguen a los clientes.
- Crea un plan de auditoría que cubra las capas de gobernanza, modelo y aplicación, no una única lista de comprobación previa al lanzamiento.
Ese es el panorama completo, en resumen. El resto de esta guía explica cómo construirlo.
Conclusiones clave
Una gobernanza de LLM eficaz depende de trasladar el centro de gravedad de la validación puntual previa a la implementación a la observabilidad continua en tiempo de ejecución, combinada con auditorías coordinadas en tres capas.
| Punto | Detalles |
|---|---|
| El alcance va más allá del modelo | La gobernanza debe cubrir las indicaciones, las canalizaciones RAG, el comportamiento agéntico, los proveedores y los flujos de datos, no solo los pesos del modelo. |
| La supervisión en tiempo de ejecución es el control principal | La observabilidad continua de indicaciones, salidas e indicadores clave de riesgo detecta desviaciones que las pruebas previas al lanzamiento no detectan. |
| Audita en tres capas coordinadas | Las auditorías de gobernanza, modelo y aplicación deben aportar pruebas entre sí, no ejecutarse de forma aislada. |
| Asigna responsabilidades nominales | Cada caso de uso de alto riesgo necesita un responsable de riesgos concreto, no una bandeja de entrada compartida del equipo. |
| Obtén ayuda de ingeniería desde el principio | Ridiculousengineering desarrolla la infraestructura de control del tráfico, registro y supervisión de la que dependen las políticas de gobernanza. |
Índice
- ¿Qué cubre realmente la gobernanza de LLM?
- ¿Qué principios deben sustentar tu política de gobernanza de LLM?
- ¿Qué componentes forman un marco de gobernanza de LLM?
- ¿Cómo se debe auditar un sistema de LLM?
- ¿Qué controles en tiempo de ejecución previenen realmente los incidentes de LLM?
- ¿Cómo se hace operativa la gobernanza de LLM en el día a día?
- ¿Qué errores debes evitar en la gobernanza de LLM?
- ¿Cómo deberían ser tus primeros 90 días de gobernanza de LLM?
- Construir por tu cuenta la infraestructura de gobernanza
- Fuentes
- Preguntas frecuentes
¿Qué cubre realmente la gobernanza de LLM?
La gobernanza de LLM en los LLM va mucho más allá del propio archivo del modelo. Cubre el modelo, la superficie de indicaciones, las canalizaciones de recuperación, los flujos de trabajo agénticos, las integraciones de terceros, los contratos con proveedores y los datos que circulan por todo ello. Si solo gobiernas los pesos del modelo, estás gobernando quizá un tercio de tu superficie de riesgo real.
Esta es la distinción que confunde a la mayoría de los equipos: la gobernanza tradicional del ML presupone que un modelo produce salidas uniformes y deterministas para una entrada determinada, y que se valida una vez frente a un conjunto de pruebas. Los LLM no funcionan así. La misma indicación puede producir salidas diferentes en distintas ejecuciones. Pequeños cambios en las indicaciones pueden generar comportamientos radicalmente distintos. Y cuando añades generación aumentada mediante recuperación (RAG) o uso agéntico de herramientas, introduces comportamientos emergentes que ninguna suite de pruebas estática detecta. Una investigación sobre sistemas LLM multiagente descubrió que agentes individualmente «seguros» aún pueden producir sistemas inseguros al interactuar, debido a fallos en cascada y al sesgo de conformidad entre agentes.
Ese riesgo afecta a una parte mayor del negocio de lo que la mayoría de los líderes supone. Los sistemas incluidos normalmente son:
- Bots de atención al cliente y automatización del soporte
- Herramientas internas de gestión del conocimiento y búsqueda
- Copilotos analíticos que resumen datos sensibles
- Automatización de flujos de trabajo con acceso de escritura a sistemas de producción
- Cualquier agente que pueda actuar (enviar un correo electrónico, emitir un reembolso, modificar un registro)
Consejo profesional: Trata un caso de uso como «de alta materialidad» en cuanto pueda realizar una acción autónoma, acceder a datos regulados o llegar a un cliente externo sin un paso de revisión humana. La materialidad, no el tamaño del modelo, debe determinar el nivel de supervisión de gobernanza que recibe un caso de uso.
¿Qué principios deben sustentar tu política de gobernanza de LLM?
Toda política de gobernanza de LLM necesita un pequeño conjunto de principios que se traduzcan en controles reales, no en lenguaje aspiracional para una presentación. Seis cubren la mayor parte del trabajo:
- Transparencia: Los usuarios y las partes interesadas internas deben saber cuándo interactúan con un LLM y, aproximadamente, cómo llegó a una salida.
- Responsabilidad: Una persona o equipo identificado es responsable del comportamiento de cada modelo implementado, de principio a fin.
- Seguridad y fiabilidad: El sistema se degrada correctamente y dispone de una alternativa cuando la confianza es baja.
- Protección de datos: Las entradas y salidas respetan los compromisos de residencia, conservación y privacidad de los datos.
- Equidad: Las salidas se comprueban para detectar impactos desiguales entre grupos de usuarios, no solo la precisión agregada.
- Auditabilidad: Toda decisión material deja un rastro que un tercero podría revisar posteriormente.
Cada principio corresponde a una parte interesada distinta, precisamente por eso la gobernanza falla cuando se trata como responsabilidad de un solo equipo. El departamento jurídico se preocupa sobre todo por la transparencia y la protección de datos. Seguridad es responsable de la fiabilidad y el control de acceso. Producto es responsable de la equidad y la experiencia de usuario. El consejo quiere principalmente responsabilidad, es decir, una respuesta clara a «¿quién aprobó esto y a quién llamamos cuando falle?».
Desde el punto de vista operativo, estos principios no son solo valores: son artefactos. La transparencia se convierte en un aviso de divulgación y una ficha del modelo. La responsabilidad se convierte en un registro de aprobaciones. La auditabilidad se convierte en un rastro conservado de las indicaciones, el contexto recuperado y las salidas. Si un principio no produce un documento, un panel o una barrera en algún punto de tu canalización, todavía no es gobernanza: es una declaración de intenciones.
¿Qué componentes forman un marco de gobernanza de LLM?
Un marco de gobernanza de LLM solo es tan bueno como los artefactos que lo respaldan. Los principios no detienen una implementación incorrecta; sí lo hacen la ausencia de una ficha del modelo o de un responsable de riesgos asignado. Esto es lo que debe existir:
Artefactos necesarios:
- Matriz de clasificación por niveles de riesgo que puntúe los casos de uso según autonomía, sensibilidad de los datos y radio de impacto
- Inventario de modelos que enumere cada LLM, ajuste fino y proveedor API en producción
- Fichas de modelos que documenten la procedencia de los datos de entrenamiento, las limitaciones conocidas y el uso previsto
- Controles de acceso y tokens que delimiten qué sistemas y usuarios pueden llamar a cada modelo
- Trazabilidad de datos que registre qué datos entran en las indicaciones y dónde se almacenan las salidas
- Barreras de aprobación que requieran autorización antes de publicar un cambio de modelo o de indicación
- Manuales operativos para responder a incidentes cuando un modelo se comporte incorrectamente en producción
- Paneles de supervisión que muestren indicadores clave de riesgo (KRIs) casi en tiempo real
Elementos de política y procesos:
- Aprobaciones del ciclo de vida en cada etapa: desarrollo, puesta en escena, producción y retirada
- Evaluación de modelos de terceros antes de la adquisición, incluida una revisión de seguridad y sesgo
- Cláusulas contractuales sobre gestión de datos, notificaciones de actualizaciones del modelo y responsabilidad
- Acuerdos de nivel de servicio que definan la latencia, disponibilidad y ventanas de escalado aceptables
Nada de esto tiene que ponerse en marcha simultáneamente. Asigna cada artefacto a un responsable y una fecha límite: seguridad es responsable de los controles de acceso y la delimitación de tokens, ingeniería de las fichas de modelos y los paneles de supervisión, el departamento jurídico de los contratos con proveedores y la documentación de trazabilidad de datos, y producto de la matriz de clasificación por riesgo, con aportaciones del resto de las funciones. El MindForge AI Risk Management Handbook presenta un modelo operativo similar para instituciones financieras, y su lógica de clasificación por riesgo se adapta fácilmente a casi cualquier implementación regulada o orientada al cliente.
¿Cómo se debe auditar un sistema de LLM?
Auditar un sistema de LLM requiere tres capas independientes, y tratar cualquiera de ellas como suficiente por sí sola es la forma en que los programas de gobernanza fracasan silenciosamente. La investigación sobre la auditoría de modelos de lenguaje de gran tamaño las define como auditorías de gobernanza, auditorías del modelo y auditorías de la aplicación, coordinadas para que las pruebas de cada capa informen a las demás.
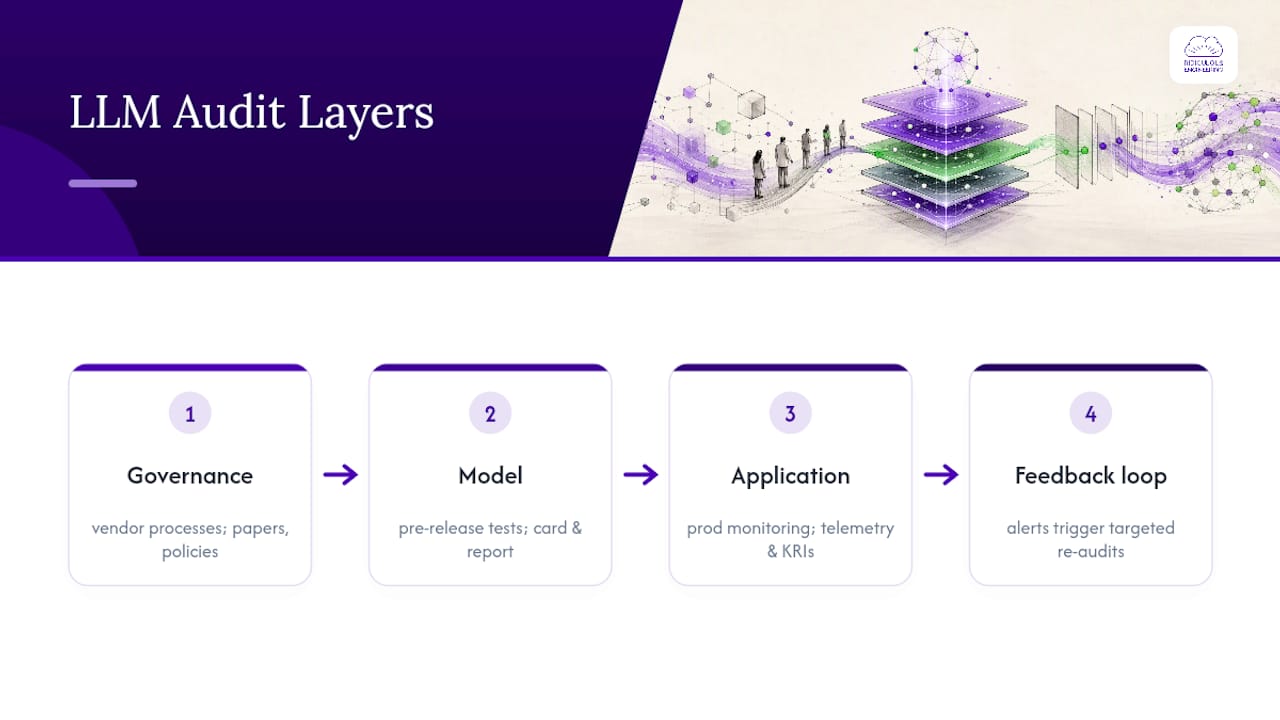
Auditorías de gobernanza examinan los procesos internos y del proveedor que producen el modelo: obtención de datos de entrenamiento, prácticas de gestión de calidad y estándares de desarrollo documentados. Las pruebas aquí son principalmente rastros documentales, declaraciones de proveedores y documentos de políticas. Indican si el proceso que creó el modelo era sólido, pero no dicen nada sobre cómo se comporta el modelo una vez activo.
Auditorías del modelo se realizan después del preentrenamiento y antes del lanzamiento. Aquí es donde las pruebas de equipo rojo y adversariales resultan útiles: buscan jailbreaks, sesgos, tasas de alucinación y fallos en casos extremos antes de que el modelo entre en contacto con un cliente. El resultado debería ser una ficha del modelo y un informe de metodología de pruebas con umbrales de aprobación o rechazo. La limitación es evidente: una auditoría del modelo es una instantánea, y el comportamiento de los LLM cambia cuando cambian las indicaciones, las fuentes de recuperación y las poblaciones de usuarios.
Auditorías de la aplicación son la capa que más organizaciones omiten y la que más importa en la práctica. Son comprobaciones continuas orientadas a producción que observan indicaciones y salidas reales, siguen indicadores clave de riesgo como la tasa de alucinación y la tasa de rechazo, y señalan las desviaciones mientras ocurren. Una revisión de la gestión del riesgo de los modelos de IA generativa lo argumenta claramente: la validación estática previa a la implementación no basta por sí sola para los sistemas de IA generativa, y la supervisión continua combinada con una revisión de cumplimiento aumentada por IA realiza la mayor parte del trabajo.
Las tres capas deben retroalimentarse. Un cambio notable en los indicadores de riesgo de la supervisión de la aplicación debería activar una auditoría específica del modelo. Un cambio en la declaración de datos de entrenamiento de un proveedor debería activar una actualización de la auditoría de gobernanza.
Consejo profesional: Construye una única canalización de pruebas que archive informes de auditoría, transmita telemetría en tiempo de ejecución y registre las acciones correctivas en un solo lugar. Cuando un regulador o miembro del consejo pregunte «demuéstralo», querrás consultar un sistema, no perseguir a tres equipos.
¿Qué controles en tiempo de ejecución previenen realmente los incidentes de LLM?
Los controles en tiempo de ejecución, no las listas de comprobación previas al lanzamiento, detectan la mayoría de los incidentes de LLM antes de que lleguen a un cliente. Aquí es donde la gobernanza deja de ser un documento de políticas y empieza a ser código.
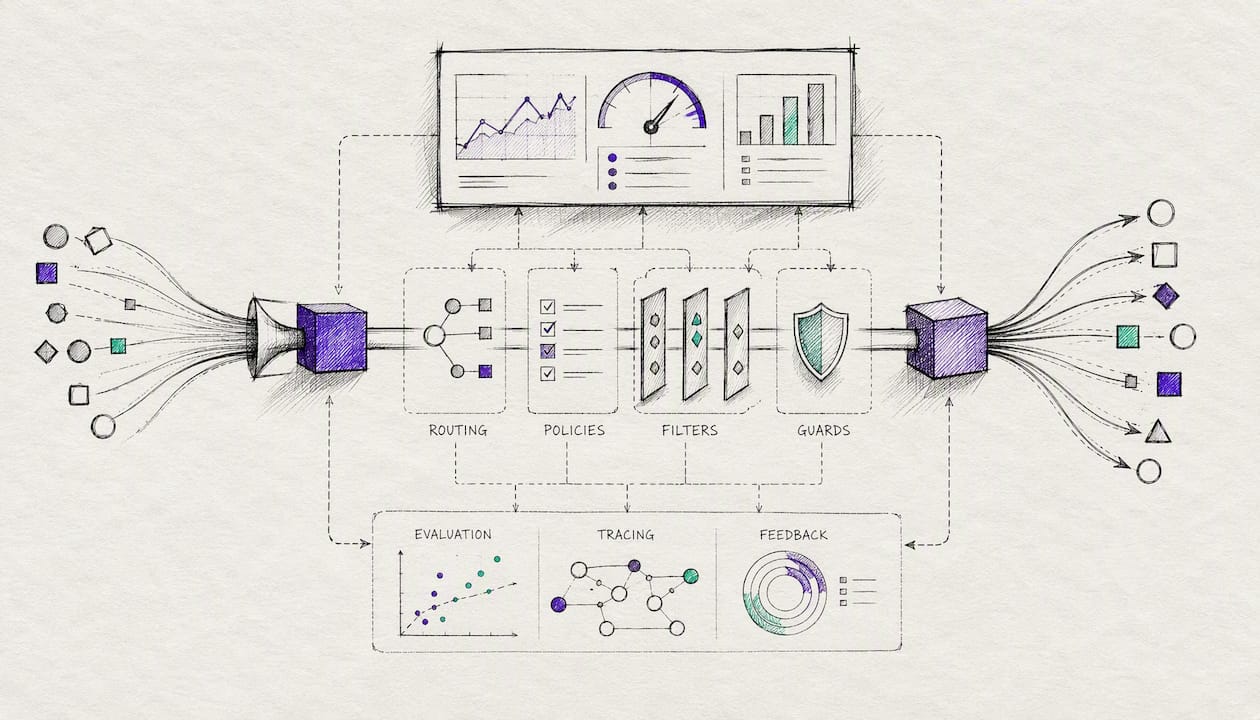
Gobernanza del tráfico se sitúa en la API pasarela. El filtrado a nivel de pasarela puede bloquear indicaciones que coincidan con patrones de inyección conocidos, delimitar los tokens para que una integración determinada solo pueda llamar a puntos finales de modelos aprobados y limitar la frecuencia de llamadas por caso de uso para contener el radio de impacto si algo sale mal. Dirigir los casos de uso de alto riesgo a un grupo más pequeño y evaluado con mayor rigor, en lugar de a un modelo de frontera de propósito general, reduce aún más la exposición. Las plataformas asociadas creadas para la gobernanza a nivel de API, como el enfoque de Jundago para probar y gobernar API, muestran cómo este patrón se extiende de forma natural a las capas REST y GraphQL, más allá del tráfico de LLM.
Los controles de RAG y recuperación son igual de importantes. Registra la procedencia de cada fragmento recuperado para saber qué fuente informó una respuesta. Oculta los campos sensibles antes de que entren en una indicación. Establece protecciones de recuperación para que el sistema no extraiga silenciosamente información de índices obsoletos o no autorizados. Restringe el acceso al almacén de embeddings con el mismo rigor que aplicarías a una base de datos de producción, porque en la práctica eso es lo que es.
La observabilidad es el tejido conectivo. Registra las indicaciones y respuestas (con la redacción adecuada), captura trazas de depuración de las llamadas fallidas y muestra en paralelo paneles de costes, latencia e indicadores clave de riesgo. La guía de SANS sobre controles de IA basados en riesgos recomienda supervisar específicamente la tasa de alucinación, los intentos de jailbreak y la desviación de indicaciones como métricas continuas, no como pruebas puntuales.
Un patrón que merece la pena adoptar directamente: dirige las salidas a un panel de modelos jueces más pequeños y especializados que puntúen la privacidad, la seguridad y el cumplimiento normativo, y después agrega los resultados en una única puntuación de cumplimiento. Este enfoque de «perfil como jurado», descrito en investigaciones recientes sobre supervisión del cumplimiento en tiempo de ejecución, evita el riesgo de monocultivo de confiar en la autoevaluación de un solo modelo sobre su propia salida.
Lista de comprobación de ingeniería:
- Define un esquema de registro que cubra indicaciones, respuestas, contexto recuperado y versión del modelo
- Establece políticas de conservación alineadas con tus compromisos de protección de datos
- Crea mecanismos de escalado que avisen a una persona cuando los indicadores clave de riesgo superen un umbral
- Integra la puntuación del panel de jueces o de la barrera de cumplimiento en la propia canalización de implementación
¿Cómo se hace operativa la gobernanza de LLM en el día a día?
Hacer operativa la gobernanza de LLM comienza con una estructura ligera, no con un departamento nuevo. La mayoría de las organizaciones necesitan tres cosas: un comité central de gobernanza que establezca la política y los umbrales de riesgo, responsables de riesgos integrados en cada línea de negocio que conozcan mejor sus casos de uso y barreras de ingeniería incorporadas en la propia canalización de implementación.
El modelo de las tres líneas de defensa se adapta bien a los LLM:
- Primera línea: El equipo que desarrolla o implementa el modelo es responsable de la gestión diaria del riesgo, incluidas las fichas del modelo y las pruebas iniciales.
- Segunda línea: Riesgos, asuntos jurídicos y seguridad revisan las implementaciones según la política, realizan pruebas de equipo rojo independientes y mantienen las barreras de cumplimiento.
- Tercera línea: La auditoría interna comprueba periódicamente que las dos primeras líneas hacen realmente lo que afirman, utilizando como material las pruebas de las auditorías en tres capas.
Una cadencia viable sería la siguiente:
- Admisión: El nuevo caso de uso se clasifica por riesgo antes de comenzar cualquier desarrollo
- Aprobación: El responsable de riesgos y el revisor de la segunda línea aprueban el nivel y los controles necesarios
- Lista de comprobación de implementación: Ingeniería confirma que el registro, el control del tráfico y la alternativa están activos antes del lanzamiento
- Revisión de la supervisión: Revisión semanal o quincenal de los paneles de indicadores clave de riesgo para los casos de uso de nivel más alto
- Auditoría trimestral: Auditoría coordinada de gobernanza, modelo y aplicación para los sistemas materiales
Realiza un seguimiento coherente de un conjunto reducido de KPI e indicadores clave de riesgo: tasa de alucinación, tasa de aprobación de la barrera de cumplimiento, tasas de falsos positivos y falsos negativos en los filtros de contenido y tiempo medio de mitigación una vez señalado un problema. Estas cifras importan más al consejo que una descripción narrativa del proceso, porque muestran las tendencias.
Lista de comprobación del despliegue inicial:
- Haz un inventario de cada LLM y agente actualmente en producción o en fase piloto
- Elige las herramientas de observabilidad antes que las herramientas de políticas; no puedes gobernar lo que no puedes ver
- Adopta políticas como código cuando sea posible para que las barreras se apliquen automáticamente en lugar de depender de revisiones manuales
- Define la conservación de los registros de auditoría antes de tu primera auditoría trimestral, no después
¿Qué errores debes evitar en la gobernanza de LLM?
Los errores más costosos de la gobernanza de LLM son estructurales, no técnicos. Algunos aparecen una y otra vez.
Tratar la gobernanza únicamente como un problema de TI excluye al departamento jurídico, producto y el consejo de decisiones que deberían tomar. Corrígelo asignando responsables de riesgos identificados en el negocio, no solo una cola de tickets en ingeniería.
Depender demasiado de la validación previa a la implementación genera una falsa sensación de seguridad. Un modelo que superó las pruebas de equipo rojo en enero puede desviarse en su comportamiento en junio a medida que cambian las indicaciones, los usuarios y las fuentes de recuperación. La supervisión en tiempo de ejecución detecta eso, no un informe puntual.
El riesgo de monocultivo aparece cuando un único modelo (o la autoevaluación de una única familia de modelos) evalúa su propio cumplimiento. Los paneles de jueces multimodelo reducen ese punto ciego.
Ignorar la desviación de las indicaciones y del uso significa que nadie se da cuenta cuando las indicaciones de producción se han alejado silenciosamente de lo que se probó. Versiona y registra las indicaciones como versionarías el código.
Los contratos débiles con terceros te dejan expuesto cuando un proveedor cambia un modelo sin avisar. Exige notificaciones de actualizaciones y derechos de auditoría en todos los acuerdos con proveedores.
Si llevas una sola advertencia a tu equipo directivo, que sea esta: una auditoría previa al lanzamiento aprobada no te dice casi nada sobre el riesgo del próximo trimestre.
¿Cómo deberían ser tus primeros 90 días de gobernanza de LLM?
Poner en marcha la gobernanza de LLM en 90 días es realista si secuencias correctamente las tareas. Intentar hacerlo todo en el primer mes es la forma de paralizar los programas.
Días 1 a 30:
- Completa un inventario exhaustivo de modelos y casos de uso
- Clasifica por riesgo cada caso de uso mediante una matriz sencilla de alto/medio/bajo
- Asigna responsables identificados a cada caso de uso de nivel alto
- Implementa un registro básico de indicaciones, respuestas y versión del modelo
- Define una alternativa de emergencia (derivación a una persona o desactivación de la función) para los flujos de alto riesgo
Días 31 a 60:
- Implementa el control del tráfico de la pasarela API para los flujos de mayor riesgo
- Publica fichas de modelo para cada modelo en producción
- Automatiza al menos tres indicadores clave de riesgo (tasa de alucinación, tasa de rechazo y latencia)
- Define tu cadencia de auditoría y quién ocupa cada una de las tres líneas de defensa
Días 61 a 90:
- Realiza un ejercicio de equipo rojo contra tu caso de uso de mayor materialidad
- Completa una primera auditoría coordinada que abarque las capas de gobernanza, modelo y aplicación
- Prepara un informe para el consejo que resuma los niveles de riesgo, los indicadores clave de riesgo y las medidas de remediación pendientes
Entre los objetivos iniciales que merece la pena fijar están garantizar que todos los flujos de alto riesgo tengan un manual operativo documentado en un plazo de dos meses, que la escalada de las infracciones de los indicadores de riesgo se produzca rápidamente y que las tasas de aprobación de las barreras de cumplimiento se sigan con frecuencia, no de forma esporádica.
Construir por tu cuenta la infraestructura de gobernanza
La mayor parte de lo que describe esta guía —el esquema de registro, la pasarela de tráfico, las barreras de cumplimiento y la canalización de fichas de modelos— no es trabajo de políticas. Es ingeniería de software. Y ahí es donde suelen atascarse los programas de gobernanza: los equipos jurídicos y de riesgos pueden redactar la política, pero alguien tiene que construir la pasarela que aplique la delimitación de tokens, el panel que muestre los indicadores clave de riesgo en tiempo real y el rastro de auditoría que resista las preguntas de un regulador.
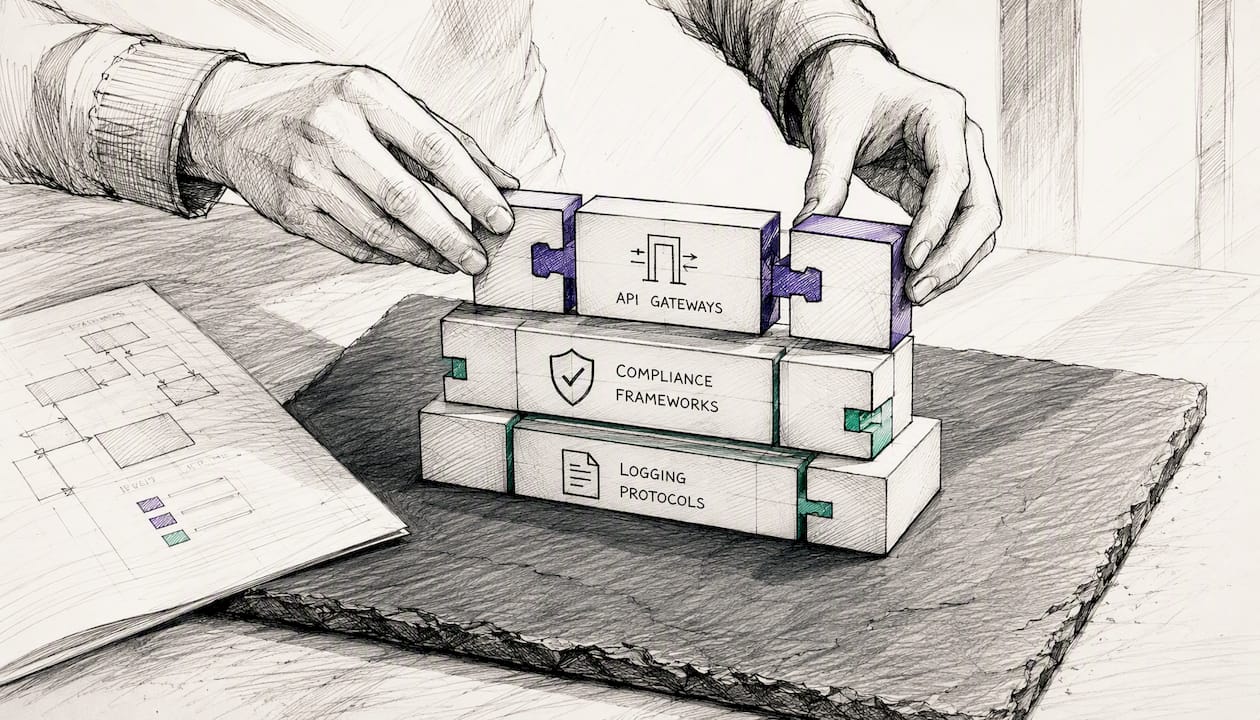
Esa es la brecha que cubre Ridiculousengineering. Construimos la infraestructura en tiempo de ejecución, API pasarelas, canalizaciones de observabilidad, refuerzo de RAG y paneles de supervisión, que convierten una política de gobernanza de LLM de un documento en algo que realmente funciona en producción. Si estás modernizando sistemas heredados para añadir funciones de IA de forma segura o necesitas desarrollo de software personalizado para implementar la capa de control del tráfico y registro que exige tu plan de gobernanza, ese es exactamente el tipo de proyecto que asumimos. Ponte en contacto con nosotros y definiremos el alcance de tus primeros 90 días de implementación técnica.
Fuentes
Hay varias fuentes que merece la pena guardar si vas a desarrollar más este programa. El NIST AI Risk Management Framework sigue siendo el estándar más adaptable para mapear, medir y gestionar el riesgo de la IA en cualquier sector. El artículo sobre auditoría en tres capas ofrece el desglose más claro disponible de las auditorías de gobernanza, modelo y aplicación. En cuanto al cumplimiento en tiempo de ejecución, el marco de gobernanza basada en métricas explica en términos prácticos la puntuación mediante paneles de jueces y las barreras de cumplimiento. El manual de MindForge ofrece un modelo operativo para sectores regulados que se adapta bien fuera del ámbito financiero. El marco de modelos a métricas es útil para traducir principios en artefactos medibles. Y la revisión sobre la gestión del riesgo de los modelos de IA generativa defiende con mayor solidez la supervisión continua frente a la validación estática.
- Auditoría de modelos de lenguaje de gran tamaño: un enfoque en tres capas
- Gestión eficaz del riesgo de modelos de IA generativa (revisión de finanzas/seguros)
- MindForge AI Risk Management Executive Handbook (consorcio MAS)
Preguntas frecuentes
¿Qué significa LLM?
LLM significa modelo de lenguaje de gran tamaño, un tipo de sistema de IA entrenado con grandes conjuntos de datos de texto para generar y comprender lenguaje natural, incluidas herramientas como ChatGPT y Claude.
¿Cuáles son los cuatro modelos de gobernanza?
Los marcos de gobernanza varían según el campo, pero la gobernanza corporativa y de TI suele hacer referencia a cuatro modelos generales: impulsado por los accionistas, impulsado por las partes interesadas, jerárquico o regulatorio, y de red o colaborativo; la gobernanza de LLM suele tomar más elementos de los enfoques orientados a las partes interesadas y regulatorios, dada la combinación de intereses jurídicos, de seguridad y de producto.
¿ChatGPT es un LLM o IA generativa?
ChatGPT es ambas cosas: se basa en un modelo de lenguaje de gran tamaño (un LLM) y pertenece a la categoría más amplia de la IA generativa, que incluye cualquier sistema que cree contenido nuevo, como texto, imágenes o código.
¿Cuál es el salario de un título LLM?
Esta pregunta normalmente se refiere a un título de Master of Laws (LL.M.), una especialización jurídica, no a un modelo de lenguaje de gran tamaño; los salarios de los graduados de LL.M. varían mucho según la especialidad, el país y el bufete, y este artículo no aborda los resultados de la formación jurídica.
¿Cómo empezar con la gobernanza de LLM si hoy no tienes ningún programa?
Empieza con un inventario completo de modelos y casos de uso, clasifica cada caso por riesgo, asigna responsables identificados e implementa un registro básico antes de añadir documentos formales de políticas; la infraestructura y la observabilidad suelen requerir un esfuerzo de ingeniería específico, y un socio como Ridiculousengineering puede acelerar el calendario.