Implementaciones sin tiempo de inactividad: guía práctica para ingenieros
Implementaciones sin tiempo de inactividad: guía práctica para ingenieros. Una implementación sin tiempo de inactividad consiste en poner código nuevo en producción sin ninguna interrupción visible para el usuario: las solicitudes en curso terminan con normalidad, las tasas de error se mantienen estables y nadie recibe un 502.
Implementaciones sin tiempo de inactividad: guía práctica para ingenieros
Una implementación sin tiempo de inactividad consiste en poner código nuevo en producción sin ninguna interrupción visible para el usuario: las solicitudes en curso terminan con normalidad, las tasas de error se mantienen estables y nadie recibe un 502. La conclusión breve es esta: elige la estrategia más sencilla que cumpla tus SLO y tu presupuesto. La mayoría de los equipos optan por lanzamientos canary o implementaciones azul/verde cuando una actualización gradual o incluso un simple cambio atómico de enlace simbólico habría funcionado perfectamente.
Todos los enfoques de esta guía dependen de tres requisitos previos innegociables: comprobaciones de estado de disponibilidad y actividad que impidan el tráfico hasta que una instancia nueva esté realmente lista, un apagado ordenado que drene las solicitudes en curso antes de que termine un proceso y suficiente observabilidad para saber en 60 segundos si una implementación funciona correctamente. Sin esos tres elementos, ninguna estrategia es segura, por sofisticada que sea la orquestación.
Esta guía cubre:
-
Las cinco estrategias principales de implementación y sus ventajas e inconvenientes
-
Patrones de migración de bases de datos y esquemas que preservan la compatibilidad
-
Enrutamiento del tráfico, drenaje de conexiones y gestión de sesiones
-
Líneas base de observabilidad, controles basados en SLO y reversión automatizada
-
Recetas para pruebas, entornos de preproducción y dimensionamiento de canary
-
Un marco de decisión para elegir la estrategia adecuada
-
Reglas prácticas y antipatrones habituales
-
Un manual operativo listo para copiar
-
Dependencias de terceros, compatibilidad entre microservicios, reversión y seguridad
Índice
-
Qué requieren realmente las implementaciones sin tiempo de inactividad
-
Cómo consigue realmente el enrutamiento del tráfico cero tiempo de inactividad
-
La automatización y la observabilidad son la base de la seguridad
-
Manual operativo: tu lista de comprobación para implementaciones sin tiempo de inactividad
-
Gestión de dependencias de terceros y versionado de API externas
-
Compatibilidad hacia atrás y hacia delante en microservicios
-
Reversión y recuperación ante desastres después de fallos de implementación
-
Consideraciones de seguridad durante las implementaciones sin tiempo de inactividad
-
Ridiculousengineering puede auditar e implementar tus prácticas de implementación
Qué requieren realmente las implementaciones sin tiempo de inactividad
Una implementación sin tiempo de inactividad es una estrategia de lanzamiento en la que una versión nueva sustituye a la antigua sin ningún periodo de indisponibilidad. La definición parece sencilla. La implementación es donde los equipos encuentran problemas, porque la estrategia que elijas determina el coste de tu infraestructura, la velocidad de reversión y el perfil de riesgo de cada lanzamiento que realices.
Comparativa de las cinco estrategias principales
Implementaciones azul/verdemantienen dos entornos idénticos. El azul está activo; el verde recibe la nueva versión. Una vez que el verde supera la validación, un equilibrador de carga o un registro DNS desvía todo el tráfico en una única operación atómica.Despliegue azul/verdeofrece una reversión instantánea al redirigir el tráfico al azul, que sigue ejecutando la versión anterior sin modificaciones. El coste es aproximadamente el doble de infraestructura durante la ventana de transición.
Lanzamientos canarydirigen un pequeño porcentaje del tráfico de producción a la nueva versión, evalúan el comportamiento frente a los SLO y aumentan gradualmente el porcentaje.Lanzamientos canarylimitan el alcance del impacto, pero exigen una observabilidad y una automatización sólidas para tomar decisiones rápidas de promoción o reversión. Son la opción adecuada para API con mucho tráfico, donde incluso un aumento del 1 % en la tasa de errores constituye una señal relevante.
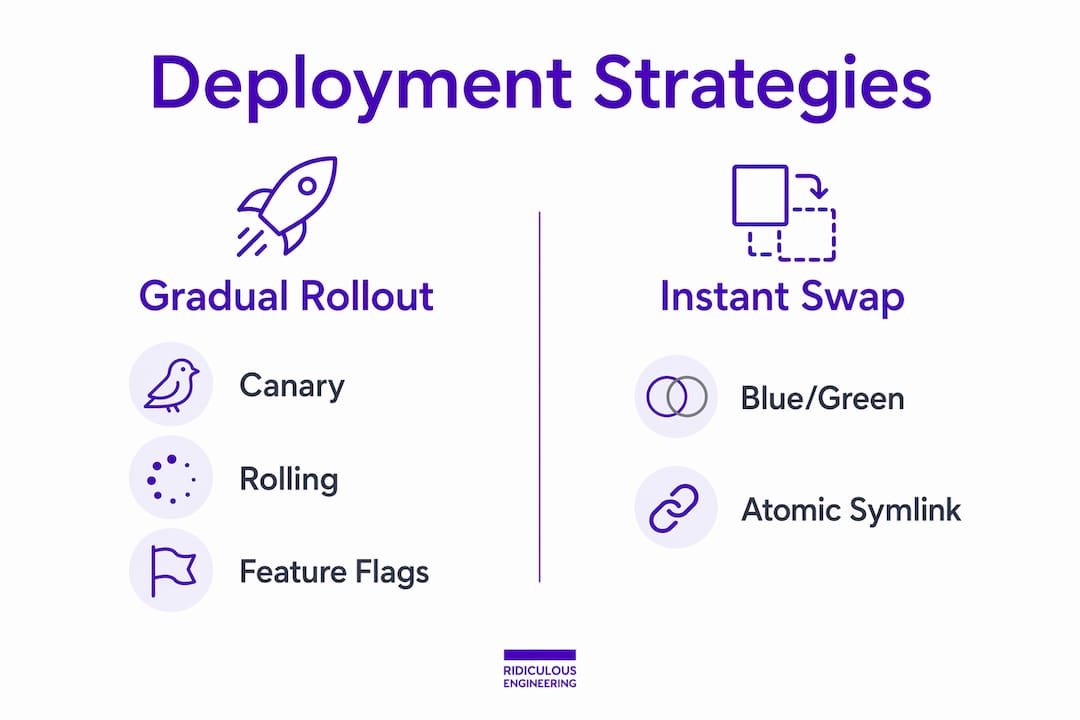
Actualizaciones progresivassustituyen gradualmente las instancias de la versión antigua por la nueva, un lote cada vez, mientras el tráfico sigue fluyendo hacia las instancias que no han cambiado. Kubernetes lo implementa de forma nativa con maxUnavailable: 0 y maxSurge: 1 para lograr un comportamiento de auténtico tiempo de inactividad cero. El inconveniente: los despliegues progresivos requieren código y esquemas de base de datos compatibles con versiones anteriores y posteriores, porque ambas versiones se ejecutan simultáneamente durante la transición.
Indicadores de funcionalidadesdesacoplan el despliegue de la publicación. El código llega a producción con un indicador desactivado; la funcionalidad se activa por separado, para el 1 % de los usuarios, después el 10 % y finalmente el 100 %, sin necesidad de volver a desplegar en cada etapa. Es una de las prácticas con mayor impacto disponibles, independientemente de la estrategia de despliegue con la que se combine.
Despliegues atómicos con enlaces simbólicoscrean un nuevo directorio de publicación, lo compilan completamente sin conexión y después cambian un enlace simbólico currenten una única llamada al sistema rename. Los cambios atómicos de enlaces simbólicos permiten conmutaciones inferiores a un segundo y verdaderamente atómicas en aplicaciones de un solo servidor o de flotas pequeñas, y suelen ser la forma más sencilla de lograr tiempo de inactividad cero en esos entornos. La reversión consiste en volver a apuntar el enlace simbólico.
Comparación de estrategias
| Estrategia | Coste de infraestructura | Tiempo de reversión | Perfil de riesgo | Más adecuado para |
|---|---|---|---|---|
| Enlace simbólico atómico | Mínimo | Inferior a un segundo | Muy bajo | Un solo servidor, flotas pequeñas |
| Actualización progresiva | Bajo (solo capacidad adicional) | De segundos a minutos | Bajo-medio | Flotas con esquemas de base de datos compatibles |
| Azul/verde | ~2 veces durante la transición | Segundos (cambio del equilibrador de carga) | Bajo | Necesidades normativas, baja tolerancia al riesgo |
| Canario | Bajo-medio | Segundos (cambio de tráfico) | Bajo (radio de impacto limitado) | API con mucho tráfico y una observabilidad sólida |
| Indicadores de funcionalidad | Mínimo | Instantáneo (activación del indicador) | Muy bajo | Cambios arriesgados en la interfaz de usuario o el backend, despliegues graduales |
Consejo profesional: Muchos equipos eligen una orquestación compleja cuando una técnica más sencilla cumpliría sus objetivos de nivel de servicio y presupuesto. Empieza con actualizaciones mediante enlaces simbólicos atómicos o actualizaciones progresivas. Pasa a blue/green o canary solo cuando tu perfil de tráfico, tus requisitos de reversión o tus limitaciones normativas lo exijan realmente.
Las migraciones de bases de datos son la parte más difícil
Los cambios de esquema impiden el tiempo de inactividad cero porque el código antiguo y el nuevo de la aplicación coexisten durante un despliegue. Un cambio de nombre de columna que espera el código nuevo hará que fallen las instancias antiguas que aún atienden tráfico. Una restricción NOT NULL añadida antes de completar el relleno de datos rechazará las escrituras de la versión antigua. Este es el modo de fallo más común en los despliegues sin tiempo de inactividad, y tiene una solución bien conocida.
El patrón de expansión-contracción trata los cambios de esquema como una secuencia de tres despliegues:
-
Expansión: Añade la nueva columna como anulable (compatible con versiones anteriores del código antiguo). Ejecuta
CREATE INDEX CONCURRENTLYpara cualquier índice nuevo. No despliegues todavía cambios en el código de la aplicación. -
Transición: Despliega el nuevo código de la aplicación para que escriba simultáneamente en las columnas antigua y nueva (escrituras duales). Ejecuta rellenos de datos por lotes en transacciones pequeñas para evitar bloqueos de tablas. Valida la coherencia de los datos.
-
Contracción: Cuando todas las instancias ejecuten el código nuevo y los datos se hayan migrado por completo, elimina la columna antigua en un despliegue independiente. Aplica las restricciones NOT NULL solo en esta fase.
Cada fase se puede desplegar y revertir de forma independiente. Ningún despliegue requiere que el esquema y el código de la aplicación cambien al mismo tiempo.
Consejo profesional: Nunca incluyas una operación de esquema destructiva (DROP COLUMN, RENAME COLUMN, añadir NOT NULL a una columna existente) en el mismo despliegue que el código de la aplicación. Trata los cambios de esquema como una versión independiente, con su propio plan de reversión.
Mitigaciones adicionales que conviene incorporar a tu flujo de trabajo de migraciones:
-
Usa
CREATE INDEX CONCURRENTLYpara evitar bloqueos a nivel de tabla durante la creación de índices -
Añade primero las columnas nuevas como anulables; aplica las restricciones solo después de completar el relleno de datos
-
Ejecuta los rellenos de datos en lotes de entre 1.000 y 10.000 filas, con breves intervalos de espera entre lotes
-
Prueba los scripts de migración con una base de datos de preproducción del tamaño de producción antes de ejecutarlos en producción
-
Mantén pruebas de compatibilidad de versiones del esquema en tu canal de CI
Cómo el enrutamiento del tráfico logra realmente el tiempo de inactividad cero
Los equilibradores de carga y las mallas de servicios son el mecanismo que hace que el cambio de tráfico sea invisible para los usuarios. Comprender su comportamiento durante un despliegue evita los errores más comunes de gestión del tráfico.
Cuando cambias el tráfico en una configuración blue/green, el equilibrador de carga (un ALB de AWS, un upstream de NGINX o una regla de enrutamiento de una malla de servicios) actualiza su grupo de destinos o su ruta ponderada. Las solicitudes que ya están en curso hacia el grupo de destinos antiguo se completan con normalidad; las conexiones nuevas van al grupo de destinos nuevo. La variable operativa clave es la ventana de drenaje: el tiempo que el equilibrador de carga espera a que se completen las solicitudes en curso antes de cerrar por la fuerza las conexiones con una instancia dada de baja.
Establece la ventana de drenaje en al menos la latencia p99 de tus solicitudes, más un pequeño margen. Si tu p99 es de 800 ms, una ventana de drenaje de 5 segundos es segura. Una ventana de drenaje inferior al p99 provocará la pérdida de solicitudes durante el cambio, independientemente de lo cuidadosa que sea tu lógica de despliegue.
El cambio basado en DNS es más lento y menos predecible. La propagación del TTL significa que algunos clientes seguirán accediendo al entorno antiguo durante minutos u horas después de actualizar un registro DNS. Para la mayoría de los sistemas de producción, el cambio de tráfico a nivel del balanceador de carga es la herramienta adecuada; el cambio basado en DNS solo es aceptable en entornos donde se tolere un breve periodo de tráfico dividido.
Las sesiones persistentes crean un riesgo específico. La afinidad de sesión en el balanceador de carga fija a un usuario en una instancia concreta, lo que significa que algunos usuarios permanecen en la versión antigua más tiempo que otros durante una actualización gradual. El enfoque más seguro es almacenar el estado de la sesión externamente (Redis, un almacén de sesiones respaldado por una base de datos) para que cualquier instancia pueda atender a cualquier usuario. Si las sesiones persistentes son inevitables, planifica una ventana de drenaje más larga y prueba explícitamente la continuidad de las sesiones durante la fase de staging.
Consejo profesional: Configura tu sonda de disponibilidad para que devuelva un estado distinto de 200 hasta que la aplicación haya completado su secuencia de calentamiento, incluido el precalentamiento de la caché o la inicialización del pool de conexiones. Enrutar tráfico prematuramente a una instancia fría es una fuente habitual de picos de latencia durante los despliegues.
Lista de comprobación para el cambio de tráfico:
-
Ventana de drenaje establecida en la latencia p99 más un margen
-
Tiempo de espera de las solicitudes en curso configurado en el lado de la aplicación
-
Sonda de disponibilidad validada con el tiempo de calentamiento real
-
Alcance de las sesiones persistentes documentado y mitigado mediante almacenamiento externo de sesiones cuando sea posible
La automatización y la observabilidad son la base de la seguridad
Una estrategia de despliegue sin verificación automatizada es una estrategia que depende de que alguien observe un panel de Grafana a las 2 de la madrugada. Eso no es un proceso; es esperanza.
La canalización CI/CD mínima para un despliegue seguro incluye: compilación y pruebas unitarias, pruebas de integración contra un entorno de staging que replique las dependencias críticas, despliegue en el entorno inactivo (o inicio de la actualización gradual), bloqueo basado en comprobaciones de estado antes de cambiar cualquier tráfico, prueba smoke sintética contra la nueva versión y activación automática del rollback si fallan los controles.
La base de observabilidad que necesitas antes de ejecutar cualquiera de estas estrategias en producción:
-
Tasa de errores: tasa de respuestas HTTP 5xx por servicio, medida en el balanceador de carga y en la capa de aplicación
-
Latencia p95/p99: medida por endpoint, no solo como agregado
-
Tasa de éxito: para las transacciones empresariales críticas (finalización de la compra, inicio de sesión, procesamiento de pagos)
-
Señales de saturación: uso de CPU, memoria y pool de conexiones en las nuevas instancias
La promoción del canary necesita comprobaciones automatizadas para las proporciones de errores, la latencia y las métricas empresariales, a fin de evitar una supervisión humana lenta. Un activador de rollback automatizado práctico sería el siguiente: si la tasa de errores del canary supera la línea base en más de un 0,5 % durante dos ventanas de evaluación consecutivas de 30 segundos, revierte automáticamente y avisa al ingeniero de guardia. El requisito de dos ventanas filtra los picos transitorios que, de otro modo, provocarían rollbacks falsos y ruidosos.
Los SLO y los presupuestos de errores determinan directamente la duración del canary. Si tu SLO es una disponibilidad del 99,9 % y consumes el presupuesto de errores al doble de la tasa normal durante un canary, esa es la señal para hacer rollback, no para esperar a que una persona lo observe. Los equipos que conectan la lógica de promoción del canary a la tasa de consumo del presupuesto de errores detectan las regresiones más rápido y con menos intervención manual.
Consejo profesional: La observabilidad es la base de la seguridad: sin comprobaciones de estado y métricas significativas, incluso estrategias seguras como el canary pueden crear experiencias degradadas para determinados grupos de usuarios. Instrumenta antes de desplegar, no después de un incidente.
Recetas de pruebas y despliegues seguros
La validación previa al despliegue no es opcional. Ejecuta todo el conjunto de pruebas automatizadas, pruebas de integración contra réplicas de staging de las dependencias críticas y una prueba smoke que recorra el flujo correcto de los recorridos de usuario más importantes. Si alguna falla, el despliegue no continúa.
El canary no es un entorno de pruebas. Es un paso de verificación en producción. Si tus pruebas previas al despliegue son débiles, un canary detectará errores en producción; eso es mejor que detectarlos cuando afectan a todos los usuarios, pero peor que detectarlos antes de que cualquier usuario los vea.
Para dimensionar el canary, una progresión práctica del tráfico es 1 % → 5 % → 25 % → 100 %, con ventanas de evaluación entre cada paso. ¿Cuánto debe durar cada ventana? Depende de la frecuencia de tus despliegues y de la latencia de las señales de las métricas. Si despliegas varias veces al día y tus métricas de tasa de errores se actualizan cada 30 segundos, una ventana de 5 minutos al 1 % basta para detectar la mayoría de las regresiones. Si despliegas semanalmente y tus KPI empresariales tardan 10 minutos en estabilizarse, amplía la ventana en consecuencia. El cuaderno de trabajo de canary de Google SRE recomienda vincular la duración del canary al tiempo necesario para que se estabilice tu señal significativa más lenta.
Las pruebas de carga durante el despliegue se utilizan menos de lo debido. Simula en staging el tráfico máximo esperado contra la nueva versión antes de promocionarla a producción. Verifica que las tasas de errores se mantengan estables y que la latencia p99 no se deteriore bajo carga. Esto detecta regresiones en el dimensionamiento de recursos que las pruebas unitarias nunca revelarían.
Para equipos de baja velocidad (menos de un despliegue por semana), es aceptable una breve validación manual entre los pasos del canary. Un ingeniero revisa el panel, confirma que las métricas parecen correctas y aprueba el siguiente paso. Para equipos de alta velocidad, ese paso manual se convierte en un cuello de botella y una responsabilidad. Automatiza la validación.
Consejo profesional: Ejecuta pruebas de carga contra tu entorno de staging usando patrones de tráfico representativos de producción, no una carga sintética uniforme. El tráfico real tiene ráfagas, endpoints de cola larga y casos límite que la carga uniforme no detecta en absoluto.
Cómo elegir la estrategia adecuada para tu situación
La decisión no consiste en elegir qué estrategia es «la mejor». Consiste en elegir la opción menos compleja que satisfaga tus limitaciones específicas.
Analiza estas preguntas en orden:
-
¿Ejecutas un único servidor o una flota pequeña? El enlace simbólico atómico es tu respuesta. Añade un gestor de procesos (systemd, Supervisor) que gestione la recarga ordenada y habrás terminado.
-
¿Tienes una flota con un esquema de base de datos compatible? Las actualizaciones progresivas con comprobaciones de disponibilidad y un apagado ordenado cubren la gran mayoría de los despliegues en producción.
-
¿Tienes una tolerancia al riesgo muy baja o requisitos normativos? El despliegue azul/verde ofrece la reversión más limpia y el cambio más fácil de auditar.
-
¿Tienes mucho tráfico, una observabilidad sólida y umbrales de métricas automatizados? El canario merece la inversión y ofrece el menor radio de impacto.
-
¿Estás realizando un cambio arriesgado en la interfaz o el backend que quieres desacoplar del despliegue? Indicadores de funcionalidad, independientemente de la estrategia de despliegue que utilices.
Señales de alerta que te orientan hacia estrategias más seguras y conservadoras:
-
latencia de solicitudes p99 superior a 2 segundos (se requieren ventanas de drenaje largas; las actualizaciones progresivas se vuelven lentas)
-
Cambios frecuentes y complejos de esquema (la disciplina de expansión y contracción es obligatoria; azul/verde simplifica la reversión)
-
Muchos servicios estrechamente acoplados que deben desplegarse de forma coordinada (los indicadores de funcionalidad ayudan; el canario se vuelve más difícil de analizar)
-
No hay métricas significativas de producción en un plazo de 60 segundos (el canario no es seguro sin una señal rápida)
Mapa sencillo: enlace simbólico atómico para aplicaciones de un solo servidor, actualizaciones progresivas para flotas con esquemas compatibles, azul/verde para entornos con baja tolerancia al riesgo o regulados, y canario para API con mucho tráfico, una observabilidad sólida y umbrales automatizados.
Reglas prácticas de profesionales y antipatrones que debes evitar
Estas son las lecciones que aparecen en los análisis posteriores a incidentes, no en la documentación.
Reglas prácticas que conviene interiorizar:
-
Mantén el número de versiones activas simultáneamente lo más bajo posible durante un canario. Cada versión adicional aumenta la complejidad de la depuración y dificulta atribuir los incidentes.
-
Establece el tiempo de espera para el apagado ordenado ligeramente por encima de tu latencia p99. Si p99 es de 800 ms, utiliza un tiempo de espera de apagado de 2 segundos. Esto permite que las solicitudes en curso terminen sin retrasar indefinidamente el despliegue.
-
Prefiere cambios de base de datos aditivos. Añadir una columna es seguro. Cambiar el nombre o eliminar una columna requiere varias operaciones de despliegue.
-
Usa indicadores de funcionalidad para cualquier cambio que implique un riesgo significativo para los usuarios, incluso cuando el despliegue en sí tenga poco riesgo.
Antipatrones habituales:
Proliferación de versiones ocurre cuando los equipos mantienen los canarios durante demasiado tiempo sin una lógica de promoción automatizada. Terminas con tres o cuatro versiones en producción simultáneamente, cada una con un comportamiento ligeramente diferente, y depurar cualquier problema requiere saber a qué versión llegó una solicitud determinada.
Promoción controlada manualmente anula el propósito de un canario. Si pasar del 5 % al 25 % requiere que un ingeniero revise manualmente un panel y haga clic en un botón, has introducido el tiempo de reacción humano como variable en tu red de seguridad. Automatiza el umbral.
Acoplar mal los cambios de esquema a los indicadores de funcionalidad es un error sutil. Si un indicador de funcionalidad controla una ruta de código que escribe en una columna nueva y activas el indicador antes de que la columna exista en producción, se producen errores. La secuencia importa: primero el cambio de esquema, después el despliegue del código y, por último, la activación del indicador.
Los equipos que gestionan los despliegues con mayor fiabilidad no son los que tienen las herramientas más sofisticadas. Son los que cuentan con los procedimientos operativos más claros, la secuencia de cambios más disciplinada y los ciclos de retroalimentación más rápidos. La sofisticación sin disciplina provoca incidentes.
Ridiculousengineering ha trabajado en estos patrones con clientes de diversos sectores, desde plataformas de comercio electrónico que gestionan eventos de ventas con mucho tráfico hasta sistemas de datos regulados en los que la velocidad de reversión es un requisito de cumplimiento normativo. El hallazgo constante: los equipos que adoptan prácticas de entrega iterativa y mantienen los cambios pequeños realizan entregas con mayor fiabilidad que los equipos que agrupan los cambios y dependen de esfuerzos heroicos durante las ventanas de despliegue.
Manual operativo: tu lista de comprobación para despliegues sin tiempo de inactividad
Copia esto en el procedimiento operativo de respuesta a incidentes y adáptalo a tu pila tecnológica.
Antes del despliegue
-
Confirma que todas las pruebas automatizadas se superan en CI (unitarias, de integración y de humo).
-
Ejecuta una simulación de la migración contra una base de datos de staging del tamaño de producción; verifica que no haya operaciones que bloqueen.
-
Confirma que los paneles de observabilidad están activos y que se han capturado las métricas de referencia.
-
Verifica que el endpoint de la sonda de disponibilidad devuelva 200 en la nueva compilación.
-
Confirma que la ventana de drenaje esté configurada correctamente en el balanceador de carga.
-
Identifica al responsable de la reversión (quién ejecuta la reversión si es necesario).
Despliegue
-
Inicia las nuevas instancias (o comienza la actualización gradual); no dirijas tráfico todavía.
-
Espera a que las sondas de disponibilidad superen la comprobación en todas las nuevas instancias.
-
Desplaza el tráfico inicial (1 % para un canario, o comienza el lote de la actualización gradual).
-
Supervisa la tasa de errores y la latencia p99 durante la primera ventana de evaluación.
-
Si las métricas son correctas, continúa desplazando el tráfico según la progresión del canario o el calendario de lotes de la actualización gradual.
-
Ejecuta una prueba sintética de humo contra la nueva versión con tráfico real.
Después del despliegue
-
Confirma que la tasa de errores y la latencia hayan vuelto a los valores de referencia en todas las instancias.
-
Verifica que los KPI empresariales (tasa de conversión, tasa de transacciones correctas) sean estables.
-
Mantén la versión anterior disponible para la reversión durante al menos un ciclo completo de tráfico.
-
Documenta cualquier anomalía observada durante el despliegue.
Reversión de emergencia
-
Actualización gradual de Kubernetes:
kubectl rollout undo deployment/my-app -
Azul/verde (AWS ALB):
aws elbv2 modify-listenerpara volver a apuntar al grupo de destino azul -
Enlace simbólico atómico:
ln -sfn releases/previous current && systemctl reload app -
Canario (desplazamiento del tráfico): Establece el peso del canario en el 0 % en el balanceador de carga o la malla de servicios
El responsable de la reversión ejecuta el comando correspondiente. El ingeniero de guardia notifica a los responsables de los servicios ascendentes y descendentes si se ve afectada una dependencia externa.
Gestión de dependencias de terceros y versionado de API externas
Las dependencias de terceros introducen un problema de compatibilidad de versiones que tu estrategia de despliegue por sí sola no puede resolver. Cuando actualizas una dependencia o cambias la forma de llamar a una API externa, las versiones antigua y nueva de tu aplicación pueden estar simultáneamente en producción durante una actualización gradual o un despliegue canario.
El enfoque práctico consiste en tratar las llamadas a API externas como contratos versionados. Fija la versión de la API en la configuración de tu cliente (/v2/endpoint en lugar de /latest) y mantén la compatibilidad con versiones anteriores en tus propias respuestas de API durante al menos un ciclo completo de despliegue. Si estás migrando de una versión de API externa a otra, utiliza la misma lógica de expansión y contracción que aplicas a los esquemas de base de datos: escribe simultáneamente en ambas versiones durante la transición y, después, cambia de forma limpia.
Para los SDK y las bibliotecas de terceros, fija las versiones de las dependencias en el manifiesto de tu paquete y prueba las actualizaciones de forma aislada antes de incluirlas en un despliegue de funcionalidades. Una actualización de dependencia que cambie el comportamiento es un despliegue independiente de la funcionalidad que la motivó. Agrupar ambos hace que la reversión sea ambigua.
Si un servicio de terceros tiene su propia ventana de mantenimiento planificada, coordina tu calendario de despliegues para evitar solapamientos. Un despliegue que coincida con la ventana de mantenimiento de un procesador de pagos es un ticket de soporte en potencia.
Compatibilidad hacia atrás y hacia delante en microservicios
En una arquitectura de microservicios, el despliegue sin tiempo de inactividad requiere que los servicios puedan comunicarse correctamente entre distintas versiones. Durante una actualización gradual, el Servicio A v2 puede llamar al Servicio B v1, o viceversa. Ambas combinaciones deben funcionar.
Compatibilidad hacia atrás significa que el código nuevo puede gestionar solicitudes de clientes antiguos. Consíguelo no eliminando ni cambiando el nombre de los campos de las respuestas de API sin un periodo de desuso, utilizando cambios exclusivamente aditivos (nuevos campos opcionales, nuevos endpoints) y versionando la API explícitamente.
Compatibilidad hacia delantesignifica que el código antiguo puede gestionar respuestas de servicios nuevos. Esto es más difícil. El enfoque más seguro consiste en diseñar consumidores que ignoren los campos desconocidos (patrón de lector tolerante) y evitar que los clientes antiguos dependan de la ausencia de campos nuevos.
Los esquemas de Protobuf y Avro hacen cumplir estos contratos en la capa de serialización, por lo que son habituales en entornos de microservicios de alta velocidad de desarrollo. Para las API REST, la validación de esquemas OpenAPI en el pipeline de CI detecta cambios incompatibles antes de que lleguen a producción.
Las pruebas de contratos impulsadas por el consumidor (con herramientas como Pact) permiten que cada consumidor defina lo que espera de un proveedor, y el pipeline de CI del proveedor verifica esos contratos en cada compilación. Esto detecta incompatibilidades antes de que se despliegue cualquier servicio, no durante una prueba canario en producción.
Reversión y recuperación ante desastres tras fallos de despliegue
Una estrategia de despliegue sin un plan de reversión probado está incompleta. Los comandos de reversión del manual anterior son la capa táctica. La capa estratégica consiste en asegurarse de que la reversión sea rápida, inequívoca y se haya practicado antes de necesitarla bajo presión.
Requisitos previos para la reversión:
-
La versión anterior debe estar disponible y poder desplegarse sin recompilar (conserva las dos últimas etiquetas de imágenes de contenedor o directorios de versiones)
-
Las migraciones de base de datos deben poder revertirse de forma independiente (o el esquema debe seguir siendo compatible con la versión anterior de la aplicación)
-
La reversión debe poder ejecutarla un único ingeniero sin bloqueos de aprobación durante un incidente activo
Consideraciones de recuperación ante desastres más allá de la reversión:
Si un despliegue corrompe datos (por ejemplo, una migración defectuosa escribe valores no válidos), revertir el código de la aplicación no corrige los datos. Aquí es donde importa el RPO: ¿cuánta pérdida de datos es aceptable y dispones de copias de seguridad de la base de datos en un momento dado con una granularidad que cubra la ventana de despliegue? Para la mayoría de los sistemas de producción, el archivado continuo de WAL (PostgreSQL) o el envío de registros binarios (MySQL) proporciona la granularidad necesaria para recuperar un estado anterior al despliegue.
Acompaña tu manual de despliegue con un plan de seguridad y respuesta ante incidentes que cubra los fallos de integridad de datos, no solo los fallos de disponibilidad. Los dos modos de fallo requieren rutas de recuperación diferentes.
Prueba el procedimiento de reversión en staging al menos una vez por trimestre. Una reversión que nunca has practicado tardará tres veces más cuando realmente la necesites.
Consideraciones de seguridad durante los despliegues sin tiempo de inactividad
La gestión de secretos es la brecha de seguridad más habitual en la automatización de despliegues. Cuando se inicia una nueva versión de tu aplicación, necesita credenciales: contraseñas de bases de datos, claves de API y certificados TLS. La forma en que esos secretos llegan a la nueva instancia determina tu postura de seguridad.
Nunca incluyas secretos en imágenes de contenedor ni en variables de entorno establecidas durante la compilación. Usa un gestor de secretos (AWS Secrets Manager, HashiCorp Vault, GCP Secret Manager) e inyecta los secretos en tiempo de ejecución mediante la capa de orquestación. Esto significa que una imagen comprometida no expone las credenciales y que rotar un secreto no requiere recompilar.
Durante un despliegue blue/green o progresivo, ambas versiones pueden ejecutarse simultáneamente con versiones de secretos diferentes. Si rotas una contraseña de base de datos a mitad del despliegue, las instancias antiguas perderán la conectividad. La secuencia segura es: rota los secretos antes de que comience el despliegue, verifica que las versiones antigua y nueva de la aplicación puedan autenticarse con las nuevas credenciales y, después, procede con el cambio de tráfico.
Revertir un parche de seguridad requiere una reflexión cuidadosa. Si reviertes el código de la aplicación que incluía una corrección de seguridad, vuelves a exponer la vulnerabilidad. La decisión de revertir debe sopesar la gravedad del incidente en producción frente a la gravedad de la regresión de seguridad. Para vulnerabilidades críticas (CVSS 9+), normalmente es preferible aplicar una corrección específica hacia delante que realizar una reversión completa. Documenta este árbol de decisión en tu manual antes de necesitarlo.
La rotación de certificados TLS durante un despliegue es otro caso límite. Si rotas certificados como parte de un despliegue, verifica que las versiones antigua y nueva de la aplicación confíen en el nuevo certificado antes de cambiar el tráfico. Un certificado en el que la versión antigua no confíe provocará fallos de conexión durante la ventana de transición.
Conclusiones clave
El principio más importante: elige la estrategia de despliegue más sencilla que cumpla tus SLO y presupuesto, e invierte en comprobaciones de salud, apagado ordenado y observabilidad antes de añadir complejidad de orquestación.
| Punto | Detalles |
|---|---|
| Empieza de forma sencilla | Los enlaces simbólicos atómicos o las actualizaciones progresivas satisfacen la mayoría de los SLO de producción sin la sobrecarga de los despliegues blue/green o canario. |
| Las migraciones de BD necesitan tres despliegues | Usa el patrón expand-contract: añade primero las columnas, escribe en ambas estructuras después y elimina las estructuras antiguas en tercer lugar; nunca agrupes los cambios de esquema y de código. |
| Automatiza los activadores de reversión | Establece umbrales de tasa de errores y límites de latencia; los flujos de promoción manuales anulan la velocidad y la seguridad que ofrecen las versiones canario. |
| La observabilidad lo condiciona todo | Sin métricas de latencia p99 y de tasa de errores que se actualicen en un plazo de 60 segundos, ninguna estrategia canario es segura para ejecutarse en producción. |
| Ridiculousengineering puede ayudarte | Ridiculousengineering diseña e implementa pipelines de CI/CD, observabilidad basada en SLO y manuales de migración de BD para equipos que necesitan prácticas de despliegue preparadas para producción. |
Ridiculousengineering puede auditar e implementar tu práctica de despliegue
Publicar sin tiempo de inactividad es un problema de ingeniería que se puede resolver, pero la solución es diferente para cada equipo según su stack, perfil de tráfico y tolerancia al riesgo. El desarrollo de software personalizadoLa práctica incluye trabajo práctico de automatización de despliegues: diseño de pipelines de CI/CD, configuración de observabilidad basada en SLO, manuales de migración de bases de datos y creación de runbooks para la respuesta ante incidentes. Tratamos tu entorno como algo único y recomendamos el enfoque más sencillo que cumpla tus objetivos, no el que suene más impresionante. Nuestros clientes obtienen procesos de despliegue repetibles, mejoras medibles en los SLO y un MTTR de incidentes menor. Si tu equipo está afrontando una migración complicada, la modernización de sistemas heredados o una primera implementación sin tiempo de inactividad, contacta con nosotros para definir un proyecto acotado y te diremos claramente cuál creemos que es el enfoque adecuado.
Preguntas frecuentes
¿Qué significa un despliegue sin tiempo de inactividad?
Un despliegue sin tiempo de inactividad consiste en publicar código nuevo de la aplicación en producción sin ninguna interrupción visible para el usuario: las solicitudes en curso se completan con normalidad, las tasas de error se mantienen estables y no se necesita ninguna ventana de mantenimiento.
¿Qué estrategias de despliegue consiguen cero tiempo de inactividad?
Las actualizaciones progresivas, los despliegues blue/green, las publicaciones canary, los cambios atómicos de enlaces simbólicos y los indicadores de funcionalidad consiguen cero tiempo de inactividad cuando se implementan con comprobaciones de estado adecuadas y un apagado ordenado. La elección correcta depende de tu infraestructura, el volumen de tráfico y los requisitos de reversión.
¿Cómo se despliega sin tiempo de inactividad cuando hay migraciones de bases de datos?
Utiliza el patrón expand-contract: añade primero las columnas nuevas como anulables, despliega código que escriba tanto en las estructuras antiguas como en las nuevas y, después, elimina las estructuras antiguas en un despliegue independiente. Nunca combines un cambio destructivo del esquema con un despliegue de código de la aplicación.
¿Cuál es el enfoque más sencillo para empezar con despliegues sin tiempo de inactividad?
Una actualización progresiva con maxUnavailable: 0 y maxSurge: 1, una sonda de disponibilidad en un endpoint /health y un hook de suspensión preStop para un apagado ordenado cubre la mayoría de los despliegues de producción con una sobrecarga de implementación mínima.
Fuentes útiles
| Fuente | Qué cubre |
|---|---|
| Google SRE Canary Workbook | Orientación autorizada sobre el dimensionamiento de canary, las barreras automatizadas y la lógica de promoción basada en SLO |
| Martin Fowler: CanaryRelease | Ensayo práctico sobre patrones canary, límites de versión y control del radio de impacto |
| Out Plane: Zero-Downtime Deployment Guide | Guía de implementación completa que abarca comprobaciones de estado, apagado ordenado y migraciones de bases de datos |
| DeployHQ: Zero Downtime Deployments | Guía práctica que incluye patrones de enlaces simbólicos atómicos y orientación sobre SLO/RTO/RPO |
| Kubernetes: Rolling Update Docs | Referencia oficial para maxUnavailable, maxSurge y los comandos de reversión |
| Wikipedia: Blue/Green Deployment | Definición canónica y notas de implementación específicas de cada plataforma (AWS, GCP, Azure, Kubernetes) |
| JetBrains: Canary Release Guide | Implementación de canary centrada en CI/CD con recomendaciones sobre barreras automatizadas |