Integración de Salesforce: guía de patrones, API y arquitectura
Integración de Salesforce: guía de patrones, API y arquitectura. El enfoque de integración de Salesforce adecuado depende de tres aspectos que debes definir antes de tocar una sola API: la intención de la integración (orquestación de procesos, sincronización de datos o acceso virtual/sin copia...
Integración de Salesforce: guía de patrones, API y arquitectura
El enfoque de integración de Salesforce adecuado depende de tres aspectos que debes definir antes de tocar una sola API: la intención de la integración (orquestación de procesos, sincronización de datos o acceso virtual/sin copia), el requisito de latencia (inferior a un segundo, casi en tiempo real o por lotes) y el volumen de datos. Para experiencias de cliente en tiempo real, los patrones basados en eventos mediante Platform Events o Change Data Capture suelen ser la opción adecuada. Para acceder a análisis y almacenes de datos sin crear una canalización de replicación, Data 360 sin copia merece una consideración seria. Para sincronizaciones entre organizaciones a gran escala, Bulk API con una capa de middleware como MuleSoft Anypoint gestiona la carga sin agotar tu presupuesto de API síncrona.
Antes de elegir una herramienta, completa esta lista de comprobación de cinco preguntas:
- Intención de la integración:¿Estás sincronizando datos, orquestando un proceso o federando el acceso a una fuente externa?
- Latencia necesaria:¿El negocio necesita una latencia inferior a un segundo, casi en tiempo real (menos de 15 minutos) o es aceptable un proceso nocturno por lotes?
- Volumen de datos:¿Estás moviendo cientos de registros o decenas de millones?
- Fuente única de la verdad:¿Qué sistema es el propietario de cada tipo de registro y cuál prevalece en caso de conflicto?
- Límites de la API:¿Cuál es el consumo actual de API de tu organización y cuánto margen tienes?
Consejo profesional: Mapea solo los flujos críticos para el negocio antes de elegir la tecnología. La trampa de que “todo sea en tiempo real” resulta cara y normalmente innecesaria: la mayoría de los procesos empresariales toleran perfectamente un retraso de 15 minutos, y tratarlos como problemas de streaming añade costes y complejidad sin ningún beneficio medible.
Conclusiones principales
Elegir el patrón de integración de Salesforce adecuado requiere definir la intención de la integración, el requisito de latencia y el volumen de datos antes de seleccionar cualquier API o herramienta.
| Aspecto | Detalles |
|---|---|
| Define primero la intención | Clasifica cada flujo como proceso, sincronización de datos o acceso virtual antes de elegir una API o herramienta. |
| Adapta la API al volumen | Usa REST para menos de aproximadamente 10.000 registros y llamadas interactivas; usa Bulk API 2.0 para cualquier volumen mayor. |
| Prioriza los eventos frente al sondeo | Platform Events y CDC propagan los cambios de forma eficiente; el sondeo desperdicia la cuota de API y añade latencia. |
| Usa Data 360 para acceder al almacén de datos | La federación sin copia consulta Snowflake, Databricks, Redshift y BigQuery sin canalizaciones de replicación. |
| Aplica el mínimo privilegio y la observabilidad | Limita estrictamente el alcance de los usuarios de integración, usa Named Credentials y configura alertas de uso de la API antes de la puesta en producción. |
| Ridiculous Engineering | Diseña y desarrolla arquitecturas de integración preparadas para producción, desde el diseño orientado a API hasta Data 360 sin copia y la sincronización entre organizaciones. |
Índice
- Qué abarca la integración de Salesforce en 2026
- Patrones de integración principales y cómo elegir entre ellos
- Qué API o funcionalidad de la plataforma Salesforce se adapta a cada tarea de integración
- Cuándo usar middleware, Data 360, Heroku Connect y conectores low-code
- Síncrono frente a asíncrono, basado en eventos frente a por lotes, entrante frente a saliente
- Mapeo de datos, transformaciones, resolución de identidades y fuente única de la verdad
- Aplicaciones conectadas, flujos de OAuth, permisos y gobernanza de integraciones
- Límites de API, antipatrones, reintentos, idempotencia y estrategias de procesamiento masivo
- Estrategia de pruebas, fases de lanzamiento y factores que determinan los plazos y el coste de la integración
- Lista de comprobación práctica y errores comunes que se deben evitar
- Cómo Ridiculous Engineering puede ayudarte con tu arquitectura de integración
- Fuentes
- Preguntas frecuentes
Qué abarca la integración de Salesforce en 2026
La integración de Salesforce es el plan arquitectónico y el conjunto de herramientas que utilizas para mover, acceder a datos y procesos, y coordinarlos entre Salesforce y otros sistemas. La definición parece sencilla, pero la plataforma se ha ampliado considerablemente y ahora las opciones abarcan un amplio espectro de objetivos, tiempos y complejidad técnica.
Tres objetivos de integración diferenciados impulsan la mayoría de los proyectos:
- Sincronización de datos: Replicar o sincronizar registros entre Salesforce y un sistema externo para que ambos se mantengan coherentes. Esto incluye ETL programado, sincronización incremental basada en CDC y herramientas declarativas como CRM Analytics SyncIn/SyncOut.
- Integración de procesos: Orquestar la lógica empresarial entre sistemas, activar flujos de trabajo y coordinar llamadas a API. MuleSoft Anypoint y los servicios REST personalizados de Apex pertenecen a esta categoría.
- Acceso virtual o sin copia: Consultar datos externos en tiempo de ejecución sin copiarlos a Salesforce. Salesforce Data 360 y Salesforce Connect son las principales opciones.
Entre las capacidades de la plataforma más importantes en 2026 se incluyen:
- API REST para operaciones CRUD y llamadas interactivas desde la web o dispositivos móviles
- API SOAP para integraciones con sistemas heredados basadas en WSDL y con tipado fuerte
- Bulk API 2.0 para cargas y extracciones de grandes volúmenes
- Streaming API y Pub/Sub API para la entrega de eventos de alto rendimiento
- Platform Events para mensajería desacoplada y duradera basada en eventos
- Change Data Capture (CDC) para notificaciones casi en tiempo real sobre cambios en los registros de Salesforce
- Salesforce Data 360 (Zero Copy) para acceder mediante consultas federadas a Snowflake, Databricks, Redshift y BigQuery
- Salesforce Connect para mostrar objetos externos sin replicarlos
- Heroku Connect para la sincronización bidireccional entre Salesforce y Heroku Postgres
- MuleSoft Anypoint para la gestión de API empresariales y la orquestación compleja
La disyuntiva fundamental que subyace a cada decisión: una menor latencia suele implicar una mayor complejidad y coste. La replicación ofrece consultas locales rápidas, pero crea riesgo de desincronización. La federación mantiene los datos actualizados, pero añade latencia en tiempo de consulta y dependencia de la disponibilidad del sistema externo. Comprender las opciones de estrategia de integración entre federación y replicación suele ser la primera decisión arquitectónica real de un proyecto.
Patrones de integración principales y cómo elegir entre ellos
Los patrones de arquitectura no son solo categorías académicas. Cada uno implica una carga de mantenimiento, una superficie de fallo y un modelo de gobernanza diferentes. Elegir el patrón equivocado al principio es uno de los errores más costosos que puede cometer un equipo.
Punto a punto conecta dos sistemas directamente. Es rápido de desarrollar y adecuado para una única integración estable y de bajo volumen. El problema es que escala mal: cinco sistemas con conexiones punto a punto suponen hasta diez superficies de integración que mantener, cada una con su propia autenticación, gestión de errores y acoplamiento de esquemas.
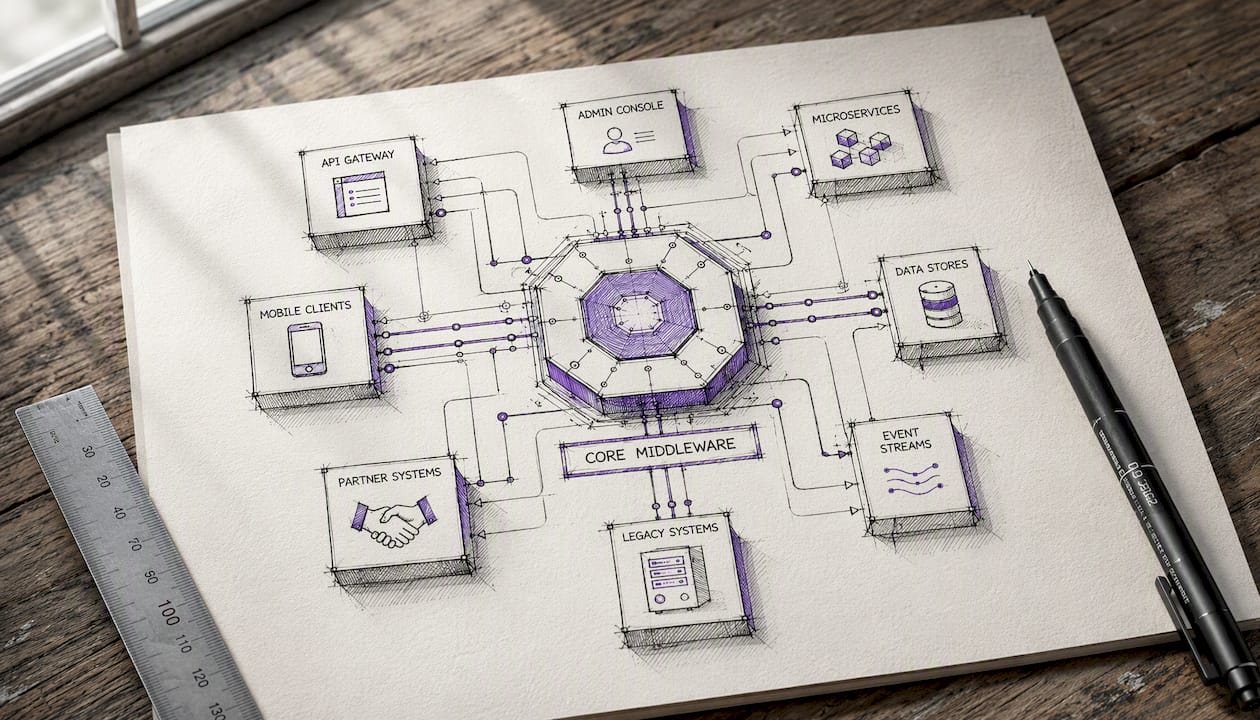
Hub y radios / middleware enruta todas las integraciones a través de una plataforma central. MuleSoft Anypoint es el ejemplo de referencia en el ecosistema de Salesforce. Cada sistema se conecta al hub, que gestiona la transformación, el enrutamiento y la gestión de errores. Este patrón es la opción adecuada cuando hay más de tres o cuatro sistemas intercambiando datos, cuando la gobernanza y la observabilidad son importantes o cuando se necesitan bibliotecas de conectores reutilizables.
Estilo ESB (bus de servicios empresariales) es una variante del modelo de hub y radios con mayor énfasis en la transformación de mensajes y la mediación de protocolos. Encaja en organizaciones con sistemas heredados heterogéneos que utilizan protocolos diferentes. La contrapartida es el peso operativo: los ESB requieren conocimientos especializados y pueden convertirse en cuellos de botella.
Conectividad basada en API organiza las integraciones en tres niveles: API de sistema (exponen los datos sin procesar de cada fuente), API de proceso (orquestan la lógica empresarial) y API de experiencia (adaptan las respuestas para consumidores específicos, como aplicaciones móviles o portales). La propia metodología de MuleSoft formaliza este patrón. Es el enfoque más fácil de mantener a escala empresarial porque cada nivel puede evolucionar de forma independiente.
Federación virtual o sin copia omite por completo la replicación. Salesforce Data 360 utiliza el envío de consultas al origen y modos de federación de archivos y consultas para consultar Snowflake, Databricks, Redshift y BigQuery en tiempo de ejecución. Salesforce Connect hace algo similar con los objetos externos, mostrándolos dentro de Salesforce sin almacenarlos. Este patrón es ideal cuando la actualización de los datos importa más que la velocidad de consulta y cuando el coste de mantener una canalización de replicación supera sus beneficios.
Utiliza esta lista de factores decisorios para elegir un patrón:
- Número de endpoints: Dos o tres sistemas → el punto a punto es suficiente. Cuatro o más → hub o basado en API.
- Volumen de eventos: Eventos de alta frecuencia (miles por hora) → arquitectura basada en eventos con Pub/Sub o Platform Events.
- Requisito de tiempo real: Menos de un segundo → API síncrona o streaming. Menos de 15 minutos → CDC o Platform Events. Nocturno → procesamiento por lotes/Bulk API.
- Equipo responsable: Equipo pequeño con conocimientos limitados de middleware → prioriza herramientas declarativas o conectores prediseñados. Equipo de integración dedicado → enfoque basado en API con MuleSoft.
- Necesidades de gobernanza: Sector regulado o requisitos de auditoría complejos → hub y radios o enfoque basado en API con observabilidad centralizada.
Consejo profesional: Empieza con servicios pequeños basados en API y bien delimitados para tus flujos de mayor valor. En topologías de sistemas de muchos a muchos, un hub se amortiza rápidamente al reducir la superficie de mantenimiento; el coste inicial de licencias y configuración casi siempre es menor que el coste a largo plazo de depurar una red de conexiones punto a punto.
Qué API de Salesforce o funcionalidad de la plataforma se adapta a cada tarea de integración
Elegir la API equivocada es una de las fuentes más habituales de deuda técnica en los proyectos de Salesforce. La plataforma ofrece varias familias de API, cada una optimizada para una forma de integración específica.
| API / Funcionalidad | Caso de uso más adecuado | Sincronización | Cuándo evitarla |
|---|---|---|---|
| REST API | CRUD, aplicaciones móviles/web, llamadas interactivas, menos de unos 10.000 registros | Síncrona | Cargas masivas grandes; agotará rápidamente los límites por organización |
| Bulk API 2.0 | Cargas o extracciones grandes (de decenas de miles a millones de filas) | Asíncrono | Necesidades de baja latencia; no es adecuado para tiempo real |
| API SOAP | Integraciones con ERP heredados, contratos WSDL fuertemente tipados | Síncrono | Proyectos nuevos; REST es más sencillo y cuenta con mejor compatibilidad |
| API de streaming / Pub/Sub | Entrega de eventos de alto rendimiento, notificaciones en tiempo real | Streaming | Casos de uso de bajo volumen; añade complejidad para necesidades sencillas |
| Eventos de plataforma | Mensajería desacoplada basada en eventos, activadores entre sistemas | Casi en tiempo real | Cuando el orden de entrega garantizado es fundamental |
| Captura de datos de cambios | Notificaciones de cambios casi en tiempo real en registros de Salesforce | Casi en tiempo real | Necesidades de sincronización de registros completos; CDC solo envía deltas a nivel de campo |
| Salesforce Connect | Exposición de objetos externos sin replicación | Virtual/en el momento de la consulta | Casos de uso con muchas escrituras; el sistema externo debe estar altamente disponible |
| Apex REST | Puntos de conexión personalizados con encapsulación de la lógica de negocio | Síncrono | CRUD estándar; añade sobrecarga de mantenimiento innecesariamente |
| API de herramientas / metadatos | Implementaciones, CI/CD, herramientas para desarrolladores | Asíncrono | Operaciones con datos de producción |
Para extracciones incrementales, Salesforce recomienda la API SOAP getUpdated/getDeleted para intervalos más largos, la mensajería saliente para una frecuencia moderada y la paginación o la API Bulk para grandes conjuntos de resultados. Combinar estrategias según el volumen y la frecuencia es el enfoque adecuado, no elegir un único mecanismo para todo.
La autenticación merece una atención específica. Para las integraciones de servidor a servidor, el flujo JWT Bearer es la opción correcta: no requiere interacción del usuario, admite procesos en segundo plano de larga duración y evita almacenar las credenciales de usuario en la capa de integración. El flujo OAuth de nombre de usuario y contraseña es práctico, pero conlleva un riesgo real: omite la MFA y está obsoleto en muchas configuraciones de organizaciones. Usa Credenciales con nombre para las llamadas salientes desde Salesforce a sistemas externos; centralizan la gestión de secretos y eliminan las credenciales codificadas directamente en el código Apex.
Para operaciones compuestas, la API Composite y la API Composite Graph permiten agrupar varias llamadas REST en una única solicitud HTTP, lo que reduce los viajes de ida y vuelta y el consumo de API. Esto resulta especialmente útil para flujos de trabajo de creación de registros que abarcan varios objetos relacionados.
Consejo profesional: Si un proceso de datos llega a superar las 50 000 filas, empieza desde el primer día con Bulk API 2.0. Adaptar a mitad del proyecto una integración síncrona basada en REST para gestionar volúmenes masivos resulta complicado y a menudo requiere reescribir por completo la capa de datos.
Cuándo usar middleware, Data 360, Heroku Connect y conectores low-code
Los guías de decisión de integración de Salesforce Architects relacionan claramente la selección de herramientas con cada caso de uso: MuleSoft Anypoint para la gestión y orquestación de API empresariales, Heroku Connect para la sincronización con tecnología PostgreSQL y Data 360 para datos armonizados y acceso basado en analítica. Así encaja cada herramienta en la práctica.
MuleSoft Anypoint es la opción adecuada cuando necesitas una gestión de API de nivel empresarial, una biblioteca reutilizable de conectores, orquestaciones complejas de varios pasos u observabilidad centralizada en muchas integraciones. Gestiona conexiones con ERP, mediación de protocolos heredados y administración del ciclo de vida de las API. La contrapartida son el coste de las licencias y los conocimientos necesarios para operarlo correctamente. Para un equipo sin experiencia con MuleSoft, la curva de aprendizaje es real.
Salesforce Data 360 (Zero Copy) permite consultar datos en Snowflake, Databricks, Redshift y BigQuery sin copiarlos a Salesforce, mediante el envío de consultas al origen y modos de federación de archivos y consultas. Es la herramienta adecuada cuando tus casos de uso de analítica o personalización necesitan datos actualizados del almacén y quieres evitar crear y mantener una canalización de replicación. No es la herramienta adecuada cuando necesitas escritura de vuelta en el almacén, acceso sin conexión o tiempos de respuesta de consulta inferiores a un segundo.
Heroku Connect proporciona sincronización bidireccional entre Salesforce y una base de datos Heroku Postgres. Está diseñada específicamente para equipos que ejecutan aplicaciones orientadas al cliente en Heroku y necesitan acceder a datos de Salesforce. La configuración es sencilla y gestiona la resolución de conflictos y la asignación de esquemas de forma declarativa. Evítala para sincronizaciones empresariales bidireccionales intensivas entre muchos objetos: se diseñó para el acceso desde la capa de aplicación, no como bus de integración de propósito general.
Salesforce Connect muestra objetos externos dentro de Salesforce en el momento de la consulta mediante OData o adaptadores personalizados. Los usuarios ven registros externos en Salesforce sin ninguna replicación. El inconveniente es que el sistema externo debe estar disponible cada vez que un usuario accede a esos registros, y las operaciones de escritura requieren que el sistema externo las admita. Encaja bien en escenarios de datos de referencia con muchas lecturas.
Conectores low-code (paquetes de AppExchange y conectores iPaaS prediseñados en herramientas como Workato o Boomi) son adecuados para integraciones puntuales rápidas y bien definidas cuando el conector ya existe y el modelo de datos es sencillo. Reducen el tiempo hasta obtener valor, pero pueden convertirse en un riesgo de gobernanza si se multiplican sin supervisión.
Para la sincronización de datos moderna, CRM Analytics SyncIn y SyncOut ofrecen opciones declarativas y low-code con sincronización incremental basada en CDC y seguimiento de eliminaciones definitivas, lo que evita las lagunas de conciliación que afectan a los enfoques ingenuos basados en sondeos.
Consejo profesional: Usa zero-copy de Data 360 cuando necesites acceso en el momento de la consulta a datos del almacén para personalización o analítica. Elimina toda una categoría de tareas de mantenimiento de canalizaciones y mantiene el almacén como fuente autorizada. En escenarios de comercio y pagos, los patrones de integración se extienden de forma natural a los flujos de procesamiento de pagos, donde la coherencia de los datos entre sistemas no es negociable.
Síncrono frente a asíncrono, basado en eventos frente a por lotes, entrante frente a saliente
Las decisiones sobre el modo y la dirección influyen en la experiencia del usuario y la fiabilidad del sistema más de lo que la mayoría de los equipos espera. Equivocarse significa tener una interfaz lenta que espera una llamada síncrona o un proceso empresarial que reacciona a datos obsoletos.
Síncronas Las integraciones bloquean el proceso que realiza la llamada hasta que llega una respuesta. Son adecuadas para operaciones orientadas al usuario y de baja latencia cuyo resultado debe estar disponible de inmediato, como la validación de una dirección durante el pago o la comprobación de crédito durante la cualificación de un posible cliente. El riesgo es que cualquier lentitud o fallo del sistema posterior deteriore directamente la experiencia del usuario.
Asíncronas Las integraciones se procesan en segundo plano. El emisor recibe una confirmación y continúa; el resultado llega después. Este es el modelo adecuado para la mayoría de los escenarios de sincronización de datos, notificaciones y activación de flujos de trabajo. Mejora la resiliencia porque una interrupción del sistema posterior no bloquea el flujo principal del usuario.
Basados en eventos Los patrones utilizan Platform Events, Change Data Capture o la API Pub/Sub para propagar los cambios a medida que ocurren. Platform Events son duraderos, desacoplados y admiten la reproducción. CDC se activa cuando cambian los registros de Salesforce y entrega diferencias a nivel de campo, lo que resulta mucho más eficiente que sondear cambios en registros completos. La API Pub/Sub gestiona flujos de gran rendimiento a escala. En escenarios de personalización del comercio, la activación de eventos casi en tiempo real puede generar un impacto medible en los ingresos cuando las señales de los clientes llegan rápidamente a los sistemas posteriores.
Por lotes Los patrones utilizan trabajos programados de Bulk API o canalizaciones ETL para mover grandes volúmenes según un calendario. Son rentables, predecibles y adecuados para cargas analíticas, cargas históricas y canalizaciones de informes en las que es aceptable una periodicidad nocturna o cada hora.
Entrante frente a saliente La dirección es importante para la autenticación, la gestión de errores y la propiedad:
- Externo → Salesforce (entrante): Los sistemas externos llaman a las API de Salesforce. Salesforce gestiona la autenticación mediante aplicaciones conectadas y OAuth. Los límites de velocidad se aplican en el lado de Salesforce.
- Salesforce → externo (saliente): Salesforce inicia las llamadas mediante callouts de Apex, mensajes salientes o Platform Events. Las credenciales con nombre gestionan la autenticación saliente.
- Sincronización entre organizaciones: Dos organizaciones de Salesforce intercambian datos. Los patrones de Data 360, las conexiones de Salesforce a Salesforce (S2S) o un hub de middleware son los enfoques habituales, según el volumen y las necesidades de gobernanza.
Consejo profesional: Prefiere los patrones basados en eventos para propagar cambios cuando las reglas de negocio deban reaccionar rápidamente —actualizaciones de inventario, asignación de clientes potenciales y escalado de casos—. Reserva las cargas por lotes para canalizaciones de análisis y rellenos históricos en los que unas horas de retraso no tengan consecuencias para el negocio.
Asignación de datos, transformaciones, resolución de identidades y fuente única de verdad
Una integración técnicamente correcta que asigne los campos equivocados o resuelva las identidades de forma incoherente corromperá tus datos de CRM más rápido que cualquier error. Aquí es donde la mayoría de los proyectos de integración acumulan una deuda silenciosa y costosa.
Las decisiones de asignación a nivel de campo deben responder a tres preguntas: cuál es el tipo de datos canónico en cada sistema, dónde se realiza la transformación y quién es el propietario del campo en caso de conflicto. Transformar en el origen mantiene delgada la capa de integración, pero la acopla a los cambios del esquema de origen. Transformar en el middleware (MuleSoft o un servicio personalizado) centraliza la lógica, pero añade una capa que mantener. Transformar dentro de Salesforce mediante Apex o Flow funciona en casos sencillos, pero puede crear problemas de rendimiento con grandes volúmenes.
La resolución de identidades es el problema más difícil. Cuando existe un registro de cliente en Salesforce, tu ERP y tu almacén de datos, necesitas una forma fiable de asociarlos. Las opciones van desde la coincidencia determinista mediante una clave compartida (correo electrónico o número de cuenta) hasta la coincidencia probabilística mediante el motor de resolución de identidades de Data 360, que gestiona coincidencias aproximadas entre fuentes de datos. Para la mayoría de las integraciones B2B, un campo de ID externo en el objeto de Salesforce es el punto de partida adecuado: almacena la clave principal del sistema de origen y permite realizar operaciones upsert sin una búsqueda previa.
Las decisiones sobre la fuente única de verdad son arquitectónicas, no técnicas. Decide qué sistema es propietario de cada tipo de registro antes de construir nada. Salesforce puede ser propietario de la Cuenta y el Contacto, mientras que tu ERP puede serlo del Pedido y la Factura. Cuando ambos sistemas pueden escribir en el mismo campo, necesitas una regla de resolución de conflictos —gana la última escritura, gana el sistema de origen o una estrategia de combinación— y esa regla debe aplicarse de forma coherente.
La deriva del esquema es inevitable. Los sistemas externos cambian sus modelos de datos, las versiones de Salesforce añaden o retiran campos y las asignaciones de integración quedan obsoletas. Entre las medidas de mitigación se incluyen:
- Pruebas de contrato que validen la estructura de las respuestas de la API frente a un esquema definido en cada despliegue
- Validación automatizada de asignaciones que avise cuando un campo de origen desaparezca o cambie de tipo
- Un flujo de trabajo documentado para la gestión de cambios que exija a los responsables de integración aprobar los cambios de esquema antes de que lleguen a producción
Consejo profesional: Define tu estrategia de ID externo durante la fase de descubrimiento y aplícala mediante reglas de validación y monitorización desde el primer día. Adaptar la resolución de identidades después de haber cargado datos desde varios sistemas sin una clave compartida es uno de los problemas de conciliación más laboriosos de las operaciones de CRM.
Aplicaciones conectadas, flujos de OAuth, permisos y gobernanza de integraciones
La seguridad en las integraciones de Salesforce no consiste solo en elegir el flujo de OAuth adecuado. Consiste en diseñar un sistema en el que cada superficie de integración sea auditable, tenga los privilegios mínimos y pueda mantenerse con el tiempo.
Prácticas recomendadas de autenticación:
- Usa el flujo JWT Bearer para las integraciones de servidor a servidor. Admite autenticación no interactiva, funciona con certificados y no requiere almacenar credenciales de usuario.
- Evita el flujo de OAuth de nombre de usuario y contraseña. Omite la autenticación multifactor, está obsoleto en muchas configuraciones de organizaciones y crea un problema de gestión de credenciales.
- Usa Credenciales con nombre para todas las llamadas salientes desde Salesforce. Almacenan las credenciales de forma segura en la plataforma, admiten la renovación automática de tokens y eliminan los secretos codificados en Apex.
Autorización y privilegios mínimos:
- No uses nunca un perfil de Administrador del sistema para un usuario de integración. Crea un usuario de integración específico con un perfil personalizado limitado exactamente a los objetos y campos que necesita la integración.
- Usa la seguridad a nivel de campo para restringir el acceso a campos sensibles (número de la Seguridad Social, datos de pago e información sanitaria), incluso cuando se hayan concedido permisos a nivel de objeto.
- Para patrones de acceso agéntico o basados en IA, las prácticas recomendadas para servidores MCP alojados aconsejan servidores SObject con permisos delimitados, consultas con nombre y anotaciones precisas de las herramientas, en lugar de crear envoltorios de API personalizados que eludan la gobernanza de la plataforma.
Auditoría, monitorización y observabilidad:
- Activa los paneles de uso de la API y configura alertas para detectar picos de consumo inusuales. Un aumento repentino de diez veces en las llamadas a la API suele ser la primera señal de una integración descontrolada o de un bucle de reintentos mal configurado.
- Registra la telemetría a nivel de solicitud para todas las llamadas de integración: marca de tiempo, sistema de origen, objeto de destino, cantidad de registros y estado de la respuesta. Estos datos son inestimables para depurar incidentes en producción.
Barreras de gobernanza:
- Trata la superficie de tu API como un producto. Documéntala, versiona sus cambios y define un periodo de retirada antes de eliminar o modificar cualquier endpoint del que dependa un consumidor posterior.
- Exige pruebas de contrato para cada API externa que consuma tu integración. Cuando el sistema externo cambie su esquema, tu canal de CI/CD debe detectarlo antes de que llegue a producción.
Consejo profesional: Centraliza los secretos en Credenciales con nombre o en un gestor de secretos y rótalos periódicamente. Las integraciones con mayor probabilidad de provocar un incidente de seguridad son aquellas en las que las credenciales se codificaron “temporalmente” hace dos años y nunca volvieron a revisarse.
Límites de API, antipatrones, reintentos, idempotencia y estrategias de procesamiento masivo
Los límites de la plataforma no son sugerencias. Salesforce aplica cuotas de llamadas a la API por organización, límites de entrega de eventos y límites de concurrencia de la Bulk API. Los equipos que no planifican los límites antes de la puesta en producción suelen descubrirlos en el peor momento posible.
El antipatrón más común es la excesiva comunicación: realizar una llamada síncrona a la API por cada registro en un proceso de gran volumen. Un flujo que ejecuta una llamada REST por cada uno de los 10.000 registros procesados en un lote agotará tu cuota diaria de API y probablemente agotará el tiempo de espera. La solución es agrupar: agrega los registros, usa la Composite API para combinar varias operaciones por solicitud o cambia a Bulk API 2.0 para todo el trabajo.
La propagación síncrona es un problema relacionado. Cuando un único activador de Salesforce realiza llamadas salientes secuenciales a tres sistemas externos, la latencia total se acumula y cualquier fallo puede bloquear toda la transacción. Desacopla estas llamadas mediante Platform Events o una capa de middleware basada en colas.
Patrones de gestión de errores que realmente funcionan:
- Retroceso exponencial con fluctuación aleatoria en los reintentos. Cuando un sistema posterior limita el tráfico o no está disponible temporalmente, reintentar de inmediato a máxima velocidad agrava el problema. Añade un retraso aleatorio entre los reintentos.
- Operaciones idempotentes. Diseña cada operación de escritura de modo que ejecutarla dos veces produzca el mismo resultado que ejecutarla una vez. Usa ID externos y operaciones upsert en lugar de patrones de insertar y actualizar después.
- Gestión de colas de mensajes no entregados. Los eventos fallidos que no puedan procesarse después de N reintentos deben llegar a una cola o tabla de mensajes no entregados para su revisión manual, no desaparecer silenciosamente.
Para conjuntos de resultados grandes, pagina mediante queryMore para consultas SOQL y usa el modelo basado en trabajos de Bulk API para las extracciones. La guía de buenas prácticas de Salesforce para grandes volúmenes de datos recomienda getUpdated/getDeleted para extracciones incrementales basadas en SOAP y Bulk API para escenarios de carga completa de gran volumen; combinar estrategias según el volumen es más eficiente que aplicar un único enfoque de forma universal.
Implementar un retroceso exponencial con jitter es una práctica recomendada documentada para evitar tormentas de reintentos que conviertan los eventos de limitación en interrupciones prolongadas.
Consejo profesional: Instrumenta el uso de tu API desde el primer día en producción y configura alertas al 70% de tu cuota diaria. Reaccionar después de superar el límite implica tiempo de inactividad. Detectar la tendencia con antelación te da tiempo para optimizar antes de que los usuarios noten nada.
Estrategia de pruebas, etapas del lanzamiento y factores que determinan los plazos y el coste de la integración
Los proyectos de integración fallan en producción con más frecuencia que los proyectos de aplicaciones porque los modos de fallo están distribuidos entre los sistemas y la mayoría de los equipos no prueban suficientemente los límites entre ellos.
Lista de comprobación de pruebas:
- Pruebas de contrato: Valida que la estructura de cada respuesta de API externa coincida con las expectativas de tu integración. Ejecútalas en CI/CD con cada implementación.
- Pruebas de integración: Prueba el recorrido completo de ida y vuelta entre los sistemas en un entorno aislado con volúmenes de datos representativos.
- Escenarios de extremo a extremo: Recorre el proceso empresarial desde el desencadenante hasta el resultado en todos los sistemas conectados, incluidas las rutas de error.
- Validación de la carga histórica: En proyectos de sincronización de datos, valida que los registros históricos cargados mediante Bulk API coincidan con el sistema de origen en los campos y recuentos clave.
- Pruebas de carga: Simula el volumen máximo para confirmar que te mantienes dentro de los límites de la API y que la latencia cumple los requisitos del SLA.
Etapas del lanzamiento:
- Prototipo en un entorno aislado: Valida la conexión de la API, el flujo de autenticación y la asignación básica de datos. Esto debería llevar días, no semanas.
- Piloto en un entorno aislado completo: Ejecuta la integración con un conjunto de datos representativo y escenarios empresariales reales. Involucra a los usuarios finales.
- Lanzamiento gradual en producción: Habilítalo primero para un subconjunto de registros o usuarios. Supervisa el consumo de la API, las tasas de error y la calidad de los datos antes del cambio completo.
- Plan de supervisión y reversión: Define cómo sería una reversión antes de entrar en producción. En las integraciones de sincronización de datos, esto implica saber cómo revertir los registros y detener la sincronización sin corromper ambos sistemas.
Factores que determinan el plazo y el coste:
- Alcance de los objetos y las transformaciones: Una sincronización de un solo objeto con una asignación sencilla puede completarse en días con un conector prediseñado. Una integración de varios objetos y sistemas con una lógica de transformación compleja puede tardar de semanas a meses.
- Requisitos de volumen y SLA: Las integraciones de gran volumen y baja latencia requieren más infraestructura, más pruebas y una gestión más cuidadosa de los límites.
- Aprobaciones de seguridad y cumplimiento: Las industrias reguladas añaden semanas para la revisión de seguridad, las pruebas de penetración y la aprobación de cumplimiento.
- Licencias: MuleSoft Anypoint y Data 360 tienen costos de licencia significativos que deben incluirse en el caso de negocio desde el principio.
Vincular la adopción tecnológica con resultados empresariales medibles es lo que distingue los proyectos de integración que reciben financiación de aquellos que se estancan en compras.
Consejo práctico: Desarrolle primero la integración mínima viable para su flujo de mayor valor. Esto valida sus supuestos de arquitectura, pone de manifiesto la complejidad real desde el principio y proporciona a las partes interesadas algo funcional sobre lo que reaccionar, lo que resulta mucho más útil que un plan detallado para algo que nunca se ha ejecutado en producción.
Lista de comprobación práctica y errores habituales que conviene evitar
Esta lista de comprobación está organizada por fases. Utilícela para validar las decisiones de arquitectura y detectar las trampas habituales antes de que se conviertan en incidentes de producción.
Fase de descubrimiento:
- [ ] Intención de la integración definida (proceso, sincronización de datos o acceso virtual) para cada flujo
- [ ] Propiedad de los datos documentada: qué sistema es la fuente autorizada para cada tipo de registro
- [ ] Estimaciones de volumen confirmadas: registros máximos por hora, totales diarios y proyecciones de crecimiento
- [ ] Margen disponible de los límites de la API evaluado en relación con el consumo actual de la organización
- [ ] SLA de latencia acordado con las partes interesadas del negocio para cada flujo
Fase de diseño:
- [ ] API seleccionada según el volumen y la latencia (REST, Bulk, Streaming, CDC)
- [ ] Flujo de autenticación elegido (se prefiere JWT Bearer para servidor a servidor)
- [ ] Estrategia de identificadores externos definida y documentada
- [ ] Estrategia de gestión de errores y reintentos diseñada (espera progresiva, idempotencia, cola de mensajes fallidos)
- [ ] Proceso de cambios de esquema y enfoque de pruebas de contrato acordados
Fase de desarrollo:
- [ ] Se utilizan Credenciales con nombre para toda la autenticación saliente; no hay secretos codificados directamente
- [ ] Lógica de reintentos implementada con espera progresiva exponencial y variación aleatoria
- [ ] Todas las operaciones de escritura se diseñan como actualizaciones idempotentes cuando es posible
- [ ] La supervisión y las alertas se configuran antes de la puesta en producción, no después
- [ ] Usuario de integración creado con un perfil de privilegios mínimos
Fase de operaciones:
- [ ] Alertas de uso de la API configuradas al 70 % de la cuota diaria
- [ ] Proceso de notificación de cambios de esquema establecido para todas las API externas consumidas
- [ ] Manual de operaciones de integración redactado para cada flujo de producción (responsable, SLA, pasos de reversión, contactos de escalado)
- [ ] Supervisión de costes implementada para el middleware con licencia y el consumo de Data 360
Errores habituales:
- Usuarios de integración con privilegios excesivos y perfiles de administrador del sistema
- Sondear los cambios en lugar de utilizar CDC o Platform Events
- Tratar todos los flujos como tiempo real cuando el negocio puede tolerar un retraso de 15 minutos
- Telemetría insuficiente, lo que hace casi imposible diagnosticar incidentes de producción
- Subestimar la deriva del esquema de los sistemas externos en un horizonte de 12 meses
Conectar plataformas modernas con sistemas heredados añade otra capa de complejidad que merece atención arquitectónica propia; los patrones de integración con sistemas heredados suelen diferir considerablemente de los enfoques de API diseñados desde cero.
Consejo práctico: Exige un manual operativo de integración de una página para cada flujo de producción antes de ponerlo en marcha. Debe responder a cuatro preguntas: ¿quién es el responsable de este flujo?, ¿cuál es el SLA?, ¿cuáles son los pasos para revertirlo? y ¿a quién llamas a las 2 de la madrugada cuando falla? Si no puedes responder a esas preguntas, la integración no está lista para producción.
Cómo puede ayudar Ridiculous Engineering con tu arquitectura de integración
Ridiculous Engineering diseña y desarrolla integraciones de Salesforce listas para producción para organizaciones que necesitan algo más que un conector prediseñado y un fin de semana. El trabajo abarca desde el diseño de arquitecturas basadas en API y la implementación de MuleSoft hasta la planificación sin copia de Data 360, la estrategia de sincronización entre organizaciones y el soporte continuo de integraciones.
El momento adecuado para contar con un equipo experimentado es cuando el alcance entra en territorio empresarial: varios sistemas, lógica de transformación compleja, datos regulados o un modelo de gobernanza que debe mantenerse durante años de versiones de Salesforce. Una arquitectura de integración mal diseñada es una de las cosas más caras de corregir después.
Lo que los clientes suelen obtener de un proyecto inicial con Ridiculous Engineering:
- Un documento de arquitectura de integración que mapea flujos, API, patrones y propiedad de los datos
- Una estrategia de resolución de identidades y de identificadores externos
- Una revisión de seguridad y autenticación que cubre aplicaciones conectadas, flujos de OAuth y credenciales con nombre
- Una implementación piloto del flujo de mayor valor, con supervisión completa y manual operativo
- Un plan de despliegue con lista de comprobación de pruebas y procedimientos de reversión
Si tu equipo está planificando un proyecto sin copia de Data 360, una sincronización entre organizaciones o una estrategia de API empresarial y necesita un socio de arquitectura con experiencia, empieza con una conversación sobre lo que quieres crear. La llamada de descubrimiento es donde se toman las verdaderas decisiones arquitectónicas.
Fuentes
Documentación oficial de Salesforce y guías de decisiones arquitectónicas que respaldan las recomendaciones de este artículo:
- Extracción de datos y buenas prácticas para grandes volúmenes de datos | Salesforce Developers
- Data Cloud: conectividad sin copia | Salesforce
- Integración de datos con Salesforce | Guías de decisiones de integración
Siguientes pasos recomendados: Revisa el uso actual de las API de tu organización en Configuración → Uso de API, crea un prototipo de un flujo mínimo en un sandbox completo utilizando la API que corresponda a tu volumen y ejecuta la lista de comprobación de descubrimiento de este artículo antes de tu próxima revisión de arquitectura.
Preguntas frecuentes
¿Qué es la integración con Salesforce?
La integración con Salesforce es el proceso de conectar Salesforce con otros sistemas para compartir datos, activar procesos o proporcionar acceso virtual a registros externos. Abarca API, plataformas de middleware, mecanismos basados en eventos y herramientas de federación sin copia.
¿Con qué se puede integrar Salesforce?
Salesforce se integra prácticamente con cualquier sistema que exponga una API o admita formatos de datos estándar, incluidos ERP como SAP y Oracle, almacenes de datos como Snowflake y Databricks, plataformas de marketing, procesadores de pagos y aplicaciones personalizadas. Las herramientas nativas como MuleSoft Anypoint, Heroku Connect y Data 360 sin copia cubren los escenarios de integración empresarial más habituales.
¿Cuánto cuesta integrar Salesforce?
El coste varía considerablemente. Una integración sencilla con un conector prediseñado puede configurarse en unos días con un coste mínimo. Una integración empresarial que incluya MuleSoft Anypoint, Data 360 sin copia y orquestación de varios sistemas puede costar desde decenas de miles hasta cientos de miles de dólares cuando se incluyen las licencias, la arquitectura, el desarrollo y el soporte continuo. Los principales factores de coste son el volumen de datos, la complejidad de las transformaciones, los requisitos de latencia y las aprobaciones de seguridad y cumplimiento.
¿Cómo elijo el enfoque de integración de Salesforce adecuado?
Empieza por la finalidad de la integración (proceso, sincronización de datos o acceso virtual), el requisito de latencia y el volumen de datos. Utiliza REST para llamadas interactivas de bajo volumen; Bulk API 2.0 para cargas grandes; Platform Events o CDC para la propagación de cambios basada en eventos; y Data 360 sin copia para acceder a análisis y almacenes de datos sin replicación. El proceso de revisión arquitectónica de Ridiculous Engineering relaciona estas decisiones con tus sistemas y requisitos empresariales específicos.
¿Cuáles son los errores más comunes en las integraciones de Salesforce?
Los problemas más frecuentes son los usuarios de integración con privilegios excesivos, consultar periódicamente los cambios en lugar de utilizar CDC o Platform Events, tratar todos los flujos como tiempo real cuando el negocio puede tolerar un retraso, una supervisión insuficiente y subestimar la deriva del esquema de los sistemas externos con el paso del tiempo.