Optimización de costes de Kubernetes: una guía de DevOps para 2026
Optimización de costes de Kubernetes: una guía de DevOps para 2026 La optimización de costes de Kubernetes es la práctica de reducir el desperdicio de infraestructura en la nube manteniendo la fiabilidad mediante el ajuste adecuado de recursos, la automatización del escalado y el uso de opciones de computación con descuento.
Optimización de costes de Kubernetes: una guía de DevOps para 2026
La optimización de costes de Kubernetes es la práctica de reducir el desperdicio de infraestructura en la nube manteniendo la fiabilidad mediante el ajuste adecuado de recursos, la automatización del escalado y el uso de opciones de computación con descuento. El problema central es estructural: Las facturas de Kubernetes se basan en las solicitudes de recursos de los pods, no en el uso real, por lo que los clústeres siguen siendo caros incluso durante períodos de tráfico bajo. La utilización media de la CPU en los clústeres de producción es de solo 8–12 % de la capacidad provisionada, lo que significa que la mayoría de los equipos pagan por capacidad de computación inactiva cada hora de cada día. La buena noticia es que los equipos que aplican estrategias de ajuste adecuado, escalado automático e instancias Spot logran consistentemente reducciones del 30–60 % en los gastos de Kubernetes, y muchos ven ahorros significativos ya en el primer mes.
¿Cómo impulsa el ajuste adecuado de las solicitudes de recursos de los pods el ahorro de costes en Kubernetes?
El ajuste adecuado es la palanca más poderosa en cualquier esfuerzo de reducción de costes. Kubernetes agenda los pods en función de sus recursos solicitados, no de lo que realmente consumen. Un pod que solicita 2 núcleos de CPU reserva esa capacidad en un nodo, independientemente de si utiliza 0,2 núcleos en tiempo de ejecución. Esta brecha entre las solicitudes y el uso real es donde se esconde la mayor parte del desperdicio presupuestario.
La solución práctica es establecer las solicitudes en el percentil 99 del uso histórico más un margen del 20 %. Una o dos semanas de supervisión proporcionan suficiente información para identificar la diferencia entre lo que solicitan los pods y lo que realmente consumen. Esa diferencia suele ser una sobreestimación de 3 a 8 veces, lo que significa que su clúster podría funcionar con una fracción de su número actual de nodos.
Prácticas clave para un ajuste adecuado seguro:
-
Auditar primero. Extraiga las métricas de uso reales de Prometheus o la supervisión nativa de su proveedor de la nube ’ antes de cambiar cualquier solicitud.
-
Utilice el Autoscaler Vertical de Pods (VPA) en modo de recomendación. El VPA analiza el uso histórico y sugiere valores ajustados adecuadamente sin aplicarlos automáticamente, lo que le da control antes de confirmar.
-
Establezca los límites de memoria con cuidado. Los eventos de OOMKill de memoria provocan la caída de los pods, por lo que mantenga los límites de memoria ligeramente por encima de las solicitudes en lugar de igualarlos.
-
Evite establecer las solicitudes de CPU iguales a los límites de CPU. El estrangulamiento de CPU bajo los límites provoca picos de latencia sin hacer caer el pod, lo que dificulta su detección.
-
Iterar primero en entornos de preparación. Aplique los nuevos valores de solicitud a las cargas de trabajo no productivas, mida la estabilidad durante una semana y luego despliegue en producción.
Los resultados del mundo real validan este enfoque. Los estudios de caso muestran facturas mensuales que caen de 52 000 $ a 23 000 $ y de 85 000 $ a 34 000 $ en unos pocos meses combinando el ajuste adecuado con el escalado automático. Los ahorros no son teóricos.
Consejo profesional: Nunca establezca las solicitudes de CPU iguales a los límites de CPU en producción. El estrangulamiento es silencioso y degrada el rendimiento sin activar alertas, lo que lo convierte en una de las causas ocultas más comunes de latencia en las cargas de trabajo de Kubernetes.
¿Qué estrategias de escalado automático optimizan la elasticidad de la carga de trabajo?
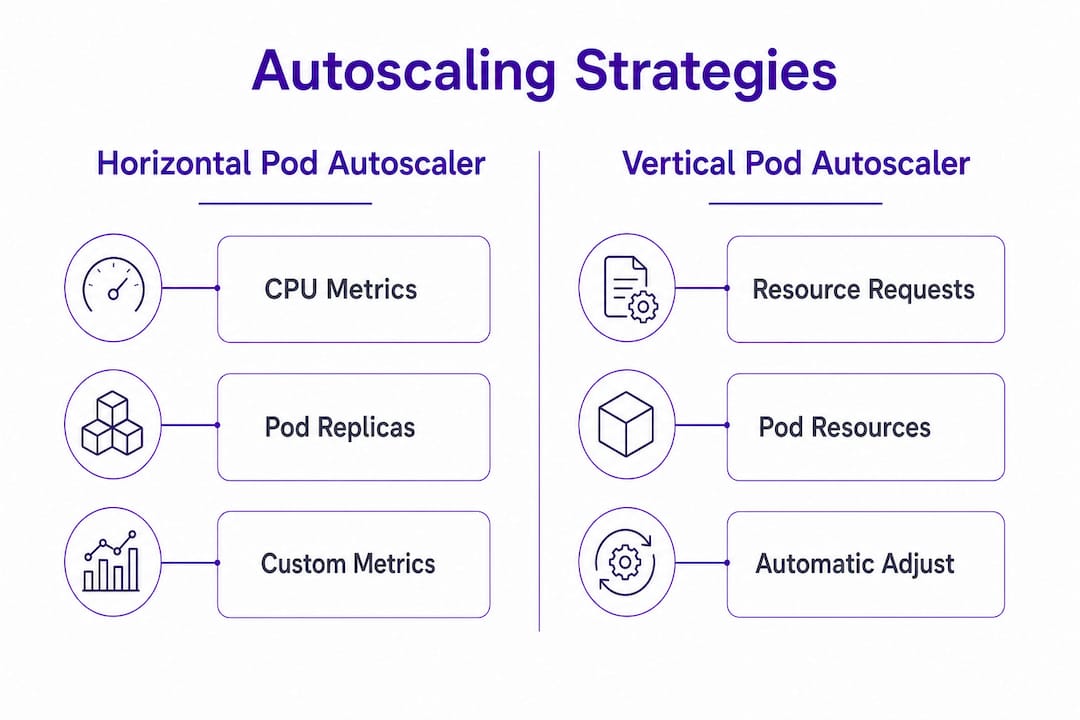
La asignación estática de recursos es enemiga de la eficiencia de costes. El escalado automático reemplaza la capacidad fija con una capacidad dinámica que sigue la demanda real. Tres herramientas cubren toda la gama de necesidades de escalado: el Autoscaler Horizontal de Pods (HPA), el Autoscaler Vertical de Pods (VPA) y KEDA (Autoscaler impulsado por eventos de Kubernetes).
El HPA escala horizontalmente los réplicas de los pods en función de la CPU o de métricas personalizadas. El VPA ajusta verticalmente las solicitudes de recursos de los pods individuales con el tiempo. KEDA extiende el HPA para admitir el escalado impulsado por eventos desde fuentes como Kafka, SQS o colas de solicitudes HTTP y, lo que es más importante, admite el escalado a cero para cargas de trabajo que pueden tolerar arranques en frío. Separar las responsabilidades entre estas tres herramientas ofrece a los equipos un control preciso: el VPA se encarga del dimensionamiento de la memoria, el HPA de los recuentos de réplicas impulsados por la CPU y KEDA de los patrones de ráfaga e inactividad impulsados por eventos.
La aprovisionamiento de nodos es donde aparecen los mayores ahorros de infraestructura. Karpenter reduce el desperdicio de computación entre un 15–30 % en comparación con el antiguo Cluster Autoscaler seleccionando dinámicamente los tipos de instancia más rentables entre miles de opciones. Karpenter también admite la consolidación automatizada de nodos, que empaqueta cargas de trabajo en menos nodos y termina los subutilizados. Este es el mecanismo detrás de las mayores reducciones de costes documentadas. Para los equipos que gestionan eventos de escalado de alto tráfico, combinar Karpenter con HPA crea un sistema que escala rápidamente hacia fuera y se reduce agresivamente.
Buenas prácticas de escalado automático que vale la pena implementar inmediatamente:
-
Configure las ventanas de estabilización de reducción de escala del HPA a 5–10 minutos en lugar de los 5 minutos predeterminados para evitar fluctuaciones, pero configure el aumento de escala para que responda en 60 segundos.
-
Utilice las políticas de consolidación de Karpenter para reemplazar automáticamente los nodos de tamaño excesivo por otros más pequeños y baratos durante los períodos de baja demanda.
-
Configure los desencadenantes de KEDA para escalar los trabajos por lotes a cero entre ejecuciones, eliminando por completo los costes de pods inactivos.
Consejo profesional: Configure el HPA con un comportamiento agresivo de reducción de escala estableciendo scaleDown.stabilizationWindowSeconds en 300 y percentPod políticas para eliminar el 50 % de los pods excedentes por minuto. Solo esto puede reducir los costes de computación fuera de pico entre un 20–40 % para cargas de trabajo variables.
¿Cómo pueden las instancias Spot y los cambios de arquitectura amplificar los ahorros?
Las decisiones a nivel de infraestructura multiplican los ahorros del ajuste adecuado y el escalado automático. Las instancias Spot ofrecen ahorros del 60–90 % sobre la tarifa bajo demanda, lo que las convierte en la palanca de precios más impactante disponible. El inconveniente es el riesgo de interrupción. Las instancias Spot pueden ser reclamadas por el proveedor de la nube con dos minutos ’ de antelación, por lo que la selección de la carga de trabajo es importante.
Las cargas de trabajo sin estado, los trabajos por lotes y los ejecutores de CI/CD son candidatos ideales para Spot. Las cargas de trabajo con estado, las bases de datos y cualquier cosa que requiera conexiones persistentes deben permanecer en nodos bajo demanda. Implemente Spot de forma segura combinando presupuestos de interrupción de pods con tolerancias de nodo que apunten a grupos de nodos Spot. Karpenter maneja la conmutación por error a Spot automáticamente, cambiando a bajo demanda cuando la capacidad Spot no está disponible.
| Optimización | Ahorros estimados | Complejidad de implementación |
|---|---|---|
| Instancias Spot (cargas de trabajo sin estado) | 60–90 % en computación elegible | Media |
| Procesadores ARM Graviton | ~20 % de reducción de costes | Baja a media |
| Migración de volúmenes EBS gp3 | ~20 % de reducción de costes de almacenamiento | Baja |
| Controladores de entrada consolidados | Variable, reduce el número de equilibradores de carga | Baja |
| Puntos finales de VPC de pasarela NAT | Reduce los cargos por transferencia de datos | Baja |
La migración a instancias Graviton basadas en ARM ofrece aproximadamente un 20 % menos de costes con un rendimiento comparable o mejor para la mayoría de las cargas de trabajo. Karpenter puede apuntar a Graviton automáticamente cuando especifica ARM como arquitectura preferida en la configuración de su NodePool. La migración de gp2 a volúmenes EBS gp3 reduce los costes de almacenamiento aproximadamente un 20 % sin tiempo de inactividad, ya que la migración se produce en línea. Estos son cambios de bajo esfuerzo con rendimientos garantizados.
Los costes de red suelen pasarse por alto. Los cargos por transferencia de datos de la pasarela NAT se acumulan rápidamente en clústeres con un egress intenso. Añadir puntos finales de VPC para servicios como S3 y ECR enruta el tráfico de forma privada, evitando por completo la NAT. Consolidar varios controladores de entrada en un único controlador compartido también reduce el número de equilibradores de carga de la nube provisionados, lo que reduce directamente los costes fijos mensuales.
¿Qué prácticas de gobernanza mantienen la optimización de costes de Kubernetes?
Las optimizaciones técnicas se deterioran sin gobernanza. Los equipos vuelven a la sobreprovisión cuando no hay visibilidad sobre quién es responsable de qué gasto. La asignación de costes mediante showback y chargeback ofrece a los equipos de ingeniería una visión directa del coste de sus cargas de trabajo, lo que cambia el comportamiento de forma más fiable que cualquier documento de política.
La base es una etiquetado consistente. Cada espacio de nombres, implementación y volumen persistente debe llevar etiquetas de equipo, entorno y centro de costes. El cumplimiento del etiquetado con controladores de admisión como OPA Gatekeeper o Kyverno evita que se creen recursos sin etiquetar desde el principio. Sin cumplimiento, la cobertura de etiquetas se degrada con el tiempo a medida que los equipos avanzan rápido y omiten las etiquetas.
Prácticas de gobernanza que mantienen los ahorros:
-
Realice revisiones semanales de costes utilizando OpenCost o Kubecost para mostrar tendencias de gasto a nivel de espacio de nombres.
-
Establezca alertas de presupuesto a nivel de espacio de nombres para que los equipos reciban notificaciones antes de gastar de más, no después.
-
Programe una limpieza mensual de PersistentVolumeClaims huérfanos, espacios de nombres inactivos y ConfigMaps obsoletos.
-
Asigne un campeón de FinOps por equipo para que sea responsable de las métricas de costes junto con las métricas de fiabilidad.
El cambio cultural es tan importante como el ajuste técnico. Incorporar la responsabilidad de costes en las revisiones de sprints y los OKRs de ingeniería mantiene los ahorros a largo plazo. Los equipos que tratan el gasto en la nube como una métrica de ingeniería compartida, no como un problema financiero, superan consistentemente a aquellos que tratan la optimización como un proyecto puntual. La dimensión de la cultura de ingeniería de DevOps es donde reside la disciplina de costes duradera.
Consejo profesional: Comience con showback antes que con chargeback. Mostrar a los equipos sus costes sin facturarles primero crea conciencia y aceptación. El chargeback sin contexto crea fricción y resistencia en lugar de propiedad.
Puntos clave
La optimización efectiva de costes de Kubernetes requiere ajustar primero las solicitudes de recursos, luego añadir escalado automático y computación con descuento, y finalmente incorporar la gobernanza para evitar que el desperdicio regrese.
| Punto | Detalles |
|---|---|
| Ajustar primero las solicitudes de los pods | Establezca las solicitudes en el uso P99 más un margen del 20 %; utilice el VPA en modo de recomendación antes de aplicar cambios. |
| Escalar automáticamente en cada capa | Combine HPA, VPA, KEDA y Karpenter para adaptar la capacidad a la demanda dinámicamente. |
| Utilizar instancias Spot y Graviton | Spot ahorra entre un 60–90 % en cargas de trabajo elegibles; Graviton reduce los costes de computación aproximadamente un 20 %. |
| Cumplir con el etiquetado y la asignación | Utilice OPA Gatekeeper o Kyverno para exigir etiquetas; ejecute informes de showback para fomentar la responsabilidad del equipo. |
| Medir antes de recortar | Establezca visibilidad de costes con OpenCost o Kubecost antes de realizar cualquier cambio en la infraestructura. |
Lo que he ’ aprendido del trabajo real con costes de Kubernetes
El error más común que veo que cometen los equipos es saltar directamente a las instancias Spot o la consolidación de equilibradores de carga antes de corregir sus solicitudes de recursos. Esos son ahorros reales, pero son multiplicadores de una base rota. Si sus pods solicitan 4 veces lo que usan, los precios Spot de esos pods dejan intacta la mayor parte del desperdicio.
El orden importa: primero visibilidad, luego ajuste adecuado, luego optimización de precios. Los equipos que siguen este orden logran consistentemente reducciones mayores y más duraderas que los equipos que persiguen victorias rápidas fuera de orden. He visto organizaciones reducir sus facturas a la mitad en 90 días siguiendo esta secuencia, y he visto a otras pasar meses en negociaciones de Instancias Reservadas mientras sus clústeres funcionaban con un 10 % de utilización.
El problema más difícil es organizativo. Los ingenieros no sobreprovisionan por descuido. Lo hacen porque se les mide por fiabilidad, no por coste. Hasta que el coste aparezca en el mismo panel que el tiempo de actividad y la latencia, permanecerá invisible. Los equipos que mantienen los ahorros son aquellos que hacen del coste una métrica de ingeniería de primera clase, revisada en la misma reunión donde revisan los SLOs. Ese cambio es más difícil que cualquier configuración de Karpenter y es más importante.
— Paul CEO
Ridiculousengineering puede ayudarle a reducir los costes de Kubernetes
La reducción de costes de Kubernetes es un desafío técnico y organizativo. Hacerlo bien requiere un análisis preciso de la carga de trabajo, una automatización bien diseñada y sistemas de gobernanza que resistan la presión real de los equipos de ingeniería.
Ridiculousengineering trabaja con gerentes de TI y equipos de DevOps para diseñar y construir la infraestructura en la nube, la automatización y las herramientas de gobernanza que hacen que la eficiencia de costes perdure. Desde el análisis de ajuste adecuado hasta la arquitectura en la nube y servicios de DevOps personalizados, el equipo aporta tanto la profundidad técnica como la experiencia organizativa para dirigir el gasto de Kubernetes en la dirección correcta. Si sus facturas de clúster no reflejan su carga de trabajo real, esa brecha merece cerrarse.
Preguntas frecuentes
¿Cuál es la forma más rápida de reducir los costes de Kubernetes?
El ajuste adecuado de las solicitudes de recursos de los pods ofrece los ahorros más rápidos. Los equipos suelen ver reducciones del 20–30 % en el primer mes alineando las solicitudes con el uso real y eliminando cargas de trabajo inactivas.
¿En qué se diferencia Karpenter de Cluster Autoscaler?
Karpenter aprovisiona nodos dinámicamente entre miles de tipos de instancia y admite consolidación automatizada, reduciendo el desperdicio de computación entre un 15–30 % en comparación con el enfoque de grupo de nodos estático de Cluster Autoscaler ’.
¿Son seguras las instancias Spot para cargas de trabajo de Kubernetes en producción?
Las instancias Spot son seguras para cargas de trabajo sin estado, trabajos por lotes y ejecutores de CI/CD. Las cargas de trabajo con estado y las bases de datos deben permanecer en nodos bajo demanda para evitar interrupciones por eventos de reclamación Spot.
¿Qué herramientas ofrecen visibilidad de costes de Kubernetes?
OpenCost y Kubecost son las opciones líderes de código abierto y comerciales para la asignación de costes a nivel de espacio de nombres. Ambas se integran con Prometheus y admiten informes de showback y chargeback.
¿Cómo reducen las etiquetas y los controladores de admisión el desperdicio de Kubernetes?
Las etiquetas consistentes permiten una atribución de costes precisa por equipo y entorno. Los controladores de admisión como OPA Gatekeeper o Kyverno exigen el etiquetado en la creación de recursos, evitando la acumulación de recursos sin etiquetar y sin seguimiento.