Pila de datos moderna: una hoja de ruta práctica para quienes toman decisiones
Pila de datos moderna: una hoja de ruta práctica para quienes toman decisiones La pila de datos moderna es una infraestructura de datos nativa de la nube y basada en ELT/SQL que traslada los datos sin procesar de los sistemas de origen a un estado gobernado y listo para el análisis, y actualmente constituye la base más práctica tanto para la analítica rápida como para la preparación para la IA. Si tu equipo todavía utiliza canalizaciones ETL locales, espera días para obtener informes o se pregunta por qué sus modelos de ML siguen produciendo resultados poco fiables, esta arquitectura es la respuesta directa.
Pila de datos moderna: una hoja de ruta práctica para quienes toman decisiones
La pila de datos moderna es una infraestructura de datos nativa de la nube y basada en ELT/SQL que traslada los datos sin procesar de los sistemas de origen a un estado gobernado y listo para el análisis, y actualmente constituye la base más práctica tanto para la analítica rápida como para la preparación para la IA. Si tu equipo todavía utiliza canalizaciones ETL locales, espera días para obtener informes o se pregunta por qué sus modelos de ML siguen produciendo resultados poco fiables, esta arquitectura es la respuesta directa. Los elementos fundamentales son ELT (cargar primero los datos sin procesar y transformarlos dentro del almacén mediante SQL), la separación entre almacenamiento y capacidad de cómputo y las herramientas modulares; juntos reducen la carga operativa y conservan el historial de datos que necesitarán tus futuras cargas de trabajo de IA.
Índice
-
Los componentes fundamentales: qué hace cada capa y quién es responsable de ella
-
¿En qué se diferencia una pila moderna de una plataforma de datos tradicional?
-
¿Qué controles de gobernanza y observabilidad deberías crear desde el primer día?
-
¿Qué apuestas estratégicas deberías hacer durante los próximos 12-36 meses?
-
Consideraciones medioambientales y de sostenibilidad de las pilas de datos nativas de la nube
-
Ridiculous Engineering crea pilas de datos modernas que realmente se ponen en producción
¿Qué es una pila de datos moderna y qué la hace «moderna»?
El término se utiliza de forma imprecisa, por lo que es importante contar con una definición precisa. Una pila de datos moderna sustituye el monolito ETL heredado por un conjunto de servicios gestionados en la nube, cada uno responsable de una capa de la canalización de datos y conectados mediante SQL como interfaz común. «Moderna» hace referencia a cuatro decisiones arquitectónicas concretas, no a una marca ni a un proveedor.
Principios fundamentales:
-
Servicios gestionados nativos de la nube. No hay servidores que aprovisionar ni clústeres de almacén cuyo tamaño haya que determinar de antemano. La capacidad de cómputo escala de forma elástica y solo se paga por lo que se ejecuta.
-
ELT, no ETL. Carga primero los datos sin procesar en el almacén y, después, transfórmalos allí mediante SQL. El almacenamiento de los almacenes de datos en la nube es económico; la capacidad de cómputo es elástica y se factura por consulta. Cargar todos los datos sin procesar preserva la flexibilidad: cuando cambien los requisitos dentro de seis meses (lo harán), los datos de origen seguirán estando disponibles.
-
SQL como lengua franca. Analistas, ingenieros de analítica e ingenieros de datos trabajan en el mismo lenguaje. Las transferencias cognitivas entre el preprocesamiento en Python y la generación de informes en SQL prácticamente desaparecen.
-
Separación entre almacenamiento y capacidad de cómputo. Las cargas de trabajo de generación de informes ya no compiten con las consultas ad hoc por la misma CPU. El entrenamiento de ML lee las mismas tablas que utiliza la inteligencia empresarial, sin copiarlas. La planificación de capacidad, el cuello de botella de la era local, prácticamente desaparece.
-
Modularidad con consolidación práctica. En teoría, cada capa se puede sustituir. En la práctica, la dirección en 2026 es utilizar menos herramientas que hagan más, no más herramientas que hagan menos.
Estos principios se conectan directamente con los resultados empresariales. El tiempo hasta obtener información útil se reduce porque los analistas pueden trabajar de forma autónoma con tablas modeladas en lugar de esperar a que el departamento de TI cree informes. Los costes se vuelven más previsibles cuando se utiliza un conjunto de herramientas pequeño y disciplinado. Y la preparación para la IA surge de forma natural: unos datos limpios, gobernados y accesibles son el requisito previo para que cualquier modelo de ML o agente de IA genere valor fiable.
Indicador de costes: Una empresa que utiliza la pila estándar suele tener un presupuesto mensual moderado, que aumenta según el tamaño del equipo y el uso, siendo la capacidad de cómputo del almacén el principal factor de coste. La variación se debe casi por completo a la capacidad de cómputo del almacén, que escala según el volumen de consultas y el grado de disciplina del equipo a la hora de elegir ejecuciones incrementales frente a actualizaciones completas. Para equipos habituales, el gasto mensual oscila entre 500 y 2.000 $ en una empresa de 50 personas, y entre 5.000 y 20.000 $ en equipos de tamaño mediano con entre 50 y 200 empleados.
Los componentes fundamentales: qué hace cada capa y quién es responsable de ella
Piensa en la pila de analítica como una canalización con responsabilidades diferenciadas en cada etapa. La mayoría de los errores de arquitectura se originan al mezclar capas.
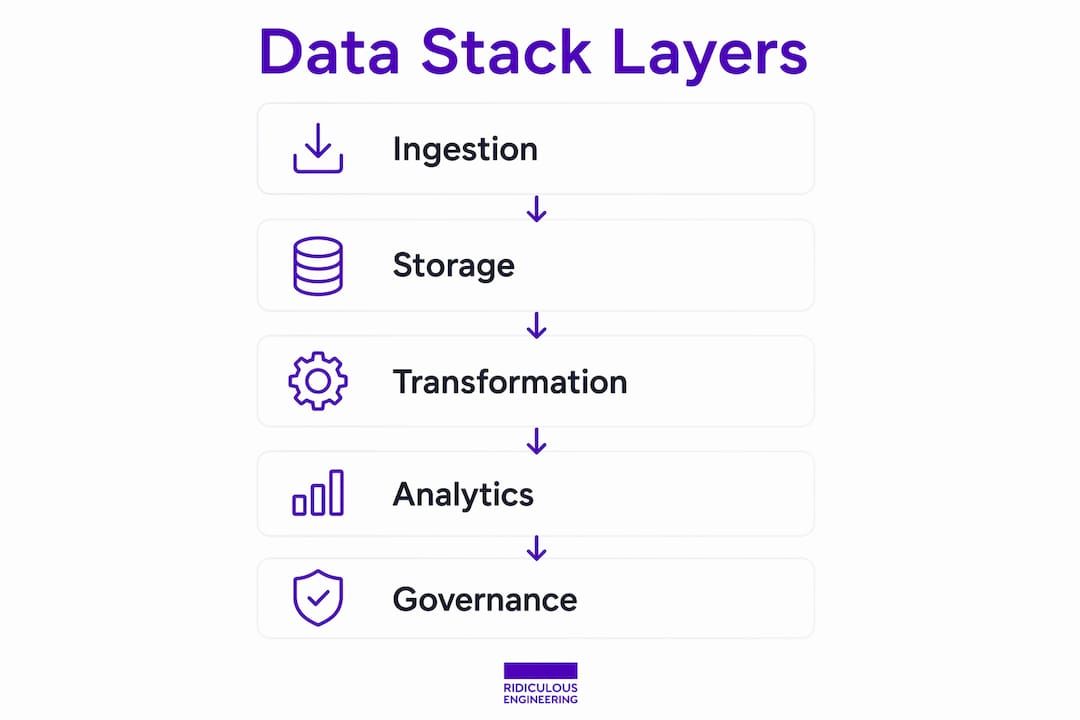
| Capa | Responsabilidad | Indicadores clave / limitaciones | Propietario habitual |
|---|---|---|---|
| Ingesta | Mover datos sin procesar desde las fuentes al almacén de datos; gestionar la detección de esquemas, las cargas incrementales y el CDC | Disponibilidad de conectores, gestión de información personal identificable (PII), frecuencia de sincronización | Ingeniero de datos / equipo de plataforma |
| Almacenamiento / almacén de datos | Almacenar datos sin procesar y modelados; ejecutar consultas SQL; escalar el cómputo de forma independiente | Modelo de costes de las consultas, concurrencia, compatibilidad con cargas de trabajo de ML | Equipo de plataforma |
| Transformación | Convertir tablas sin procesar en activos modelados, probados y documentados mediante SQL | Tiempo de ejecución de los modelos, estrategia incremental, cobertura de las pruebas | Ingeniero de analítica |
| Orquestación | Programar DAG, reintentar los fallos, alertar sobre interrupciones y bloquear los procesos posteriores cuando falle un proceso anterior | Complejidad de las canalizaciones, dominio de Python del equipo, solución gestionada frente a autogestionada | Ingeniero de datos |
| Calidad de los datos / observabilidad | Supervisar la actualización, la deriva del esquema, las tasas de valores nulos y las tasas de pruebas superadas; alertar antes de que las partes interesadas lo detecten | Sensibilidad a los SLA, requisitos de los contratos de datos | Ingeniero de analítica + equipo de plataforma |
| Métricas / capa semántica | Definir las métricas empresariales una sola vez; ofrecer cifras coherentes en todas las herramientas de BI | Gobernanza de métricas, entornos de BI con varias herramientas | Responsable de analítica + responsables de negocio |
| BI / analítica | Ofrecer cuadros de mando, consultas ad hoc y exploración de autoservicio | Nivel técnico de la audiencia, necesidades de integración | Equipo de analítica + responsables de negocio |
| ETL inverso / activación | Enviar datos modelados a herramientas operativas (CRM, plataformas de marketing) | Frecuencia de sincronización, cumplimiento de la normativa sobre PII, límites de velocidad de las API | Ingeniero de datos + operaciones de marketing/ventas |
| Streaming (cuando sea necesario) | Gestionar el procesamiento de eventos de baja latencia cuando la cadencia por lotes sea insuficiente | SLA de latencia, tasa de eventos, capacidad de ingeniería | Plataforma / ingeniería de datos |
Conviene exponer claramente algunas cuestiones de responsabilidad. Normalmente, los responsables de negocio definen el significado de las métricas y aprueban las definiciones de la capa semántica. Los equipos de plataforma son responsables de la infraestructura, los controles de acceso y la supervisión de costes. Los ingenieros de analítica se sitúan en la intersección entre la ingeniería de datos y el análisis, y es en ese puesto donde la mayoría de las arquitecturas modernas triunfan o fracasan. Se necesitan SLA entre equipos en el límite entre la ingesta y el almacén de datos (¿quién es responsable cuando falla un conector de origen?) y en el límite entre la transformación y el BI (¿quién se responsabiliza de una métrica rota en un cuadro de mando?).
Dónde suelen equivocarse los equipos:
-
Omitir la capa semántica y permitir que cada informe de BI defina su propia lógica de métricas, lo que produce cifras contradictorias entre equipos.
-
Tratar la orquestación como opcional hasta que las canalizaciones superen los diez modelos y luego apresurarse a incorporarla de forma retroactiva.
-
Asignar la observabilidad a «quien se dé cuenta», lo que significa que no será responsabilidad de nadie hasta que lo note una parte interesada.
¿Qué patrón de arquitectura se adapta a tu situación?
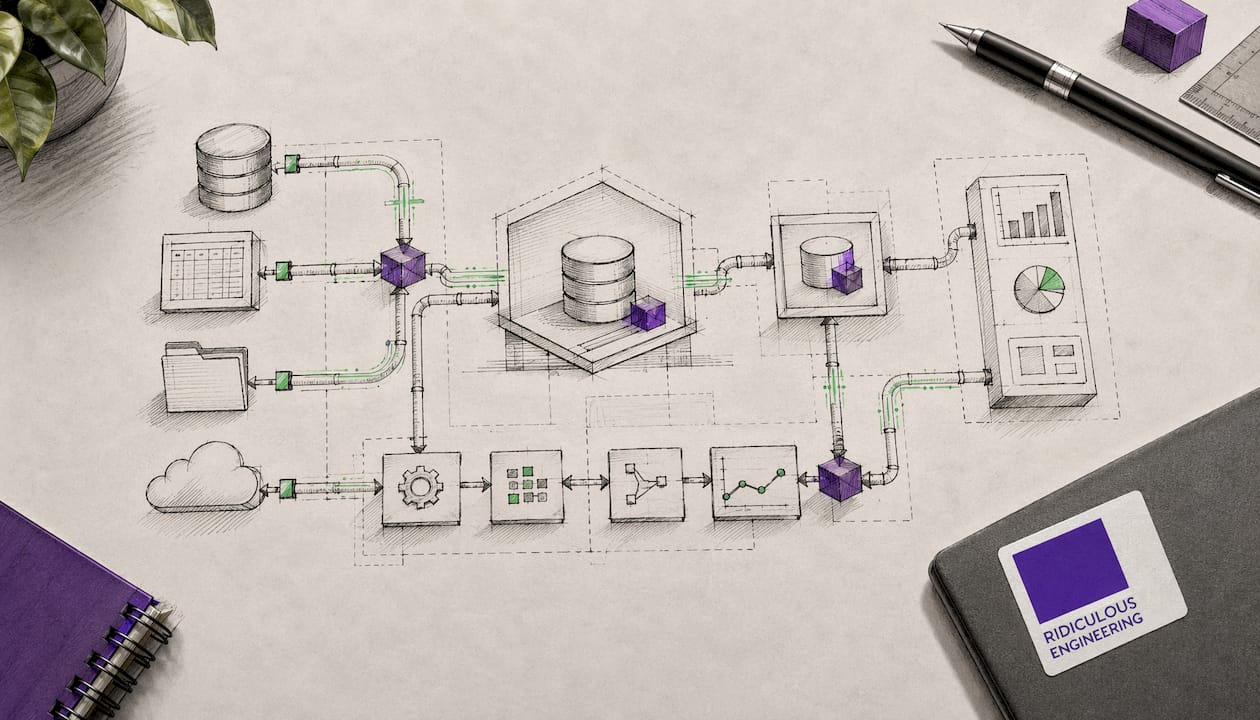
Centrado en el almacén de datos
La opción predeterminada para la mayoría de los equipos. Un almacén de datos en la nube (Snowflake, BigQuery o Databricks SQL) actúa como núcleo. Los datos sin procesar llegan allí mediante conectores, dbt los transforma y las herramientas de BI los consultan directamente. Es sencillo de operar, está bien documentado y resulta suficiente para la mayoría de las cargas de trabajo de analítica.
Lakehouse
Los formatos de tablas abiertos, como Apache Iceberg y Delta Lake, se alojan sobre almacenamiento de objetos (S3, GCS, ADLS) y permiten realizar tanto análisis SQL como entrenamiento de ML a partir de los mismos datos físicos. Los patrones lakehouse reducen la dependencia del proveedor en los formatos de almacenamiento y son la opción adecuada cuando las cargas de trabajo de ML son una prioridad al mismo nivel que la BI. Databricks es el punto de entrada más habitual; la compatibilidad de Snowflake con Iceberg ha reducido considerablemente la diferencia.
Híbrido
Un almacén de datos gestiona la analítica gobernada; un lakehouse o lago de datos gestiona la experimentación de ML y el almacenamiento de datos sin procesar a gran escala. Implica una mayor complejidad operativa, pero es adecuado para organizaciones en las que los equipos de ML y analítica tienen necesidades realmente diferentes y suficiente capacidad de ingeniería para mantener ambos entornos.
Complementos de streaming
La pila moderna prioriza el procesamiento por lotes. Las arquitecturas de streaming (Kafka más Flink o Spark Streaming) suelen ejecutarse junto al almacén de datos en lugar de sustituirlo. La propuesta del «procesamiento unificado por lotes y en streaming» se ha promocionado constantemente durante años; en la práctica, los sistemas en tiempo real coexisten con el almacén de datos y rara vez comparten código con él. Introduce streaming solo cuando un SLA de latencia lo exija realmente, no porque suene impresionante. Para profundizar en cuándo merecen la pena los patrones en tiempo real, los patrones de datos en tiempo real merecen una revisión antes de comprometerse con el coste de la infraestructura.
Consejo profesional: Empieza con el patrón centrado en el almacén de datos. Añade una capa lakehouse solo cuando las cargas de trabajo de ML estén en producción y el equipo cuente con un ingeniero de plataforma dedicado a mantener el formato de tabla abierto. Añade streaming solo cuando un proceso empresarial tenga un SLA de latencia documentado inferior a cinco minutos que el procesamiento por lotes no pueda cumplir.
¿En qué se diferencia una pila moderna de una plataforma de datos tradicional?
El contraste es más marcado de lo que reconocen la mayoría de las propuestas de migración.
Diferencias clave:
-
Modelo de implementación. Las plataformas heredadas se ejecutan en las instalaciones o en máquinas virtuales autogestionadas. Las pilas modernas utilizan servicios en la nube totalmente gestionados, sin infraestructura que aprovisionar.
-
ETL frente a ELT. El ETL heredado transforma los datos antes de que lleguen al almacén, a menudo mediante herramientas propietarias con un control de versiones limitado. El ELT carga primero los datos sin procesar y los transforma dentro del almacén utilizando SQL en Git.
-
Monolítico frente a modular. Las plataformas heredadas agrupan la ingesta, la transformación y la entrega en un único producto. Las pilas modernas los separan, lo que permite escalar de forma independiente y asignar la responsabilidad a cada equipo.
-
Modelo de escalado. Los sistemas locales requieren planificar la capacidad y adquirir hardware. Los almacenes de datos en la nube escalan la capacidad de cómputo en segundos.
-
Autoservicio frente a informes controlados por TI. Los sistemas heredados suelen requerir que TI cree cada informe. Las pilas modernas exponen las tablas modeladas directamente a analistas y usuarios empresariales.
Los cambios arquitectónicos que lo hicieron posible llegaron en secuencia: el almacenamiento de objetos en la nube abarató la retención de datos sin procesar, los almacenes de datos en la nube separaron el cómputo del almacenamiento y dbt incorporó la lógica de transformación a Git. Esos tres cambios, que se produjeron aproximadamente entre 2016 y 2020, hicieron viable la pila moderna para equipos sin grandes presupuestos de infraestructura.
Antipatrones de migración que conviene evitar: Hacer un lift-and-shift sin refactorizar (obtendrás costes de nube con una arquitectura local), realizar cargas incrementales no controladas que dupliquen registros silenciosamente y omitir la configuración de la gobernanza con la suposición de que se añadirá más adelante. No lo harás hasta que un incidente te obligue a hacerlo.
Las plataformas heredadas conllevan riesgos operativos reales: los cambios de esquema rompen los informes posteriores sin ningún linaje que permita rastrear el impacto, las limitaciones de capacidad crean colas de informes y los procedimientos almacenados acumulan deuda técnica que nadie quiere tocar. Las ventajas de la computación en la nube del enfoque moderno no son teóricas; se reflejan en una menor carga de guardias y ciclos de iteración más rápidos.
¿Qué herramientas deberías utilizar realmente?
El ELT con SQL en el almacén ha estandarizado la capa de transformación, y dbt es la herramienta predeterminada para gestionar modelos SQL. El resto de la pila ofrece más opciones, pero el criterio de selección es coherente: elige una herramienta por capa, prioriza los servicios gestionados frente a los autogestionados cuando la capacidad del equipo sea limitada y planifica los controles de FinOps desde el primer día.
| Capa | Herramientas representativas | Más adecuado para / notas |
|---|---|---|
| Ingesta | Fivetran, Airbyte, AWS Glue, Azure Data Factory | Fivetran: gestionado, muchos conectores, operaciones mínimas; Airbyte: opción de código abierto; Glue/ADF: para organizaciones nativas de AWS/Azure |
| Almacén de datos | Snowflake, Google BigQuery, Databricks | Snowflake: centrado en analítica, sólida gobernanza; BigQuery: rentable a escala, sin servidor; Databricks: cargas de trabajo intensivas en ML |
| Transformación | dbt (Cloud o Core), SQLMesh | dbt es la opción predeterminada; SQLMesh es la alternativa emergente para ejecuciones con conocimiento del estado |
| Orquestación | Apache Airflow, Dagster, Prefect | Airflow lidera por número de implementaciones; Dagster gana popularidad para flujos de trabajo basados en activos; Prefect para equipos centrados en Python |
| Calidad de datos / Observabilidad | Pruebas de dbt, Monte Carlo, Soda | Las pruebas de dbt cubren la mayoría de las necesidades iniciales; Monte Carlo y Soda para supervisar los SLA en producción |
| Métricas / Capa semántica | Capa semántica de dbt, Cube | Define las métricas una sola vez y ponlas a disposición de varias herramientas de BI |
| BI / Analítica | Looker, Tableau, Power BI, Metabase | Looker para la gobernanza de métricas; Metabase para un autoservicio amplio; Tableau/Power BI para informes ejecutivos |
| ETL inverso / Activación | Census, Hightouch | Envía datos modelados al CRM, a plataformas publicitarias y a herramientas operativas |
| Streaming | Apache Kafka, Apache Flink, RisingWave | En paralelo al almacén de datos; introdúcelo solo cuando el SLA de latencia lo requiera |
Criterios de selección para organizaciones de EE. UU.:
-
Si tu equipo tiene menos de tres ingenieros de datos, elige una ingesta gestionada (Fivetran) y dbt Cloud en lugar de alternativas autogestionadas. El ahorro operativo compensa el coste de las licencias.
-
Snowflake y BigQuery son opciones predeterminadas sólidas; la decisión suele depender de las relaciones existentes con proveedores de nube y de si las cargas de trabajo de ML son prioritarias.
-
La proliferación de herramientas, con ocho o más herramientas SaaS, genera una fricción operativa y de costes considerable. En la práctica, muchos equipos se reducen a cuatro componentes principales: almacén de datos, dbt, un orquestador y una herramienta de BI.
-
Apache Airflow es conceptualmente importante, pero ejecutarlo en Kubernetes requiere ingeniería de plataforma dedicada. Airflow gestionado (Cloud Composer, MWAA, Astronomer) es la opción práctica para la mayoría de los equipos.
¿Qué controles de gobernanza y observabilidad deberías implementar desde el primer día?
La gobernanza incorporada después de un incidente siempre es más costosa que la gobernanza integrada desde el principio. Lo mismo ocurre con la observabilidad. Trata ambas como funcionalidades del producto con sus propios SLA, no como casillas de cumplimiento normativo.
Pilares fundamentales de la gobernanza:
-
Control de acceso con mínimo privilegio.Control de acceso basado en roles a nivel del almacén de datos, con roles separados para datos sin procesar, datos modelados y columnas etiquetadas como PII. Ningún analista debería tener acceso de escritura a los esquemas sin procesar.
-
Linaje y catalogación de datos.El linaje integrado de dbt cubre la capa de transformación. Amplíalo aguas arriba (sistemas de origen) y aguas abajo (informes de BI) con una herramienta de catálogo o funcionalidades de metadatos nativas del almacén de datos.
-
Detección y enmascaramiento de PII.Etiqueta las columnas con PII durante la ingesta. Aplica políticas de enmascaramiento dinámico en el almacén de datos para que los modelos posteriores nunca expongan PII sin procesar a roles no autorizados.
-
Registro de auditoría. Cada consulta, cada cambio de esquema y cada concesión de rol deberían registrarse. La mayoría de los almacenes de datos en la nube ofrecen esta función de forma nativa; actívala antes de poner el sistema en producción.
-
Gobernanza de métricas. Define las métricas de negocio en la capa semántica, no en informes individuales de BI. Cuando «ingresos» significa lo mismo en todas partes, dejas de tener reuniones en las que dos equipos discuten sobre cuál de sus cifras es la correcta.
Para la observabilidad, las métricas clave que hay que supervisar son la actualización (¿cuándo se actualizó por última vez esta tabla?), la deriva del esquema (¿desapareció una columna de origen?), las tasas de valores nulos (¿un campo crítico está de repente vacío?) y las tasas de aprobación de las pruebas de dbt. Crea alertas sobre estos aspectos antes de que los detecten las partes interesadas. La calidad de los datos se correlaciona directamente con la fiabilidad de los modelos de IA, por lo que la observabilidad no es solo una cuestión operativa; es una inversión en preparación para la IA.
Ejemplos de salvaguardas de políticas que conviene adoptar pronto: solo los ingenieros de plataforma pueden ejecutar modelos dbt con actualización completa en producción; los cambios de esquema en los sistemas de origen requieren un plazo de aviso de 48 horas y una revisión del impacto posterior; las columnas con información personal identificable requieren la aprobación del responsable de los datos antes de que cualquier modelo nuevo haga referencia a ellas.
Consejo profesional: Integra la monitorización de FinOps en tu pila de observabilidad desde el primer día. Una sola actualización completa de dbt que no se supervise o una resincronización del conector tras un cambio de esquema puede multiplicar por diez tu factura del almacén de datos en una semana. Configura alertas de costes de consultas y presupuestos de créditos del almacén antes de incorporar tu primera canalización de producción. Los marcos de gobernanza en la nube proporcionan una plantilla de políticas útil para esto.
En las pilas con IA, las consideraciones de seguridad van más allá del acceso a los datos. Los riesgos de seguridad de la IA agéntica son una preocupación de gobernanza emergente que los equipos de plataformas de datos deberían comprender antes de exponer datos gobernados a agentes de IA.
¿Cómo se planifica y construye una pila de datos moderna?
Hoja de ruta por fases
Fase 1: Descubrir (semanas 1–4). Audita las fuentes de datos existentes, identifica las tres a cinco preguntas de negocio que la pila debe responder desde el primer día y documenta los flujos de datos actuales. Entregable: un inventario de fuentes y una lista priorizada de casos de uso.
Fase 2: Piloto del MVP (semanas 5–12). Configura un almacén de datos, un conector de ingesta para la fuente prioritaria, un proyecto de dbt con entre cinco y diez modelos y un panel de BI. Entregable: una canalización funcional y probada que responda de principio a fin a una pregunta de negocio.
Fase 3: Ampliar (meses 4–9). Añade conectores para las fuentes prioritarias restantes, desarrolla la capa de modelos de dbt, introduce la orquestación cuando las canalizaciones superen los diez modelos y añade monitorización de observabilidad. Entregable: una pila de nivel de producción que cubra los diez casos de uso principales.
Fase 4: Operativizar (meses 10–18). Formaliza las políticas de gobernanza, implementa la capa semántica, establece controles de FinOps y documenta los SLA. Entregable: una pila que el equipo pueda mantener y ampliar sin esfuerzos extraordinarios.
Funciones y dimensionamiento del equipo
| Función | Responsabilidad | Equipo pequeño (1–5 personas de datos) | Empresa mediana (5) | Empresa grande (gran empresa) |
|---|---|---|---|---|
| Ingeniero de analítica | Modelos de dbt, calidad de los datos, capa semántica | 1 (compartido con funciones de analista) | 2–4 | 4–8 |
| Ingeniero de datos | Ingesta, orquestación, operaciones de la plataforma | 1 (compartido) | 2–4 | 4–10 |
| Infraestructura de plataforma y datos | Administración del almacén de datos, seguridad y FinOps | Compartido con el ingeniero de datos | 1–2 dedicados | 2–5 dedicados |
| Analítica / BI | Desarrollo de paneles y apoyo a las partes interesadas | 1 (compartido) | 2–4 | 4–10 |
| Gobernanza de datos / seguridad | Políticas, control de acceso y cumplimiento | Compartido con la plataforma | 1 a tiempo parcial | 1–2 dedicados |
Para obtener orientación sobre la dotación de personal necesaria para crear equipos de datos preparados para la IA, estrategia de talento para organizaciones preparadas para la IA abarca las carencias de competencias que la mayoría de los equipos subestima.
Lista de comprobación de implementación
-
Selecciona y contrata tu almacén de datos (Snowflake, BigQuery o Databricks) y configura alertas de facturación antes de cargar ningún dato.
-
Adquiere una solución de ingesta gestionada (Fivetran o equivalente) y documenta los SLA de los conectores con los responsables de los sistemas de origen.
-
Configura una cuenta de dbt Cloud y un repositorio de Git; establece la protección de ramas y comprobaciones de CI en los modelos de dbt.
-
Define el control de acceso basado en roles en el almacén de datos antes de cargar cualquier dato adyacente a información personal identificable.
-
Configura la supervisión de los costes de las consultas y establece un umbral de presupuesto mensual que active una alerta al alcanzar el 80 % de utilización.
-
Documenta los criterios de aceptación para la puesta en producción: tasa mínima de pruebas superadas, SLA de actualización para cada tabla y aprobación de las partes interesadas de al menos un panel integral de extremo a extremo.
-
Programa una revisión a los 30 días de la puesta en producción para evaluar la fiabilidad de las canalizaciones, los costes reales frente a las estimaciones y la capacidad del equipo.
Factores que determinan la estimación de costes: El procesamiento del almacén de datos es la variable dominante y aumenta con el volumen de consultas y la frecuencia de ejecución de los modelos. Los costes de los conectores aumentan con el número de fuentes y la frecuencia de sincronización. Las políticas de retención de datos afectan moderadamente a los costes de almacenamiento. Una estrategia disciplinada de incrementos en dbt, frente a ejecuciones de actualización completa, puede reducir considerablemente los costes de procesamiento del almacén en tablas grandes.
¿Qué apuestas estratégicas deberías hacer durante los próximos 12–36 meses?
Consolidación hacia capacidades nativas del almacén de datos
El mercado está corrigiendo el rumbo hacia menos plataformas, pero más capaces. Snowflake añadió Snowpark y Streamlit. Databricks añadió Delta Live Tables y un orquestador. Microsoft Fabric agrupa la ingesta, la transformación y la inteligencia empresarial bajo una única relación de facturación. El cálculo de adquisición está cambiando: la sobrecarga de integración y ocho relaciones de facturación SaaS independientes constituyen por sí mismas un tipo de problema operativo. Para la mayoría de los equipos, la pila adecuada en 2026 es más pequeña que la versión canónica: un almacén de datos, dbt, un orquestador y una herramienta de BI.
El contraargumento es que las herramientas especializadas siguen superando a sus equivalentes nativos del almacén en capas individuales. A menudo es cierto. La cuestión es si la diferencia de rendimiento justifica el coste de integración. Para los equipos con una capacidad limitada de ingeniería de plataformas, normalmente no lo justifica. En cuanto a patrones de intercambio y consolidación de datos, los beneficios operativos de contar con menos puntos de integración están bien documentados.
La preparación para la IA como objetivo de diseño prioritario
La preparación para la IA no es una funcionalidad que se añade a una pila de datos; es una consecuencia de construirla correctamente desde el principio. Los requisitos previos son la calidad de los datos (probada, supervisada y fiable), la procedencia (rastreable desde el origen hasta el modelo y el resultado) y un conjunto de datos central pequeño y bien gobernado en el que los agentes de IA puedan confiar. Los almacenes vectoriales y los almacenes de características son relevantes para casos de uso específicos de aprendizaje automático, pero se sitúan sobre un almacén de datos bien gobernado, no en su lugar. Preparación operativa para la IA generativa depende de la misma base de datos.
Consejo profesional: Antes de invertir en una base de datos vectorial o un almacén de características, audita la cobertura actual de pruebas de tus modelos de dbt. Si la tasa de pruebas superadas es inferior al 90 % en los modelos críticos, los resultados de IA basados en esos datos serán poco fiables, independientemente de lo sofisticado que sea el modelo. Corrige primero los cimientos.
Cuándo contratar personal y cuándo recurrir a un consultor
Contrata a un ingeniero de plataformas dedicado cuando el número de pipelines supere los 20 y tu ingeniero de datos dedique más del 30 % de su tiempo a la infraestructura en lugar de al trabajo con datos. Recurre a un socio externo como Ridiculous Engineering cuando necesites acortar el plazo desde el descubrimiento hasta el MVP, cuando carezcas de experiencia interna en arquitectura para el diseño inicial o cuando una auditoría de gobernanza o preparación para la IA requiera una perspectiva externa. La compensaciones de la consolidación de SaaS entre los servicios gestionados y las opciones autogestionadas merecen entenderse antes de asumir compromisos a largo plazo con proveedores.
Consideraciones medioambientales y de sostenibilidad de las pilas de datos nativas de la nube
Las pilas de datos nativas de la nube tienen una huella medioambiental real, y conviene comprenderla antes de comprometerse con una configuración de almacenamiento y cómputo. Los principales proveedores de nube (AWS, Google Cloud y Microsoft Azure) han publicado compromisos de neutralidad de carbono o de emisiones netas cero, y sus centros de datos a hiperescala suelen funcionar con mayor eficiencia energética que las alternativas locales. Esa ventaja de eficiencia es real, pero no convierte el cómputo en la nube en una actividad libre de carbono.
Las principales palancas para reducir el impacto medioambiental de una pila de datos son la eficiencia del cómputo y la disciplina en la retención de datos. Los modelos de dbt mal escritos que ejecutan actualizaciones completas en tablas grandes desperdician cómputo; los modelos incrementales que procesan solo registros nuevos utilizan una fracción de los recursos. Los dashboards sin uso que activan consultas programadas, los conectores que se sincronizan cada cinco minutos cuando bastaría con hacerlo a diario y los almacenes que permanecen en funcionamiento sin suspensión automática contribuyen al consumo energético innecesario. Los controles de FinOps que reducen los costes también reducen las emisiones de carbono, por lo que el argumento empresarial y el de sostenibilidad apuntan en la misma dirección.
Las políticas de retención de datos también importan. Almacenar indefinidamente cada evento sin procesar en un almacén es caro y consume mucha energía. El almacenamiento por niveles (datos activos en el almacén y datos fríos en el almacenamiento de objetos) reduce tanto los costes como la sobrecarga de cómputo de los datos históricos que rara vez se consultan. Los equipos que tratan la retención de datos como una decisión de gobernanza, en lugar de como una configuración predeterminada, tienden a operar con pilas más ligeras, económicas y de menor impacto.
Conclusiones clave
Una pila de datos moderna basada en ELT, transformación priorizando SQL y servicios gestionados nativos de la nube es la base más práctica para lograr analítica rápida y preparación para la IA en 2026.
| Punto | Detalles |
|---|---|
| Empieza con poco y mantén la disciplina | Una pila de 4 herramientas (almacén + dbt + 1 orquestador + 1 herramienta de BI) supera a una combinación de 8 herramientas en la mayoría de los equipos. |
| Presupuesta la variabilidad del cómputo | Para la mayoría de los equipos, el gasto mensual es de 500 a 2.000 dólares en empresas de 50 personas y de 5.000 a 20.000 dólares en empresas medianas (de 50 a 200 empleados); el cómputo del almacén es el principal factor de coste. |
| Gobernanza desde el primer día | El acceso con privilegios mínimos, el enmascaramiento de información personal identificable y las alertas de FinOps deben configurarse antes de que los datos de producción lleguen al sistema, no después de un incidente. |
| La preparación para la IA requiere calidad de datos en primer lugar | La cobertura de pruebas, el linaje y la supervisión de la actualización de los modelos de dbt son requisitos previos para obtener resultados fiables de IA. |
| Ridiculous Engineering acelera la adopción | Ridiculous Engineering ofrece auditorías de descubrimiento, diseño de MVP, ingeniería de plataformas y configuración de la gobernanza para acortar el tiempo hasta producción. |
Ridiculous Engineering crea pilas de datos modernas que realmente llegan a producción
La mayoría de los equipos que tienen dificultades con la infraestructura de datos no carecen de ambición. Carecen de tiempo, experiencia en arquitectura o de ambas cosas. Ridiculous Engineering es una consultora de ingeniería de software con sede en Colorado que diseña, construye y pone en funcionamiento sistemas de datos y analítica para organizaciones que necesitan una pila preparada para producción sin disponer de seis meses para ponerla en marcha. El modelo de trabajo es práctico: una auditoría de descubrimiento centrada para identificar tus fuentes y casos de uso, un diseño de MVP que te permite disponer de un pipeline funcional en semanas y apoyo de ingeniería de plataformas para llevarlo hasta la gobernanza, la configuración de FinOps y la revisión de preparación para la IA. Si tu equipo tiene el talento, pero necesita orientación arquitectónica, un breve proyecto de consultoría suele bastar para evitar los errores más costosos. Contacta con Ridiculous Engineering para definir el alcance de un proyecto de descubrimiento.
Fuentes útiles
-
La pila de datos moderna, evaluada con honestidad — La evaluación práctica más directa de la arquitectura de 5 capas, sus compensaciones y la dirección de consolidación para 2026. Fuente principal de los rangos de costes, las herramientas predeterminadas y las limitaciones del streaming citados en este artículo.
-
Cómo crear una pila de datos moderna en 2026 — Guía práctica sobre el predominio de ELT/SQL, dbt como opción predeterminada para la transformación y las opciones de orquestación. Útil para secuenciar la implementación.
-
Pila de datos moderna 2026: guía completa de herramientas y arquitectura — Patrones de arquitectura que incluyen lakehouse y formatos de tablas abiertas; panorama de herramientas de orquestación con Airflow, Dagster y Prefect.
-
Qué es una pila de datos moderna y por qué importa — Descripción general de ThoughtSpot que conecta la calidad de los datos y la observabilidad con la preparación para la IA. Útil para las secciones sobre gobernanza y preparación para la IA.
-
Arquitectura de una plataforma de datos moderna: construir una pila de datos escalable — Profundización técnica en la separación entre almacenamiento y cómputo, y en SQL como interfaz compartida.
-
AWS Glue — Documentación principal del proveedor sobre integración de datos sin servidor en AWS; referencia para las opciones de ingesta nativas de AWS y de pipelines de ELT.
-
Azure Data Factory — Documentación del servicio gestionado de integración de datos de Microsoft; referencia para la configuración de pipelines de ingesta y ELT/ETL nativos de Azure.
-
Apache Software Foundation — Fuente principal de documentación de Apache Airflow, Apache Kafka, Apache Flink, Apache Iceberg y Apache Hudi.
-
Ridiculous Engineering: Computación en la nube para el crecimiento empresarial — Orientación sobre arquitectura y estrategia en la nube para líderes tecnológicos que diseñan una infraestructura de datos moderna.
-
Ridiculous Engineering: Comprender la IA y la calidad de los datos — Explica la relación entre la calidad de los datos, la observabilidad y la confianza en los modelos de IA.
Preguntas frecuentes
¿Qué es una pila de datos moderna?
Una pila de datos moderna es una infraestructura de datos nativa de la nube, basada en ELT y SQL, que ingiere datos sin procesar de los sistemas de origen, los almacena en un almacén de datos en la nube o lakehouse, los transforma mediante SQL (normalmente con dbt) y los pone a disposición de herramientas de BI y cargas de trabajo de IA. Sus características definitorias son los servicios gestionados en la nube, la separación del almacenamiento y la computación, y una lógica de transformación controlada mediante versiones.
¿Sigue siendo útil la idea de una pila de datos moderna?
Sí, los principios fundamentales están consolidados y siguen siendo el enfoque adecuado: servicios nativos de la nube, ELT, transformación basada principalmente en SQL y separación del almacenamiento y la computación. Lo que está cambiando es la composición de las herramientas. El ensamblaje de ocho herramientas especializadas está dando paso a la consolidación nativa del almacén de datos, por lo que la pila moderna en 2026 suele constar de cuatro herramientas, no de ocho.
¿Cuál es la diferencia entre una pila de datos tradicional y una moderna?
Las plataformas tradicionales utilizan ETL (transformar antes de cargar), se ejecutan en infraestructuras locales o autogestionadas y requieren que el departamento de TI cree cada informe. Las pilas modernas utilizan ELT (cargar los datos sin procesar y transformarlos en el almacén mediante SQL), se ejecutan en servicios gestionados en la nube y ponen los datos modelados directamente a disposición de los analistas para el autoservicio. El modelo operativo y de costes es fundamentalmente diferente.
¿Qué herramientas de pilas de datos son tendencia en 2026?
Las opciones predeterminadas son Snowflake o Google BigQuery para el almacén de datos, dbt para la transformación, Apache Airflow (o Dagster en proyectos nuevos) para la orquestación y Fivetran para la ingesta gestionada. La tendencia general es la consolidación: las funciones nativas del almacén de datos están reduciendo la necesidad de herramientas especializadas independientes en cada capa.
¿Cuánto cuesta al mes una pila de datos moderna?
Una empresa que utiliza la pila estándar suele gastar entre $500–$2,000 al mes para un equipo de 50 personas y entre $5,000–$20,000 para una empresa mediana (50–200 empleados), principalmente debido a los costes de computación del almacén de datos, que aumentan con el tamaño del equipo y el uso.