Gestion de la qualité des données : guide pratique pour 2026
Gestion de la qualité des données : guide pratique pour 2026 La gestion de la qualité des données (DQM) est l'ensemble des pratiques, règles et contrôles opérationnels qui maintiennent vos données exactes, complètes, cohérentes et adaptées à l'analytique et à l'IA.
Gestion de la qualité des données : guide pratique pour 2026
La gestion de la qualité des données (DQM) est l'ensemble des pratiques, règles et contrôles opérationnels qui maintiennent vos données exactes, complètes, cohérentes et adaptées à l'analytique et à l'IA. Ce n'est pas un projet de nettoyage ponctuel. C'est un programme opérationnel continu, et les organisations qui le traitent comme quelque chose de moindre tendent à découvrir l'écart lorsqu'un modèle fait défaut ou qu'un tableau de bord exécutif se contredit lors d'une réunion du conseil d'administration.
La chose la plus utile que vous puissiez faire à court terme est de profiler vos ensembles de données les plus critiques et de mettre en œuvre plusieurs règles automatisées couvrant le format, l'exhaustivité et l'unicité. Ce périmètre restreint est réalisable en environ un mois et génère les preuves dont vous avez besoin pour financer un programme plus large.
Que faire maintenant :
-
Identifiez les ensembles de données dont dépendent le plus vos pipelines d'analytique et d'IA (commencez par les données client, produit ou transaction).
-
Exécutez une passe de profilage pour établir les taux de base d'exhaustivité et de doublons.
-
Mettez en œuvre trois règles automatisées : une vérification de format/regex, une vérification de null/vide et une vérification d'unicité sur les clés primaires.
-
Attribuez un propriétaire de données nommé pour chaque ensemble de données avant d'écrire une seule règle.
Astuce de pro : Commencez par l'ensemble de données qui alimente votre rapport le plus utilisé ou votre modèle à plus fort enjeu. Corriger la qualité là-bas produit un impact commercial visible rapidement, ce qui est exactement ce dont vous avez besoin pour obtenir le budget pour le reste du programme.
Points clés à retenir
Une gestion efficace de la qualité des données est un programme opérationnel, pas un projet. Elle nécessite une propriété nommée, des règles automatisées et des KPI liés aux résultats commerciaux pour maintenir les résultats dans le temps.
| Point | Détails |
|---|---|
| Commencez par le profilage | Profilez vos cinq principaux ensembles de données d'abord pour établir les bases d'exhaustivité, d'unicité et de validité avant d'écrire des règles. |
| Automatisez trois règles immédiatement | Mettez en œuvre des vérifications de format, de null/vide et d'unicité dans votre pipeline existant dans les 30 jours pour un impact rapide et visible. |
| Attribuez la propriété avant les règles | Chaque ensemble de données a besoin d'un propriétaire de données nommé ; une règle sans propriétaire est une alerte sans personne pour y répondre. |
| Reliez les métriques aux résultats commerciaux | Suivez l'adoption des ensembles de données certifiés, le MTTD et le MTTR ainsi que les scores d'exhaustivité pour maintenir le soutien exécutif. |
| Ridiculous Engineering | Ridiculous Engineering livre des pilotes DQM ciblés en 30 à 90 jours, du profilage et de la conception de règles à la remise d'ensembles de données certifiés. |
Table des matières
-
Ce que couvre réellement la gestion de la qualité des données
-
Où appliquer les vérifications dans le cycle de vie des données
-
Quelles métriques et KPI prouvent réellement la valeur de la DQM
-
Ridiculous Engineering construit des programmes DQM qui fonctionnent réellement en production
Ce que couvre réellement la gestion de la qualité des données
La DQM couvre l’ensemble du cycle de vie des données : depuis le moment où les données entrent dans vos systèmes à l’ingestion, en passant par la transformation et l’enrichissement, jusqu’aux couches de données maîtres et d’analytique, puis à l’archivage ou la suppression. Elle combine le profilage (mesurer ce que vous avez), les règles (définir ce qu’est « bon »), la remédiation (corriger ce qui échoue) et la surveillance (détecter la dérive au fil du temps). L’objectif est l’aptitude à l’usage, pas la perfection abstraite.
Là où les équipes se perdent souvent, c’est dans le chevauchement avec les disciplines adjacentes. Le tableau ci-dessous clarifie les distinctions.
| Discipline | Focus principal | Livrables clés | Propriétaire typique |
|---|---|---|---|
| Gestion de la qualité des données | Exactitude, exhaustivité, cohérence et aptitude des valeurs de données | Règles, profils, flux de travail de remédiation, jeux de données certifiés | Data stewards, ingénieurs de données |
| Gouvernance des données | Politique, propriété, responsabilité et conformité sur l’ensemble des actifs de données | Politiques, rôles, catalogue de données, documentation de lignage | Chief Data Officer, conseil de gouvernance |
| Gestion des données maîtres | Enregistrement unique faisant autorité pour les entités principales (client, produit, emplacement) | Enregistrements d’or, résolution d’entités, hub MDM | Équipe de plateforme MDM, propriétaires de données |
| Nettoyage ad hoc des données | Correction ponctuelle d’un jeu de données spécifique | Fichier ou table nettoyé | Analyste ou ingénieur sur demande |
La DQM est la couche opérationnelle qui rend la politique de gouvernance réelle. La gouvernance vous dit quoi les règles devraient être ; la DQM est la machinerie qui les applique, mesure la conformité et achemine les exceptions aux bonnes personnes. La gestion des données maîtres dépend de la DQM pour maintenir la fiabilité des enregistrements d’or au fil du temps.
Pour l’analytique et l’IA en particulier, la DQM ajoute deux préoccupations que la gestion traditionnelle des données ignore souvent : le lignage auditable (afin de pouvoir retracer les données d’entraînement d’un modèle jusqu’à leur source) et la détection de dérive (afin de détecter quand les données de production divergent de la distribution sur laquelle le modèle a été entraîné). Les conseils de TechTarget présentent l’intégration de la gouvernance comme le mécanisme qui relie les rôles, les métadonnées, le lignage et les mesures de qualité en un système cohérent plutôt qu’une collection d’outils déconnectés.
La propriété se répartit généralement entre quatre rôles : propriétaires de données (responsables d’un domaine), data stewards (responsables des décisions quotidiennes sur la qualité), ingénieurs de données (qui construisent et maintiennent les pipelines et l’infrastructure de règles), et ingénieurs QA ou analytique (qui valident les sorties avant qu’elles n’atteignent les consommateurs).
Les dimensions canoniques que vous devez mesurer
Chaque programme DQM correspond à un ensemble de dimensions. Ce ne sont pas des catégories théoriques ; chacune correspond à une classe de défaillances qui cause un préjudice commercial réel.
| Dimension | Impact commercial en cas de violation | Contrôle simple ou métrique |
|---|---|---|
| Exactitude | Mauvaises décisions, exposition réglementaire | Audit d'échantillon : % d'enregistrements correspondant à la source faisant autorité |
| Exhaustivité | Les champs manquants cassent les modèles et les rapports | % d'exhaustivité = (valeurs non nulles / valeurs attendues totales) × 100 |
| Cohérence | Des valeurs conflictuelles entre systèmes érodent la confiance | Taux de correspondance inter-systèmes sur les clés partagées |
| Actualité / fraîcheur | Des données obsolètes produisent des informations dépassées | Âge de l'enregistrement par rapport au seuil SLA (par exemple, mis à jour dans les 24 heures) |
| Unicité | Les enregistrements en double gonflent les comptages et faussent les analyses | Taux de doublons = (lignes en double / lignes totales) × 100 |
| Validité / conformité | Des formats invalides font échouer le traitement en aval | % de valeurs correspondant au format ou à l'énumération définis |
| Intégrité / lignage | Des relations cassées corrompent les jointures et les agrégations | Contrôle d'intégrité référentielle : clés étrangères orphelines / total des clés étrangères |
| Pertinence | Des données non pertinentes augmentent les coûts de stockage et le bruit | % de champs activement utilisés par les consommateurs en aval |
L'exactitude et l'exhaustivité ont tendance à être les plus importantes pour l'analyse structurée.
Pour les charges de travail IA et ML, le Guide de gestion de la qualité des données AISI recommande de traiter la qualité de l'annotation, la détection des biais, le contrôle de version et la surveillance de la dérive comme des contrôles séparés superposés aux dimensions canoniques plutôt que de les y intégrer. La qualité de l'annotation est un mode de défaillance en soi : une étiquette techniquement « complète » peut néanmoins être systématiquement erronée. La surveillance de la dérive appartient à la couche de service du modèle, pas seulement à l'ingestion. Ces éléments méritent d'être ajoutés à votre inventaire de dimensions si vous construisez ou maintenez des modèles de ML. Pour en savoir plus sur le lien entre la qualité des données et la fiabilité de l'IA, l'article Ridiculous Engineering sur l'IA et la qualité des données couvre les implications pratiques en profondeur.
Capacités de base que votre programme DQM doit avoir
Un programme DQM n'est aussi solide que la machinerie opérationnelle qui le sous-tend. Les capacités suivantes constituent l'ensemble minimal viable pour un programme de niveau production.
Le profilage est la fondation. Avant d'écrire une règle, vous devez savoir à quoi ressemblent réellement vos données : taux de valeurs nulles, distributions de valeurs, cardinalité et modèles de format. Les outils de profilage génèrent automatiquement cette base et révèlent des anomalies que vous ne trouveriez pas en examinant un échantillon.
Un moteur de règles est là où la politique devient application. La documentation de Microsoft Purview décrit un modèle pratique en trois parties pour les règles personnalisées : une expression de ligne (le contrôle de base), une expression de filtre (les lignes auxquelles la règle s'applique) et une expression nulle (comment gérer les valeurs manquantes). Cette structure gère les cas limites que les simples contrôles regex manquent. Les types de règles dont vous avez besoin au minimum : correspondance regex/format, validation du type de données, détection de valeurs nulles/vides, contrôles d'unicité, validation par recherche dans une table de référence, et expressions de ligne personnalisées pour la logique métier.
Correspondance et déduplication résout la dimension d'unicité à grande échelle. La déduplication par correspondance exacte gère les cas simples ; la correspondance probabiliste (nom flou, normalisation d'adresse) est requise pour les données clients et fournisseurs lorsque les enregistrements arrivent de plusieurs sources avec un formatage incohérent.
Workflows de remédiation bouclent la boucle. Trois modèles couvrent la plupart des situations : correction automatisée (sûre pour les correctifs déterministes comme la normalisation du format de date), quarantaine par étapes (conserver l'enregistrement, le signaler, l'empêcher d'atteindre les consommateurs en aval jusqu'à examen), et workflows de steward avec tickets (acheminer l'exception à un propriétaire nommé avec contexte et délai). La correction automatisée est rapide mais risquée si la logique de correction est erronée. La quarantaine est le défaut le plus sûr pour les cas ambigus.
Lignage et observabilité vous permettent de répondre à la question que tout auditeur et ingénieur de modèles finit par poser : d'où viennent ces données et que leur est-il arrivé ? Sans lignage, vous ne pouvez pas certifier un ensemble de données pour l'entraînement de modèles ou le reporting réglementaire.
Astuce de pro : Priorisez les règles par impact en aval, pas par facilité de mise en œuvre. Mappez chaque règle proposée au pipeline ou au rapport qu'elle protège, puis classez par criticité métier.
Comment construire un programme DQM efficace
Construire une capacité DQM est un effort par phases. Essayer de tout gouverner à la fois est la manière la plus courante de ne rien gouverner du tout.
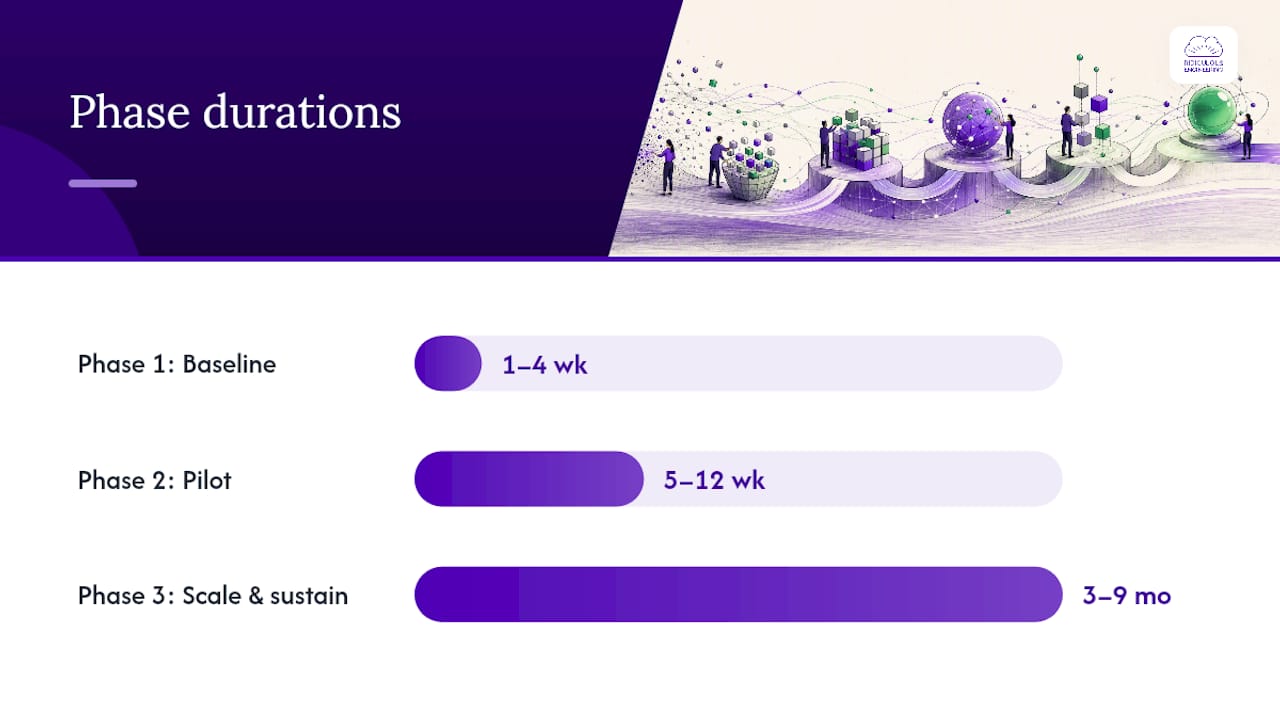
Phase 1 : Référence et cadrage (semaines 1 à 4)
-
Réalisez une évaluation de maturité : documentez la couverture de profilage actuelle, les règles existantes, les lacunes de propriété et les incidents de qualité connus.
-
Identifiez les éléments de données critiques (CDE) — les champs et ensembles de données qui affectent directement les revenus, la conformité ou les performances des modèles.
-
Profilez les CDE pour établir des métriques de référence pour l'exhaustivité, l'unicité et la validité.
-
Définissez des SLA : ce que « assez bon » signifie pour chaque dimension sur chaque ensemble de données.
Phase 2 : Pilote (semaines 5 à 12)
-
Concevez et mettez en œuvre un ensemble de règles pour un domaine hautement prioritaire (les données clients sont un point de départ courant).
-
Mettez en place des workflows de remédiation : au minimum, une file d'attente de quarantaine et un processus de notification de steward.
-
Automatisez l'exécution des règles dans votre ETL ou plateforme de données.
-
Publiez un tableau de bord KPI simple montrant les scores de qualité de référence par rapport aux scores actuels.
Phase 3 : Mise à l'échelle et durabilité (mois 3 à 9)
-
Étendez la couverture des règles à des domaines supplémentaires en fonction de la priorité des CDE.
-
Intégrez les contrôles de qualité dans les pipelines CI/CD pour les actifs de données.
-
Établissez un catalogue de jeux de données certifiés : une liste gouvernée de jeux de données ayant passé des seuils de qualité définis et approuvés pour l'analytique et l'utilisation de modèles.
-
Réalisez des revues de gestion trimestrielles par rapport aux KPI de qualité, comme recommandé par le cadre DQMS DAMA-NL.
Rôles et responsabilités :
-
Sponsor exécutif : approuve la portée, le budget et le chemin d'escalade ; examine les KPI trimestriellement.
-
Propriétaires de données : responsables des résultats de qualité dans leur domaine ; approuvent les changements de règles.
-
Stewards de données : résolvent les exceptions, maintiennent les données de référence et possèdent les files de remédiation.
-
Ingénieurs de données : construisent et maintiennent l'infrastructure de règles, les pipelines et la surveillance.
-
Ingénieurs QA / analytique : valident les sorties avant la promotion au statut certifié.
Les trois pièges qui font dérailler la plupart des programmes : sur-gouvernance (écrire des centaines de règles avant qu'aucune ne soit appliquée), propriété manquante (des règles sans steward nommé deviennent des alertes orphelines), et ignorance des consommateurs en aval (construire des règles qui satisfont l'équipe de données mais pas les analystes ou ingénieurs de modèles qui utilisent réellement les données). Gartner recommandecombinant profilage, surveillance, intendance et gouvernance tout en liant les améliorations de qualité à des résultats commerciaux mesurables — cette dernière partie est ce qui maintient le programme financé au-delà du premier trimestre.
Astuce de pro : Exécutez votre pilote sur le jeu de données qui alimente le rapport que la partie prenante la plus senior consulte chaque semaine. Lorsque les scores de qualité s'améliorent et que le rapport cesse d'être en contradiction avec lui-même, vous avez une histoire qui finance la phase suivante sans étude de cas longue.
Où appliquer les contrôles dans le cycle de vie des données
Les contrôles de qualité doivent être présents à plusieurs points du cycle de vie des données, pas seulement à la fin. Plus un enregistrement défectueux descend en aval, plus il est coûteux à corriger.
| Étape du cycle de vie | Contrôles recommandés | Prévention ou détection |
|---|---|---|
| Conception / collecte | Définition de schéma, contraintes d'énumération, application des champs obligatoires à la source | Prévention |
| Ingestion (API, fichier, flux) | Validation de schéma, contrôles de format, détection de nullité, intégrité référentielle | Prévention |
| Transformation (ETL/ELT) | Complétude, unicité, cohérence inter-tables, validation des règles métier | Détection |
| Couche données maîtres / MDM | Déduplication, résolution d'entités, certification d'enregistrement doré | Prévention + détection |
| Analytique / entraînement de modèles | Cohérence des étiquettes, contrôles de biais, dérive de distribution, contrôle de version | Détection |
| Service / consommation | Contrôles de ponctualité SLA, validation des indicateurs de jeu de données certifié | Détection |
| Archivage | Audit de complétude, instantané de lignage | Détection |
Les contrôles de prévention à la source sont moins chers par défaut détecté mais nécessitent une coordination avec les propriétaires de systèmes en amont, ce qui est souvent le problème organisationnel le plus difficile. Les contrôles de détection post-ingestion sont plus faciles à mettre en œuvre unilatéralement mais permettent aux mauvaises données de voyager plus loin avant d'être détectées.
Un exemple pratique de pipeline : pour une ingestion API alimentant un modèle d'analytique client, appliquez des contrôles de schéma et de format à la passerelle API (prévention), des contrôles de complétude et d'unicité dans la couche ETL (détection), et des contrôles de cohérence des étiquettes et de dérive dans le pipeline d'entraînement du modèle (détection). Le guidebook AISI recommande spécifiquement le contrôle de version et la surveillance de dérive comme contrôles appartenant à l'étape d'entraînement du modèle, pas seulement à l'ingestion. Le post Ridiculous Engineering sur les pipelines de données opérationnels couvre comment ces modèles s'appliquent dans les environnements de production.
Quelles métriques et KPI prouvent réellement la valeur de la DQM
Les métriques de qualité ne soutiennent le soutien exécutif que lorsqu'elles se connectent aux résultats que l'entreprise suit déjà.
Métriques principales à suivre :
-
Score de complétude : (valeurs non nulles / total attendu) × 100, par jeu de données et par CDE.
-
Taux de doublons : (lignes en double / total des lignes) × 100 ; la cible varie par domaine mais moins de 1 % est un SLA de départ raisonnable pour les données maîtres client.
-
Taux de précision : % d'enregistrements échantillonnés correspondant à une source faisant autorité ; un échantillonnage de 200 à 500 enregistrements par jeu de données et par trimestre est suffisant pour la plupart des programmes.
-
Conformité au SLA de fraîcheur : % d'enregistrements mis à jour dans la fenêtre de fraîcheur définie.
-
Adoption des jeux de données certifiés : % des charges de travail d'analyse et de modélisation consommant des données du catalogue certifié par rapport aux sources non certifiées.
-
Délai moyen de détection (MTTD) : temps moyen entre l'apparition d'un problème de qualité et son signalement par la surveillance.
-
Délai moyen de remédiation (MTTR) : temps moyen entre la détection et la résolution ; un flux de travail de gestionnaire avec une propriété claire réduit généralement le MTTR plus que l'automatisation seule.
Les programmes pratiques mesurent l'adoption et les résultats plutôt que les comptes d'activité, selon le playbook de gouvernance d'InfiniSynapse. Des métriques comme l'utilisation des jeux de données certifiés, la réduction des conflits de rapports et le temps d'audit sont celles qui trouvent un écho auprès des responsables financiers et opérationnels.
Une ligne de tableau de bord KPI simple ressemble à ceci : nom de la métrique, valeur actuelle, cible/SLA, tendance (hausse/baisse/stable) et propriétaire. Publier ce tableau de bord aux parties prenantes mensuellement est plus efficace qu'une analyse approfondie trimestrielle, car cela maintient la qualité visible comme une préoccupation opérationnelle plutôt qu'un audit périodique.
Comment évaluer le paysage technologique
La sélection des outils doit suivre la stratégie, non la précéder. Clarifiez vos domaines, flux de travail et métriques de succès avant d'évaluer les plateformes.
Catégories d'outils à considérer :
-
Profilage et observabilité des données : mesure de base automatisée, détection d'anomalies et alertes de dérive. Ces outils génèrent les preuves qui justifient l'investissement dans les règles.
-
Catalogues de données et lignage : gestion des métadonnées, documentation des jeux de données et suivi du lignage de bout en bout. Essentiel pour les programmes de jeux de données certifiés et la préparation aux audits.
-
Moteurs de règles et validateurs : la couche d'application. Recherchez la prise en charge des types de règles documentés dans le guide de création de règles de Microsoft Purview : regex, type de données, null/vide, unicité, recherche dans une table et expressions de lignes personnalisées avec gestion des nulls.
-
Moteurs de correspondance et de déduplication : correspondance probabiliste et déterministe pour la résolution d'entités.
-
Plateformes MDM : gestion des enregistrements d'or pour les entités principales.
-
Orchestration et surveillance : planification des pipelines, alertes et suivi des SLA.
Acheter vs. construire : achetez une plateforme intégrée lorsque vous avez besoin de lignage, de catalogue et de certification dans un système unique avec journaux d'audit et contrôle d'accès basé sur les rôles. Construisez (ou assemblez le meilleur de chaque catégorie) lorsque votre cas d'utilisation est étroit, que votre pile existante couvre déjà la plupart des capacités, ou que vous avez besoin d'une intégration profonde avec une plateforme de données spécifique. Le risque avec le meilleur de chaque catégorie réside dans les lacunes d'intégration : les métadonnées ne circulent pas automatiquement entre les outils, et vous finissez par maintenir une couche d'orchestration personnalisée qui devient elle-même une charge de maintenance.
Liste de contrôle des exigences non fonctionnelles : évolutivité à votre volume de données, journaux auditable pour la conformité, contrôle d'accès basé sur les rôles, intégration API-first pour l'incorporation dans les pipelines, et préparation à l'IA (la capacité de certifier des jeux de données pour une utilisation par les modèles et de suivre les versions des jeux de données). Pour les équipes construisant des produits de données adjacents à l'IA, un audit structuré des données peut révéler les lacunes de conformité de schéma qui affectent la préparation des LLM avant qu'elles n'atteignent l'étape d'entraînement des modèles.
Normes et cadres à adopter
Vous n'avez pas besoin de mettre en œuvre chaque clause de chaque norme. La valeur des normes est qu'elles vous donnent un vocabulaire prêt pour l'audit et une liste de contrôle des contrôles que vous pourriez autrement manquer.
-
ISO/IEC 5259-3:2024 est la norme la plus directement pertinente pour la GQD axée sur l'analytique et l'apprentissage automatique. Elle définit les exigences de gestion de la qualité des données tout au long du cycle de vie de l'analytique et de l'apprentissage automatique, en mettant l'accent sur des contrôles auditable et des résultats dignes de confiance. Utilisez-la pour valider votre couverture du cycle de vie et pour cadrer les exigences des applications d'IA réglementées ou à enjeux élevés.
-
Cadre DQMS DAMA-NL traduit les contrôles techniques de GQD en une structure de système de gestion : politique, éléments de données critiques, actions d'amélioration, règles, surveillance et certification. Il est particulièrement utile lors de la préparation de la documentation d'audit interne ou lorsqu'une fonction de conformité veut des preuves que la qualité est gérée systématiquement plutôt qu'au cas par cas.
-
Guide de gestion de la qualité des données de l'AISI fournit des conseils pratiques spécifiques à l'IA sur la qualité des annotations, la détection des biais, le contrôle de version et la surveillance des dérives. Traitez-le comme un complément à l'ISO/IEC 5259-3 pour les programmes fortement axés sur l'apprentissage automatique.
-
Conseils d'analystes Gartner et TechTarget offrent des perspectives sur la conception de programmes et l'intégration de la gouvernance utiles pour structurer les conversations avec les dirigeants et les évaluations de fournisseurs.
Comment utiliser ces normes concrètement : choisissez les clauses les plus pertinentes pour votre niveau de maturité actuel, mappez-les à vos contrôles existants et traitez les écarts comme un backlog priorisé. Une mise en œuvre complète de l'ISO est un effort pluriannuel ; utiliser la norme comme liste de contrôle d'audit pour un pilote de 90 jours est immédiatement utile et ne coûte rien.
Comment Ridiculous Engineering aborde les engagements DQM
Les engagements qui réussissent bien partagent un modèle commun : une phase de découverte resserrée, un pilote limité à un domaine, et une passation qui permet à l'équipe du client de gérer le programme sans dépendance continue à une aide externe.
Découverte et cadrage (semaines 1–2) : Nous inventorions les actifs de données, mappons les CDE aux processus métier et identifions les trois à cinq ensembles de données présentant le risque de qualité et l'impact métier les plus élevés. Le résultat est un inventaire priorisé des ensembles de données et un document de cadrage définissant les limites du pilote, les métriques de succès et les rôles.
Profilage et référence (semaines 2–4) : Un profilage automatisé des ensembles de données prioritaires établit des références de complétude, d'unicité, de validité et d'actualité. Nous documentons les résultats dans un rapport de profilage qui devient l'état avant pour le suivi des KPI.
Développement de règles pilotes et automatisation (semaines 4–8) : Nous concevons un ensemble de règles pour le domaine le plus prioritaire, l'implémentons dans la plateforme de données ou l'outillage de pipeline existant du client, et mettons en place un flux de travail de quarantaine et de notification des gestionnaires. Livrables : une bibliothèque de règles, un manuel de remédiation et un pipeline automatisé fonctionnel.
Mise à l'échelle et passation (semaines 8–16) : Nous étendons la couverture à d'autres domaines, mettons en place un catalogue d'ensembles de données certifiés, publions un tableau de bord KPI et organisons des sessions d'intégration avec les propriétaires de données et les gestionnaires. Le livrable final est un programme documenté que l'équipe du client peut exploiter et étendre de manière autonome.
Pièges courants que nous observons et comment nous les traitons :
-
Dépassement du périmètre : Nous fixons la limite du domaine pilote dans le document de cadrage et exigeons une demande de modification formelle pour l'étendre. Cela semble bureaucratique jusqu'à la troisième semaine où quelqu'un veut ajouter six ensembles de données supplémentaires.
-
Absence de propriétaire : Nous exigeons un propriétaire de données nommé pour chaque ensemble de données avant d'écrire une règle. Une règle sans propriétaire est une alerte sans personne pour y répondre.
-
Sous-investissement dans l'automatisation de la remédiation : Les équipes consacrent souvent 80 % de leurs efforts à la rédaction de règles et 20 % à la remédiation. Le ratio devrait être plus proche de 50/50. Un défaut non corrigé qui est détecté à plusieurs reprises est pire pour le moral qu'un défaut qui n'est jamais détecté.
Liste de contrôle pour l'évaluation des fournisseurs : lors de l'évaluation d'un cabinet de conseil ou d'un plan interne, demandez un exemple de rapport de profilage d'une mission antérieure, une bibliothèque de règles avec au moins 10 règles documentées et leur justification métier, un manuel de remédiation avec des chemins d'escalade, et un modèle de tableau de bord KPI. Si un fournisseur ne peut pas produire ces artefacts, il vend du théâtre de gouvernance, pas un programme fonctionnel.
Quoi prioritiser ce trimestre
Trois à cinq actions ciblées apportent plus de valeur qu'une initiative large qui stagne à l'étape de planification.
Pour les sponsors exécutifs :
-
Attribuez un propriétaire de données nommé pour vos cinq principaux ensembles de données cette semaine. Sans propriétaire, chaque autre investissement dans la qualité est fragile.
-
Approuvez un sprint de profilage de 30 jours avec un résultat défini : scores de référence de complétude, d'unicité et de validité pour les CDE.
-
Engagez-vous à un rythme de revue KPI trimestriel avant le début du programme, pas après.
Pour les équipes d'ingénierie et de données :
-
Profilez les cinq ensembles de données qui alimentent vos rapports ou modèles les plus critiques. Documentez les taux de nullité, les taux de doublons et les violations de format.
-
Implémentez trois règles automatisées dans votre pipeline existant : un contrôle de format/expression régulière, un contrôle de nullité/vide et un contrôle d'unicité sur les clés primaires.
-
Mettez en place une file d'attente de quarantaine et une notification de gestionnaire pour les échecs de règles. Même une alerte e-mail simple à un propriétaire nommé est mieux qu'un échec silencieux.
-
Construisez une liste d'ensembles de données certifiés : un registre simple des ensembles de données qui ont passé des seuils de qualité définis et sont approuvés pour une utilisation en aval.
Le article sur le partage de données et la gouvernance de Ridiculous Engineering couvre le côté coordination des parties prenantes de ce travail, qui est souvent le problème le plus difficile que l'implémentation technique.
Ridiculous Engineering construit des programmes DQM qui fonctionnent réellement en production
La plupart des organisations ont déjà les plateformes de données et l'outillage de pipeline nécessaires pour exécuter un programme DQM solide. Ce qui leur manque, c'est l'architecture, la conception des règles et la structure opérationnelle pour le faire fonctionner de manière fiable à grande échelle. C'est cette lacune que Ridiculous Engineering comble.
Nous travaillons avec des équipes de milieu de marché et d'entreprise pour concevoir et mettre en œuvre des systèmes de qualité des données et d'analytique qui sont directement liés aux résultats commerciaux : moins de cycles de rapprochement, un délai d'obtention d'informations plus rapide et des données d'entraînement de modèles que vous pouvez réellement certifier. Nos engagements sont conçus pour livrer un pilote fonctionnel en 30 à 90 jours, avec une passation claire afin que votre équipe possède le programme à long terme.
Si vous êtes prêt à passer du profilage à des contrôles de niveau production, parlez à l'équipe Ridiculous Engineering d'un engagement DQM défini.
Sources
-
Microsoft Purview : catalogue unifié — règles de qualité des données
-
Cadre du système de gestion de la qualité des données — DAMA-NL (2024 v12)
-
Comment élaborer une stratégie de gouvernance des données : 7 étapes clés — TechTarget
FAQ
Qu'est-ce que la gestion de la qualité des données ?
La gestion de la qualité des données est l'ensemble des pratiques, règles et contrôles opérationnels qui maintiennent les données organisationnelles exactes, complètes, cohérentes et adaptées à leur utilisation prévue dans l'analytique, l'IA et les décisions commerciales. Elle couvre l'ensemble du cycle de vie des données, de l'ingestion à l'archivage.
Quels sont les quatre C de la qualité des données ?
Les définitions varient selon les cadres, mais une version courante couvre l'exactitude (précision), l'exhaustivité, la cohérence et l'actualité (rapidité). Ces quatre dimensions apparaissent dans la plupart des cadres DQM comme mesures centrales de la fiabilité des données pour la prise de décision.
Quelles sont les cinq mesures clés de la qualité des données ?
Les mesures les plus largement citées sont l'exactitude, l'exhaustivité, la cohérence, l'actualité et l'unicité. De nombreux programmes ajoutent également la validité (conformité aux formats ou énumérations définis) et l'intégrité (relations référentielles entre les ensembles de données) à mesure que le programme mûrit.
Quels sont les principes fondamentaux de la qualité des données ?
Les quatre principes sur lesquels la plupart des cadres de gouvernance s'accordent sont l'adéquation à l'usage (les données répondent aux besoins de leurs consommateurs), la responsabilité (propriétaires nommés pour chaque ensemble de données), la mesurabilité (la qualité est suivie avec des métriques et des SLA définis) et l'amélioration continue (la qualité est surveillée et corrigée comme une activité opérationnelle continue, et non comme une correction ponctuelle).