Synchronisation des données système : un manuel opérationnel pour les dirigeants techniques et commerciaux
Synchronisation des données système : un manuel opérationnel pour les dirigeants techniques et commerciaux La synchronisation des données système est le processus continu ou planifié de propagation des modifications entre deux ou plusieurs systèmes afin que chaque participant détienne une vue cohérente et convenue des mêmes données.
Synchronisation des données système : un manuel opérationnel pour les dirigeants techniques et commerciaux
La synchronisation des données système est le processus continu ou planifié de propagation des modifications entre deux ou plusieurs systèmes afin que chaque participant détienne une vue cohérente et convenue des mêmes données. Utilisez-la lorsque plusieurs systèmes doivent partager un état en direct ou quasi en direct au fil du temps. Choisissez plutôt la migration lorsque vous avez besoin d’un basculement unique, et la réplication lorsque votre objectif est l’échelle de lecture ou la reprise après sinistre plutôt que la cohérence intersystèmes.
Verdict : Si votre CRM, votre ERP et votre entrepôt de données détiennent chacun une version différente du même enregistrement client, vous avez un problème de synchronisation. La bonne solution commence par une liste de contrôle de préparation à la synchronisation, et non par l’achat d’un outil.
Avant de lire la suite, trois points méritent d’être confirmés :
- Vous avez identifié quel système détient l’enregistrement faisant autorité pour chaque domaine de données.
- Vous savez si votre exigence de latence est de l’ordre de la sous-seconde, des minutes ou des heures.
- Vous disposez d’un plan de restauration si le pipeline de synchronisation produit des enregistrements corrompus ou dupliqués.
Conseil de pro : Réalisez un exercice de cartographie au niveau des champs avant d’évaluer tout outil. Les équipes qui sautent cette étape passent des semaines à adapter les différences de schéma après que le pipeline est déjà en production.
Points clés à retenir
Une synchronisation efficace des données système exige des décisions de gouvernance en amont, et pas seulement le choix d’un outil. La politique de gestion des conflits, le modèle de propriété et la stratégie de surveillance que vous définissez avant d’écrire du code déterminent si le pipeline reste fiable au douzième mois.
| Point | Détails |
|---|---|
| Déclarez la propriété en premier | Attribuez un système faisant autorité par domaine de données avant de sélectionner tout outil ou d’écrire tout code de pipeline. |
| Adaptez le calendrier au besoin métier | La CDC quasi en temps réel couvre la plupart des cas d’usage en entreprise ; réservez le streaming complet d’événements pour les exigences de sous-seconde. |
| Les opérations en masse nécessitent une gestion explicite | Les chargements en masse contournent les déclencheurs de suivi des modifications sauf configuration contraire, créant une dérive silencieuse des données. |
| Surveillez les écarts de réconciliation | Les seules mesures de santé des connecteurs manquent la dérive des données ; ajoutez des comparaisons périodiques de comptage d’enregistrements et de sommes de contrôle. |
| Ridiculous Engineering offre une solution de bout en bout | De l’architecture du pipeline CDC aux programmes de gouvernance et à la surveillance de la production, Ridiculous Engineering couvre l’ensemble du cycle de vie de la livraison de synchronisation. |
Table des matières
- Qu’est-ce que la synchronisation des données système et quel type correspond à votre cas d’usage ?
- Comment la synchronisation est réellement mise en œuvre : méthodes et technologies
- Sur quel modèle d’architecture devriez-vous vous appuyer ?
- Comment résolvez-vous les conflits et gérez-vous l’enregistrement d’or ?
- Liste de contrôle de mise en œuvre : de la conception à la restauration
- Que devriez-vous surveiller et comment détectez-vous les problèmes tôt ?
- Quels outils et plateformes gèrent la synchronisation des données ?
- Considérations sur la sécurité, la confidentialité et la conformité
- Migration vs. synchronisation vs. réplication : quelle stratégie convient ?
- Comment Ridiculous Engineering aborde les programmes de synchronisation complexes
- Sources
- FAQ
Qu'est-ce que la synchronisation des données système, et quel type correspond à votre cas d'usage ?
Le terme industriel est synchronisation des données, parfois abrégé en sync des données. « Synchronisation des données système » décrit le même concept au niveau de la couche d'intégration : maintenir deux ou plusieurs bases de données ou services applicatifs cohérents sans intervention manuelle. Le choix du modèle de synchronisation dépend de deux axes indépendants : la direction et le timing.
Direction : unidirectionnelle, bidirectionnelle et multi-directionnelle
Unidirectionnelle (push/publish) déplace les modifications d'une source unique vers une ou plusieurs cibles. La source est faisant autorité ; les cibles sont des consommateurs en lecture seule. C'est le modèle le plus simple et le bon choix par défaut lorsqu'un système possède clairement les données, comme pousser des commandes confirmées d'un ERP vers un entrepôt de fulfillment.
Bidirectionnelle (active-active) permet aux modifications d'origine dans l'un ou l'autre système et de se propager à l'autre. La synchronisation de comptes CRM-ERP est l'exemple canonique : les commerciaux mettent à jour les contacts dans Salesforce, la finance met à jour les adresses de facturation dans l'ERP, et les deux doivent rester à jour. La synchronisation bidirectionnelle introduit un risque de conflit dès que les deux côtés modifient le même enregistrement avant le cycle de synchronisation suivant.
Multi-directionnelle et hybride étend le modèle à trois systèmes ou plus, ou combine des flux unidirectionnels et bidirectionnels dans le même pipeline. Une plateforme RH peut pousser les données d'effectifs en unidirectionnel vers la finance tout en synchronisant les profils employés en bidirectionnel avec un fournisseur d'identité. La complexité croît rapidement ici, et la charge de gouvernance avec elle.
Timing : temps réel, quasi-temps réel et batch
| Modèle de timing | Latence typique | Meilleure adaptation |
|---|---|---|
| Temps réel / sous-seconde | Moins d'1 seconde | Inventaire POS, flux de trading financier, collaboration en direct |
| Quasi-temps réel | Secondes à minutes | Sync de comptes CRM-ERP, suivi logistique |
| Batch planifié | Minutes à heures | Pipelines analytiques, reporting nocturne, sync d'archives |
La synchronisation en temps réel porte le coût d'infrastructure et opérationnel le plus élevé. Le batch est moins cher et plus simple mais produit des fenêtres de données obsolètes que vos utilisateurs métier finiront par remarquer. Le quasi-temps réel, généralement atteint avec CDC ou streaming d'événements, atteint le point idéal pratique pour la plupart des travaux d'intégration en entreprise.
Astuce pro : Si un stakeholder métier dit qu'il a besoin d'une sync « en temps réel », demandez quelle décision il prend avec ces données et à quel point elles peuvent être obsolètes avant de poser problème. La réponse est presque toujours « cinq minutes suffisent », ce qui ouvre la porte à un design quasi-temps réel bien plus simple.
Comment la sync est réellement implémentée : méthodes et technologies
Cinq méthodes principales couvrent la grande majorité du travail de sync en production. Chacune a un profil de latence distinct, un impact sur le système source et un mode de défaillance.
Capture de données de changement (CDC)
Le CDC lit le journal des transactions de la base de données plutôt que d'interroger les tables, il capture donc chaque insertion, mise à jour et suppression avec une charge minimale sur la source. Un pipeline typique ressemble à ceci :
Journal de transactions de la base source
  → Connecteur CDC (ex. : Debezium)
    → Courtier de messages (ex. : sujet Apache Kafka)
      → Connecteur sink
        → Système cible
Debezium est le connecteur CDC open source le plus déployé. Il prend en charge PostgreSQL, MySQL, SQL Server, MongoDB et d'autres, et publie des événements de changement sur des sujets Kafka avec des informations de schéma intégrées via Confluent Schema Registry ou Apicurio. Apache Kafka fournit le journal durable et ordonné qui découple la source de chaque consommateur en aval, vous pouvez donc ajouter un nouveau sink analytique sans toucher au pipeline source.
Un avertissement critique : les opérations en masse contournent souvent les déclencheurs de suivi des changements sauf si des options comme DÉCLENCHEURS_DE_FEU sont explicitement définis. Un chargement en masse nocturne qui ignore les déclencheurs peut créer une dérive silencieuse des données que votre surveillance peut ne pas détecter rapidement.
Synchronisation par API et webhooks
Interroger une API selon un calendrier est l’approche la plus simple et la source la plus courante de violations de limites de débit. Les webhooks inversent le modèle : le système source pousse une notification lorsqu’un changement se produit, et votre couche d’intégration la traite. Les webhooks sont plus rapides et moins coûteux en quota API, mais ils nécessitent un point de terminaison fiable, une logique de nouvelle tentative et des clés d’idempotence afin que les livraisons en double ne créent pas d’enregistrements en double.
ETL/ELT et traitements par lots
Extract-Transform-Load (ETL) et sa variante moderne ELT restent le bon choix lorsque les exigences de fraîcheur se mesurent en heures plutôt qu’en secondes. Des outils comme dbt, Apache Airflow et Fivetran gèrent la planification, la transformation et le suivi de lignage dont les pipelines par lots ont besoin. L’avantage de coût par rapport au streaming est réel : vous ne payez pour le calcul que pendant la fenêtre de traitement, pas en continu.
Streaming d’événements (style Kafka)
Les approches de streaming d’événements fonctionnent mieux lorsque la fraîcheur sous-seconde et l’ordre sont critiques pour l’activité, mais elles entraînent un coût opérationnel plus élevé et une courbe d’apprentissage plus abrupte. Kafka garantit l’ordre dans une partition, prend en charge la relecture depuis n’importe quel décalage et évolue jusqu’à des millions d’événements par seconde. Le compromis est que vous exploitez désormais un journal distribué, qui nécessite sa propre surveillance, ses politiques de rétention et sa gestion de groupes de consommateurs.
Point clé : Un service d’ordonnancement minimal plus une relecture locale peuvent garantir la convergence sans logique CRDT complexe, mais cela nécessite des fonctions de transaction déterministes et une sémantique de relecture soigneuse. Le package de synchronisation de données d’Adobe démontre ce modèle en production : il attribue un ordre canonique et prend en charge des transitoires locaux optimistes avec une relecture validée par le serveur, atteignant un état multi-client convergent sans la surcharge d’une implémentation CRDT complète.
Transfert basé sur des fichiers
Pour les données binaires volumineuses, les exports d’archives ou les systèmes hérités sans API, le transfert basé sur des fichiers reste pratique. AWS DataSync gère les transferts à grande échelle avec chiffrement en transit et validation d’intégrité de bout en bout, ce qui en fait un choix solide pour les mouvements de données réglementés entre le stockage sur site et le cloud. Pour la synchronisation de fichiers pair à pair, rsync est l’outil standard du monde Unix, bien que les équipes doivent suivre ses correctifs de sécurité attentivement.
Comparaison des méthodes
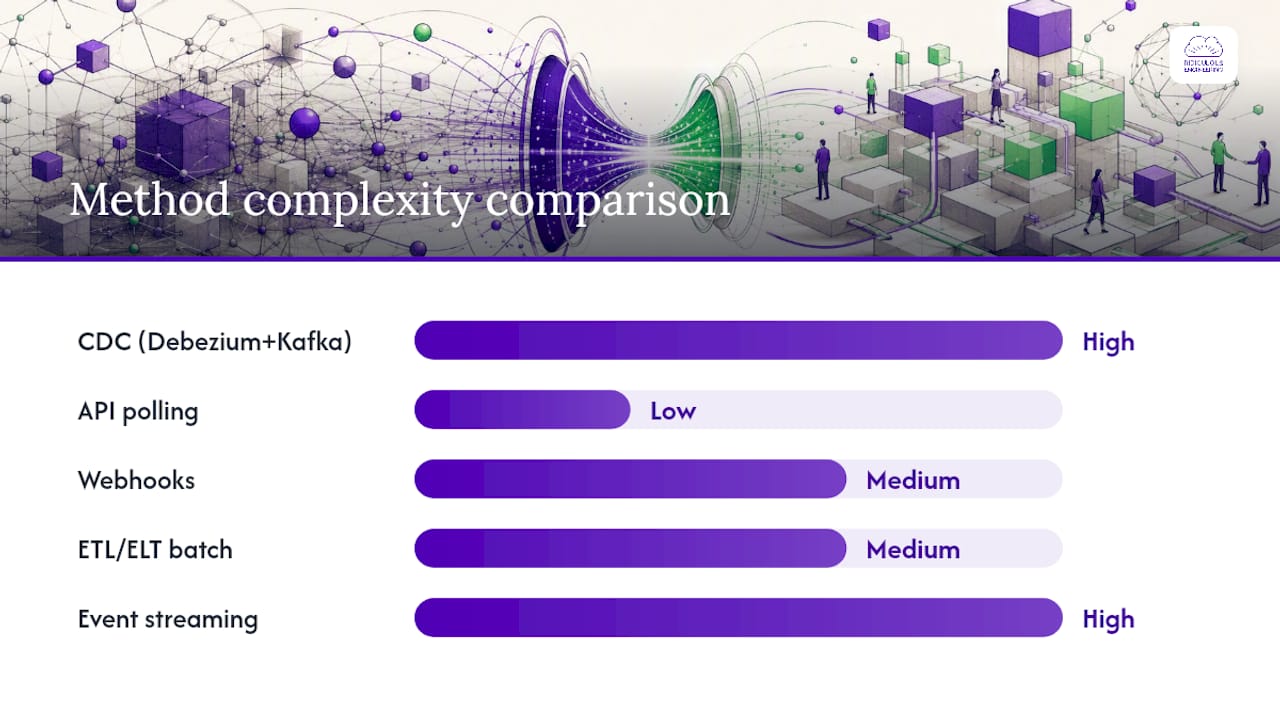
| Méthode | Latence | Impact sur la source | Complexité | Mode de défaillance courant |
|---|---|---|---|---|
| CDC (Debezium + Kafka) | Sous-seconde à secondes | Faible (lecture de journal) | Élevée | Lacunes de rétention du journal, contournement du chargement en masse |
| Interrogation API | Minutes | Moyenne (charge de requêtes) | Faible | Limites de débit, suppressions manquées |
| Webhooks | Secondes | Faible | Moyenne | Livraison en double, indisponibilité du point de terminaison |
| Traitement ETL/ELT par lots | De quelques minutes à quelques heures | Moyen à élevé | Moyen | Dérive de schéma, échecs de travaux |
| Streaming d'événements | Moins d'une seconde | Faible | Élevé | Retard de consommation, déséquilibre de partitions |
| Transfert de fichiers | Heures | Faible | Faible | Échecs d'intégrité, fichiers obsolètes |
Sur quel modèle d'architecture devez-vous vous appuyer ?
La méthode que vous choisissez détermine le flux de données ; le modèle d'architecture détermine qui possède quoi et comment les défaillances se propagent. Quatre modèles couvrent la plupart des déploiements d'entreprise.
Point à point
Chaque système se connecte directement à tous les autres systèmes avec lesquels il doit partager des données. Deux systèmes : une connexion. Cinq systèmes : jusqu'à dix connexions. Le calcul devient vite ingérable, et chaque connexion est une intégration personnalisée probablement construite par une équipe différente. Le point à point est acceptable pour deux ou trois systèmes étroitement couplés où l'équipe possède les deux côtés. Au-delà, cela devient une responsabilité de maintenance.
Étoile
Un hub central médiatise tous les échanges de données. Les spokes se connectent uniquement au hub, pas entre eux. Azure SQL Data Sync est un exemple de production de ce modèle : une base de données hub se synchronise avec les bases de données membres selon un planning configuré, avec une résolution des conflits gérée au niveau du hub. Le hub devient un point unique de défaillance, donc la configuration haute disponibilité du hub n'est pas facultative.
Middleware et iPaaS
Une plateforme d'intégration (MuleSoft, Boomi, Workato, IBM App Connect) se situe entre les systèmes et gère la transformation, le routage, la gestion des erreurs et la logique de nouvelle tentative. Ce modèle convient aux environnements fortement SaaS où vous ne contrôlez pas les schémas source ou cible. Le fournisseur de plateforme gère les connecteurs ; votre équipe gère les flux et la gouvernance. Le modèle basé sur des recettes de Workato et la bibliothèque de connecteurs de niveau entreprise d'IBM sont deux options bien établies dans cet espace.
Principe d'architecture : La propriété de l'enregistrement canonique doit être déclarée avant que le premier octet ne se déplace. Si deux équipes croient chacune que leur système est la source de vérité pour le même champ, aucun modèle d'architecture ne résout ce conflit automatiquement.
Événementiel et streaming
Apache Kafka ou un équivalent géré (Confluent Cloud, Amazon MSK) agit comme le journal durable. Les producteurs publient des événements ; les consommateurs s'abonnent indépendamment. Ce modèle découple complètement les producteurs des consommateurs, prend en charge la relecture et s'adapte horizontalement. Le modèle de serveur de commandes d'Adobe montre comment une variante légère de ce modèle atteint un état convergent pour la synchronisation multi-utilisateurs en temps réel sans déploiement Kafka complet. Le coût opérationnel est réel : vous avez besoin d'une gouvernance de schéma, d'une surveillance des groupes de consommateurs et de politiques de rétention dès le premier jour.
Pour les scénarios pair à pair où le stockage central est indésirable, Syncthing offre un modèle décentralisé et chiffré, bien qu'il échange le contrôle central contre une complexité dans la résolution des conflits et l'auditabilité.
Astuce : Choisissez l'étoile lorsque vous avez besoin d'une piste d'audit simple et d'un propriétaire de conflit clair. Choisissez l'événementiel lorsque vous avez besoin d'une latence inférieure à la seconde sur plus de trois consommateurs. Tout ce qui se situe entre les deux convient généralement bien à l'iPaaS.
Résumé de l'adéquation du modèle
| Modèle | Idéal pour | Isolation des défaillances | Modèle de propriété |
|---|---|---|---|
| Point à point | 2 à 3 systèmes étroitement couplés | Médiocre | Chaque équipe possède sa connexion |
| Étoile | Gouvernance centralisée, charges de travail SQL | Le hub est un point de défaillance unique | L'équipe du hub possède les règles de conflit |
| Middleware / iPaaS | Systèmes hétérogènes axés sur le SaaS | Bon (la plateforme gère les nouvelles tentatives) | Équipe de plateforme + propriétaires de flux |
| Événementiel / streaming | Débit élevé, sous-seconde, nombreux consommateurs | Excellent (indépendance des consommateurs) | Équipe de plateforme + registre de schémas |
Comment résolvez-vous les conflits et gérez-vous l'enregistrement d'or ?
La résolution des conflits est l'endroit où les projets de synchronisation échouent le plus souvent en production. Deux systèmes mettent à jour le même enregistrement avant le prochain cycle de synchronisation, et le pipeline doit décider quelle version gagne. La décision que vous prenez ici a des conséquences en aval pour chaque équipe qui dépend de ces données.
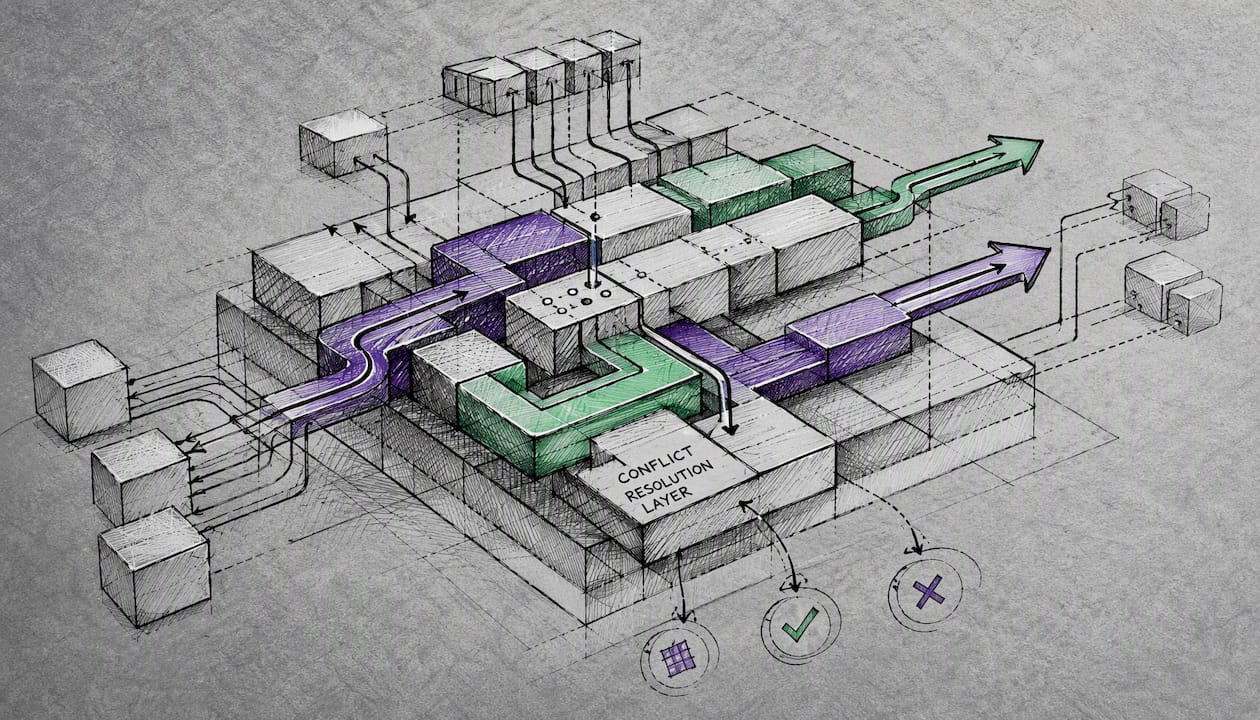
Politiques de conflit courantes
Dernier rédacteur gagne (LWW) applique un horodatage ou un numéro de séquence et conserve la modification la plus récente. Simple à mettre en œuvre, mais il écarte silencieusement les mises à jour légitimes lorsque les horloges sont désynchronisées ou lorsqu'un réseau lent livre une modification plus ancienne après une plus récente.
Hub gagne / Membre gagne sont les deux politiques qu'Azure SQL Data Sync expose. « Hub gagne » signifie que la version de la base de données du hub écrase toujours les modifications des membres en cas de conflit. « Membre gagne » fait l'inverse. Aucune n'est universellement correcte ; le bon choix dépend du système auquel votre entreprise fait le plus confiance pour un domaine de données donné.
Source de vérité par domaine attribue la propriété au niveau du champ ou de l'entité. L'adresse de facturation du client appartient à l'ERP ; les préférences de contact du client appartiennent au CRM. Les conflits au sein d'un domaine vont au propriétaire désigné ; les conflits inter-domaines n'existent pas par définition. C'est la politique la plus durable et la plus difficile à mettre en œuvre sans travail de gouvernance préalable.
L'approche de l'enregistrement d'or
Un enregistrement d'or est la version unique convenue d'une entité, assemblée à partir des champs les plus fiables de tous les systèmes contributeurs. Son opérationnalisation nécessite trois choses : un gestionnaire de données qui possède la décision de rapprochement pour chaque domaine, un schéma qui marque explicitement quel système est faisant autorité par champ, et une exécution de rapprochement planifiée qui compare l'enregistrement d'or à tous les systèmes contributeurs et signale les divergences.
Matrice de décision de résolution des conflits
| Priorité commerciale | Politique recommandée | Risque à gérer |
|---|---|---|
| Fraîcheur avant exactitude | Dernier rédacteur gagne | Désynchronisation des horloges, livraison hors ordre |
| Exactitude avant fraîcheur | Source de vérité par domaine | Latence, mappage inter-domaines |
| Débit avant l'un ou l'autre | Hub gagne (règle simple) | Mises à jour légitimes des membres écrasées |
| Auditabilité requise | Versionnage au niveau du champ + journal d'audit | Coût de stockage, complexité des requêtes |
Astuce : Recherche sur la gestion des conflits de la Harvard’s Program on Negotiation constate systématiquement que les approches collaboratives fondées sur les intérêts produisent des accords plus durables que des règles rigides. Appliquez la même logique à la gouvernance des synchronisations : lorsque deux équipes se disputent la propriété d’un champ de données, facilitez une conversation sur ce dont chaque équipe a réellement besoin de ce champ plutôt que d’imposer une règle technique. La politique qui en résulte durera plus longtemps et générera moins d’escalades.
Lorsque les équipes traitent la résolution de conflits comme un problème de négociation, elles produisent une gouvernance plus durable qu’en s’appuyant uniquement sur le dernier écrit gagne.
Liste de contrôle de gouvernance
- Attribuez un responsable de données nommé par domaine avec une autorité documentée pour résoudre les litiges.
- Définissez des SLA pour la fraîcheur des synchronisations (par exemple, synchronisation des comptes CRM vers ERP dans les 5 minutes suivant un changement).
- Conservez une piste d’audit de chaque décision de résolution de conflit, pas seulement la valeur gagnante.
- Planifiez des exécutions de réconciliation au moins quotidiennement ; comparez les comptes de enregistrements et les sommes de contrôle des champs clés.
- Documentez un chemin d’escalade pour les conflits que la politique automatisée ne peut pas résoudre.
Liste de contrôle de mise en œuvre : de la conception au rollback
Un projet de synchronisation qui saute les étapes de conception le paie en incidents de production. La liste ci-dessous couvre les phases où les équipes coupent le plus souvent les coins ronds.
Phase de conception
- Cartographiez chaque système source et cible, y compris le propriétaire, la version du schéma et la fréquence de mise à jour.
- Effectuez un mapping au niveau des champs : identifiez les incompatibilités de types, les différences de nullabilité et les incohérences d’encodage avant d’écrire une ligne de code.
- Déclarez le système faisant autorité pour chaque entité et champ synchronisé.
- Concevez pour l’idempotence dès le départ : chaque opération de synchronisation doit produire le même résultat qu’elle s’exécute une fois ou dix fois.
- Définissez la politique de résolution de conflits par domaine et documentez-la dans un registre de décisions partagé.
Phase d’ingénierie
- Implémentez la gestion de l’évolution du schéma : utilisez un registre de schémas (Confluent Schema Registry, AWS Glue Schema Registry) pour que les consommateurs ne cassent pas lorsqu’un producteur ajoute un champ.
- Construisez une logique de nouvelle tentative avec backoff exponentiel et une file de lettres mortes pour les messages qui échouent de manière répétée.
- Gérez explicitement la sémantique transactionnelle : décidez si vous avez besoin d’une livraison exactement une fois, au moins une fois, ou au plus une fois, et choisissez votre transport en conséquence.
- Testez les chemins de chargement en masse séparément. Les opérations en masse peuvent contourner les déclencheurs de suivi des modifications sauf configuration contraire, créant une dérive silencieuse.
- Implémentez la gestion des limites de débit pour les connecteurs basés sur API : reculez gracieusement et exposez l’épuisement du quota comme une erreur nommée, pas un échec silencieux.
Plan du plan de test
- Tests unitaires : validez la logique de transformation, le mapping des champs et les règles de résolution de conflits en isolation.
- Tests d’intégration : exécutez-les sur un jeu de données proche de la production ; vérifiez les comptes de enregistrements, les sommes de contrôle et la latence par rapport aux cibles SLA.
- Tests de chaos et de défaillance : tuez le courtier de messages en plein lot, introduisez des partitions réseau et vérifiez que le pipeline récupère sans perte ni duplication de données.
- Répétition du basculement : exécutez la séquence complète de basculement dans un environnement de staging au moins deux fois avant la production.
Rollback et atténuation
- Utilisez des indicateurs de fonctionnalité ou des interrupteurs d’activation de synchronisation pour pouvoir désactiver un pipeline sans déploiement de code.
- Prenez un instantané des systèmes cibles immédiatement avant le basculement ; conservez-le pendant au moins un cycle complet de réconciliation.
- Concevez la capacité de relecture dans le pipeline afin de pouvoir retraiter les événements à partir d’un offset connu bon.
- Définissez un SLA de rollback : combien de temps l’entreprise peut-elle tolérer de fonctionner sur des données obsolètes pendant que vous récupérez ?
Astuce : Les équipes qui récupèrent le plus rapidement des échecs de synchronisation sont celles qui ont pratiqué le rollback avant d’en avoir besoin. Planifiez un exercice de chaos en staging avant votre premier basculement en production.
Que devez-vous surveiller et comment détecter les problèmes à un stade précoce ?
Les défis opérationnels courants dans les projets de synchronisation incluent les écarts de latence, la dérive de schéma, les enregistrements en double dus aux nouvelles tentatives, le retard CDC, les limites de débit API et les données obsolètes que les utilisateurs métier détectent avant l’équipe d’ingénierie. Une surveillance qui ne mesure que la santé des connecteurs manque la plupart de ces problèmes.
Métriques essentielles
- Retard de synchronisation : temps entre une modification dans la source et son arrivée à la cible. Alertez lorsque le retard dépasse votre seuil SLA.
- Taux de succès/échec : pourcentage d’opérations de synchronisation terminées sans erreur. Une chute soudaine est le premier signal d’un problème systémique.
- Débit : événements ou enregistrements par seconde. Des baisses inattendues indiquent des ralentissements en amont ou un retard de consommation.
- Nombre de doublons : enregistrements traités plus d’une fois. Un taux de doublons en hausse signale un manque d’idempotence ou une mauvaise configuration des nouvelles tentatives.
- Écart de réconciliation : comparaison périodique des comptes d’enregistrements et des sommes de contrôle des champs clés entre les systèmes faisant autorité. C’est la métrique qui détecte la dérive que les métriques au niveau du connecteur manquent.
- Alertes de changement de schéma : se déclenchent sur tout changement DDL d’une table synchronisée ou d’un schéma de sujet.
Seuils d’alerte et escalade
Commencez avec ces valeurs par défaut raisonnables, puis ajustez en fonction de votre SLA :
- Le retard dépasse 2 fois votre objectif SLA pendant plus de 3 minutes consécutives : pagez l’ingénieur d’astreinte.
- Taux d’erreur supérieur à 1 % sur une fenêtre de 5 minutes : nouvelle tentative automatique ; escaladez à un humain si non résolu après 15 minutes.
- Écart de réconciliation supérieur à 0,1 % du nombre total d’enregistrements : ouvrez un incident et exécutez un travail de réconciliation ciblé.
- Changement de schéma détecté sur une table synchronisée : mettez en pause le pipeline, notifiez l’équipe propriétaire et exigez une reprise délibérée.
Instruments d’observabilité
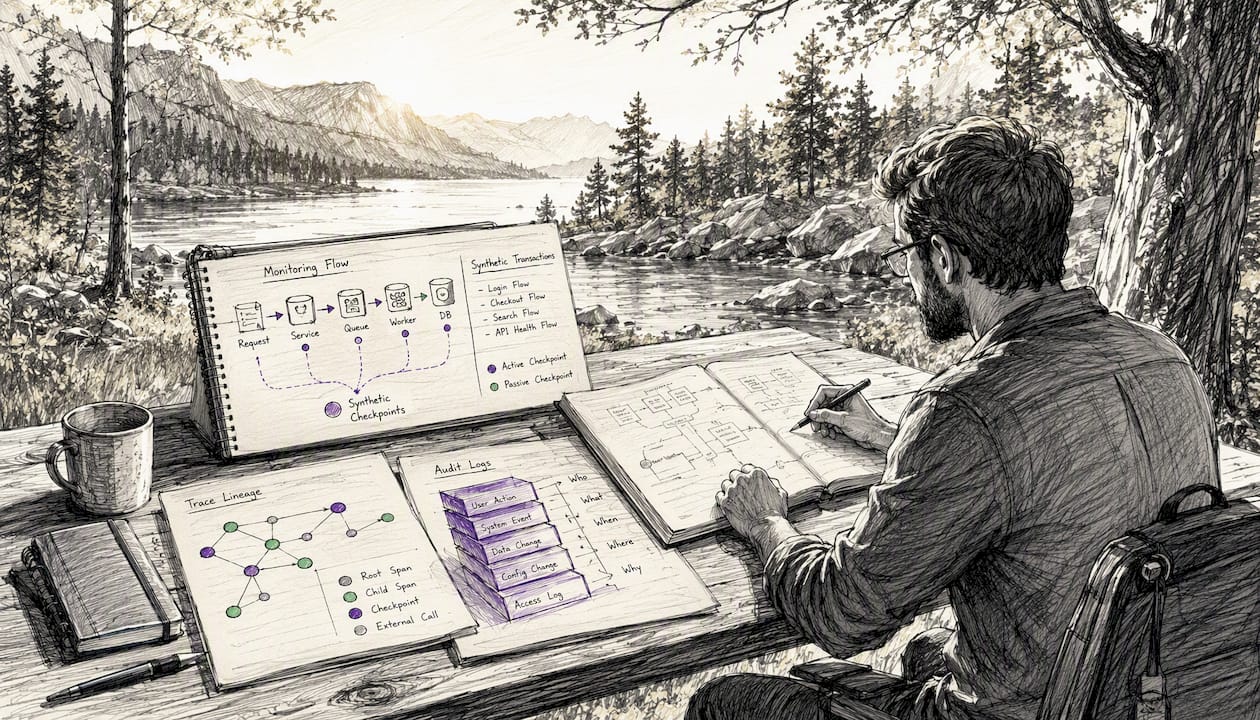
Les contrôles de santé au niveau du connecteur sont nécessaires mais pas suffisants. Ajoutez des transactions de bout en bout synthétiques : injectez un enregistrement de test connu dans la source selon un calendrier et vérifiez qu’il arrive à la cible dans votre fenêtre SLA. Ajoutez le traçage de lignée pour pouvoir retracer tout enregistrement à travers chaque transformation qu’il a subie. Les journaux d’audit doivent capturer non seulement ce qui a changé, mais qui ou quel système a initié le changement.
Quels outils et plateformes gèrent la synchronisation des données ?
La catégorie d’outils dont vous avez besoin dépend de vos systèmes source et cible, de votre exigence de latence et de la capacité opérationnelle de votre équipe. Le CDC et le streaming d’événements sont les approches standard pour la synchronisation quasi en temps réel ; les plateformes iPaaS conviennent à l’intégration SaaS-à-SaaS ; les outils de fichiers gèrent les transferts en masse et binaires.
Aperçu de la catégorie d’outils
iPaaS (plateforme d’intégration en tant que service) : Workato, IBM App Connect, Skyvia et MuleSoft Anypoint Platform entrent tous dans cette catégorie. Ces plateformes fournissent des connecteurs préconstruits pour des centaines d’applications SaaS, des concepteurs de flux visuels et une gestion des nouvelles tentatives/erreurs. Le modèle de recettes de Workato convient aux équipes opérationnelles qui doivent créer des flux sans implication approfondie de l’ingénierie. IBM App Connect apporte une gouvernance de niveau entreprise et une bibliothèque de connecteurs couvrant les systèmes mainframe et hérités que la plupart des fournisseurs iPaaS ignorent. Skyvia offre une option cloud-native plus légère avec un fort support pour la synchronisation base de données vers cloud à un prix inférieur.
CDC et réplication de base de données : Debezium (open source, natif Kafka) et Azure SQL Data Sync (géré, hub-and-spoke) sont les options principales pour la synchronisation base de données à base de données. Debezium vous donne un contrôle total et s’intègre nativement avec Apache Kafka. Azure SQL Data Sync échange la flexibilité contre la simplicité : configurez un groupe de synchronisation, définissez un calendrier, et le service gère le reste dans l’écosystème Azure.
Streaming d’événements : Apache Kafka (auto-géré ou via Confluent Cloud, Amazon MSK ou Azure Event Hubs) est la norme de production pour la synchronisation à haut débit sous la seconde. La complexité opérationnelle est élevée ; les services gérés la réduisent considérablement.
Transfert de fichiers et en masse : AWS DataSync gère le déplacement sécurisé de fichiers à grande échelle entre sur site et cloud avec validation d’intégrité. Rsync reste la norme pour la synchronisation de fichiers Unix à Unix.
Dimensions d’évaluation
| Outil / catégorie | Idéal pour | Directionnalité | Temps de traitement | Déploiement | Complexité opérationnelle | Modèle de coût |
|---|---|---|---|---|---|---|
| Workato | Automatisation SaaS-à-SaaS | Unidirectionnel, bidirectionnel | Quasi-temps réel | Cloud | Faible (constructeur visuel) | Par recette / consommation |
| IBM App Connect | Entreprise, systèmes hérités | Unidirectionnel, bidirectionnel, multi | Quasi-temps réel, par lots | Cloud, sur site, hybride | Moyenne à élevée | Licence + consommation |
| Skyvia | Synchronisation DB-à-cloud, SaaS | Unidirectionnel, bidirectionnel | Quasi-temps réel, par lots | Cloud | Faible à moyenne | Niveaux d'abonnement |
| Apache Kafka + Debezium | CDC de base de données, streaming à haut débit | Unidirectionnel, multi | Sous-seconde à secondes | Cloud, sur site, hybride | Élevée | Infrastructure + exploitation |
| Azure SQL Data Sync | Synchronisation SQL Server / Azure SQL | Bidirectionnel (hub-spoke) | Quasi-temps réel, par lots | Cloud, hybride | Faible à moyenne | Consommation Azure |
| AWS DataSync | Migration de fichiers en masse / stockage | Unidirectionnel | Par lots, planifié | Cloud, hybride | Faible | Par Go transféré |
Astuce pro : Pour les petits environnements (moins de 5 systèmes, fortement SaaS), commencez avec un iPaaS comme Workato ou Skyvia. Pour les environnements moyens avec un mélange de bases de données et de SaaS, ajoutez Debezium et Kafka pour la couche base de données. Pour les exigences à grande échelle, sous-secondes, sur de nombreux consommateurs, un service Kafka entièrement géré avec un registre de schémas est la seule architecture qui tient sous charge.
Lorsque la complexité de l'intégration dépasse ce que votre équipe peut maintenir en interne, la décision de faire appel à un intégrateur se rentabilise rapidement. Le travail de Ridiculousengineering en ingénierie d'intégration de systèmes et de synchronisation personnalisée couvre toute la pile, de l'architecture au support de production.
Considérations sur la sécurité, la confidentialité et la conformité
La sécurité est l'endroit où les projets de synchronisation créent le plus souvent une exposition involontaire. Les données qui circulent entre les systèmes traversent les frontières du réseau, passent par des connecteurs avec des informations d'identification stockées et atterrissent dans des cibles qui peuvent avoir des contrôles d'accès plus faibles que la source.
Contrôles fondamentaux
- Chiffrement en transit : TLS 1.2 ou supérieur sur chaque connecteur, chaque saut. Aucune exception pour les segments de réseau internes.
- Authentification et autorisation : utilisez des comptes de service avec accès au moindre privilège. Un connecteur de synchronisation qui lit les données client ne doit pas avoir accès en écriture aux tables financières.
- Gestion des clés et des secrets : stockez les informations d'identification des connecteurs dans un gestionnaire de secrets (AWS Secrets Manager, HashiCorp Vault, Azure Key Vault), pas dans des fichiers de configuration ou des variables d'environnement vérifiées dans le contrôle de source.
- Rotation des secrets : faites pivoter les informations d'identification des connecteurs selon un calendrier défini et après tout changement de personnel qui y avait accès.
Minimisation des données et données réglementées
Synchronisez uniquement les champs dont vous avez besoin. Synchroniser un enregistrement client complet alors que le système cible n'a besoin que du nom et de l'e-mail double votre surface d'exposition sans valeur commerciale. Pour les données réglementées, la surface d'exposition est également une surface de conformité.
Les données de santé américaines sont soumises aux obligations HIPAA : toute conception de synchronisation qui touche aux informations de santé protégées (PHI) doit inclure le chiffrement, les contrôles d'accès et les pistes d'audit pour soutenir la conformité. Cela s'applique au pipeline lui-même, pas seulement aux points de terminaison. Un sujet Kafka qui transporte des PHI est un stockage de PHI et doit être traité en conséquence.
Pour les données réglementées non liées à la santé, PCI DSS régit les données de cartes de paiement, et CCPA impose des obligations de droits des personnes concernées sur les données des consommateurs californiens. Les deux ont des implications sur la durée de conservation des données synchronisées et qui peut y accéder.
Liste de contrôle de sécurité
| Contrôle | S'applique à | Note de mise en œuvre |
|---|---|---|
| TLS en transit | Tous les connecteurs | Imposer un minimum TLS 1.2 ; désactiver les suites de chiffrement héritées |
| Comptes de service au moindre privilège | Tous les connecteurs | Séparer les comptes de lecture et d'écriture par pipeline |
| Intégration du gestionnaire de secrets | Tout stockage d'informations d'identification | Ne stockez jamais d'identifiants dans le code ou les fichiers de configuration |
| Masquage au niveau des champs | Données réglementées (PHI, PCI) | Masquez au niveau du connecteur avant d'écrire vers des cibles non réglementées |
| Journalisation d'audit | Tous les pipelines | Consignez la source, la cible, l'horodatage, l'ID d'enregistrement et le type d'opération |
| Calendrier de rotation des secrets | Tous les identifiants | Minimum annuel ; trimestriel pour les pipelines à haute sensibilité |
| Politique de conservation des données | Tous les magasins synchronisés | Alignez la conservation sur la réglementation la plus restrictive applicable |
Migration ou synchronisation ou réplication : quelle stratégie choisir ?
Ces trois termes sont souvent utilisés de manière interchangeable, mais ils décrivent des stratégies fondamentalement différentes avec des engagements opérationnels différents.
Migration est une opération ponctuelle et limitée : déplacez les données du système A vers le système B, validez-les et décommissionnez A. L'objectif est un basculement propre. Des outils comme AWS DataSync et les utilitaires d'export/import natifs de bases de données gèrent bien cela. La migration est le bon choix lorsque vous retirez un système, pas lorsque vous l'intégrez.
Réplication copie les données en continu d'une source primaire vers une ou plusieurs répliques, généralement pour la mise à l'échelle en lecture ou la reprise après sinistre. La réplique n'est pas un participant indépendant ; c'est une copie. La réplication de flux PostgreSQL et la réplication de binlog MySQL sont les mécanismes standard. La réplication est le bon choix lorsque votre objectif est la disponibilité ou le débit en lecture, pas le partage de données entre systèmes.
Synchronisation maintient deux ou plusieurs systèmes indépendants cohérents au fil du temps. Chaque système peut être à l'origine de modifications. La synchronisation est le bon choix lorsque plusieurs applications doivent lire et écrire le même domaine de données logique, et qu'aucune ne peut être subordonnée aux autres.
Flux de décision
- Basculement à court terme avec retrait du système : choisissez la migration.
- Mise à l'échelle en lecture ou reprise après sinistre au sein d'une pile applicative unique : choisissez la réplication.
- Cohérence à long terme entre systèmes indépendants : choisissez la synchronisation.
- Reprise après sinistre plus intégration inter-systèmes : combinez la réplication pour la HA avec la synchronisation pour l'intégration des charges de travail.
- Migration vers une nouvelle plateforme tout en gardant l'ancienne active pendant la transition : migrez d'abord, puis exécutez la synchronisation en parallèle jusqu'à la date de basculement, puis décommissionnez.
Le écart de partage de données entre les systèmes est presque toujours un problème de gouvernance avant d'être un problème technologique. Choisir la bonne stratégie tôt évite des mois de reprise.
Comment Ridiculous Engineering aborde les programmes de synchronisation complexes
Les équipes qui ont cartographié leurs sources, choisi une architecture et rédigé une politique de conflit font toujours face à un problème difficile : construire et exploiter un pipeline de synchronisation de production est un travail d'ingénierie, pas un travail de configuration. La différence entre un pipeline qui tient sous charge et un qui dérive silencieusement apparaît dans les détails : conception de l'idempotence, gestion de l'évolution du schéma, tests de chaos et surveillance qui détecte la dérive avant les utilisateurs métier.
Les services d'intégration personnalisée et d'ingénierie de synchronisation de Ridiculous Engineering couvrent l'ensemble du cycle de vie de la livraison : conception d'architecture, implémentation de pipeline CDC, infrastructure de flux d'événements, mise en place de programme de gouvernance, planification des tests et surveillance de production. Nous travaillons avec les outils que votre équipe utilise déjà ou vous aidons à choisir ceux qui conviennent à votre échelle et vos contraintes.
Les résultats pratiques que les clients peuvent attendre incluent une réduction de la dérive des données, des garanties de fraîcheur basées sur des SLA, des procédures de restauration reproductibles et des pistes d'audit qui satisfont aux examens réglementaires. Nous aidons également les équipes à construire les structures de gouvernance et les accords inter-équipes qui maintiennent les pipelines en bonne santé après la livraison initiale.
Si votre équipe planifie un programme de synchronisation ou en hérite un qui montre déjà des signes de dérive, contactez-nous pour démarrer une conversation. Nous vous aiderons à déterminer ce dont vous avez réellement besoin avant de recommander comment le construire.
Sources
Les sources ci-dessous méritent d'être mises en signet pour une lecture technique et réglementaire plus approfondie :
- sql-data-sync-data-sql-server-sql-database?view=azuresql
- Styles de gestion des conflits : pièges et meilleures pratiques - PON - Programme de négociation à la Harvard Law School
- Les outils de synchronisation de données maintiennent les informations cohérentes entre plusieurs systèmes, bases de données et environnements cloud automatiquement
- adobe/synchronisation des données (GitHub)
- AWS DataSync
- Health Insurance Portability and Accountability Act (HIPAA) - CDC
FAQ
Que se passe-t-il si je désactive la synchronisation ?
La désactivation d'un pipeline de synchronisation arrête la propagation des modifications entre les systèmes, de sorte que chaque système continue d'accumuler des mises à jour de manière indépendante. Lorsque vous réactivez la synchronisation, le pipeline doit réconcilier la divergence et, selon votre politique de conflit, certaines mises à jour peuvent être écrasées.
Pourquoi mes données ne se synchronisent-elles pas entre les systèmes ?
Les causes les plus courantes sont l'expiration des identifiants de connecteur, l'épuisement des limites de débit API, les modifications de schéma qui cassent le pipeline et les opérations de chargement en masse qui contournent les déclencheurs de suivi des modifications. Vérifiez d'abord les journaux du connecteur et les écarts de réconciliation.
La synchronisation doit-elle être activée ou désactivée par défaut ?
Activée, pour toute intégration où les opérations commerciales dépendent de données cohérentes entre les systèmes. Désactivée n'est approprié que lors d'une maintenance planifiée, d'un événement de restauration ou d'une pause délibérée pendant qu'une migration de schéma est appliquée.
Comment arrêter un pipeline de synchronisation en toute sécurité ?
Utilisez un indicateur de fonctionnalité ou un interrupteur d'activation de synchronisation pour mettre en pause le pipeline sans déploiement de code, prenez un instantané de l'état actuel du système cible et documentez le décalage ou le point de contrôle afin de pouvoir reprendre à partir d'une position connue sans retraiter ni perdre d'événements.
Quelle est la différence entre CDC et ETL pour la synchronisation ?
Le CDC lit le journal des transactions de la base de données en continu et capture chaque modification avec un faible impact sur la source, ce qui le rend adapté à la synchronisation quasi en temps réel. L'ETL interroge la source selon un calendrier, ce qui est plus simple à exploiter mais produit des fenêtres obsolètes et ajoute une charge de requête au système source à chaque exécution.
Recommandé
- Croissance transformatrice avec le cloud computing | Ridiculous Engineering | Ridiculous Engineering
- Combler l'écart de partage des données : une voie vers la réussite de la mission | Ridiculous Engineering
- Exploiter les forces technologiques macro : comment Ridiculous Engineering stimule la réussite commerciale | Ridiculous Engineering