System Data Sync: An Operational Playbook for Engineering and Business Leaders
System Data Sync: An Operational Playbook for Engineering and Business Leaders La sincronizzazione dei dati di sistema è il processo continuo o programmato di propagare le modifiche tra due o più sistemi, così che ogni partecipante mantenga una visione coerente e concordata degli stessi dati.
System Data Sync: An Operational Playbook for Engineering and Business Leaders
La sincronizzazione dei dati di sistema è il processo continuo o programmato di propagare le modifiche tra due o più sistemi, così che ogni partecipante mantenga una visione coerente e concordata degli stessi dati. Usala quando più sistemi devono condividere uno stato live o quasi-live nel tempo. Scegli invece la migrazione quando hai bisogno di un passaggio una tantum, e scegli la replica quando il tuo obiettivo è la scala di lettura o il disaster recovery piuttosto che la coerenza tra sistemi.
Verdetto: Se il tuo CRM, ERP e data warehouse contengono ciascuno una versione diversa dello stesso record cliente, hai un problema di sincronizzazione. La soluzione giusta inizia con una checklist di prontezza alla sincronizzazione, non con l'acquisto di uno strumento.
Prima di leggere oltre, vale la pena confermare tre cose:
- Hai identificato quale sistema possiede il record autorevole per ogni dominio di dati.
- Sai se il tuo requisito di latenza è sub-secondo, minuti o ore.
- Hai un piano di rollback se la pipeline di sincronizzazione produce record corrotti o duplicati.
Consiglio da esperti: Esegui un esercizio di mappatura a livello di campo prima di valutare qualsiasi strumento. I team che saltano questo passaggio spendono settimane a riadattare le differenze di schema dopo che la pipeline è già in produzione.
Punti Chiave
Una sincronizzazione efficace dei dati di sistema richiede decisioni di governance a monte, non solo la selezione dello strumento. La politica di conflitto, il modello di proprietà e la strategia di monitoraggio che definisci prima di scrivere codice determinano se la pipeline rimane affidabile al dodicesimo mese.
| Punto | Dettagli |
|---|---|
| Dichiara prima la proprietà | Assegna un sistema autorevole per ogni dominio di dati prima di selezionare qualsiasi strumento o scrivere qualsiasi codice di pipeline. |
| Abbina i tempi alle esigenze aziendali | Il CDC quasi in tempo reale copre la maggior parte dei casi aziendali; riserva lo streaming completo di eventi per requisiti sub-secondo. |
| Le operazioni bulk richiedono una gestione esplicita | I caricamenti bulk bypassano i trigger di tracciamento delle modifiche se non configurati diversamente, creando una deriva silenziosa dei dati. |
| Monitora i delta di riconciliazione | Le metriche di salute del connettore da sole non rilevano la deriva dei dati; aggiungi confronti periodici di conteggio record e checksum. |
| Ridiculous Engineering offre una copertura end-to-end | Dall'architettura della pipeline CDC ai programmi di governance e al monitoraggio della produzione, Ridiculous Engineering copre l'intero ciclo di vita della consegna della sincronizzazione. |
Indice
- Cos'è la sincronizzazione dei dati di sistema e quale tipo si adatta al tuo caso d'uso?
- Come viene effettivamente implementata la sincronizzazione: metodi e tecnologie
- Su quale modello architetturale dovresti costruire?
- Come risolvi i conflitti e governi il record d'oro?
- Checklist di implementazione: dalla progettazione al rollback
- Cosa dovresti monitorare e come cogli i problemi in anticipo?
- Quali strumenti e piattaforme gestiscono la sincronizzazione dei dati?
- Considerazioni su sicurezza, privacy e conformità
- Migrazione vs. sincronizzazione vs. replica: quale strategia si adatta?
- Come Ridiculous Engineering affronta programmi di sincronizzazione complessi
- Fonti
- FAQ
Che cos'è la sincronizzazione dei dati di sistema e quale tipo si adatta al tuo caso d'uso?
Il termine di settore è sincronizzazione dei dati, a volte abbreviato in sincronizzazione dati. “Sincronizzazione dei dati di sistema” descrive lo stesso concetto a livello di integrazione: mantenere due o più database o servizi applicativi coerenti senza intervento manuale. La scelta del modello di sincronizzazione dipende da due assi indipendenti: direzione e temporizzazione.
Direzione: unidirezionale, bidirezionale e multi-direzionale
Unidirezionale (push/publish) sposta le modifiche da una singola sorgente a una o più destinazioni. La sorgente è autorevole; le destinazioni sono consumatori di sola lettura. Questo è il modello più semplice e il default giusto quando un sistema possiede chiaramente i dati, come l'invio di ordini confermati da un ERP a un magazzino di evasione.
Bidirezionale (active-active) consente alle modifiche di originare in entrambi i sistemi e propagarsi all'altro. La sincronizzazione account CRM-ERP è l'esempio canonico: i rappresentanti di vendita aggiornano i contatti in Salesforce, la finanza aggiorna gli indirizzi di fatturazione nell'ERP, ed entrambi devono rimanere aggiornati. La sincronizzazione bidirezionale introduce il rischio di conflitti nel momento in cui entrambe le parti modificano lo stesso record prima del ciclo di sincronizzazione successivo.
Multi-direzionale e ibrida estende il modello a tre o più sistemi, o combina flussi unidirezionali e bidirezionali nella stessa pipeline. Una piattaforma HR potrebbe inviare dati sull'organico in modo unidirezionale alla finanza mentre sincronizza i profili dei dipendenti in modo bidirezionale con un provider di identità. La complessità cresce rapidamente qui, e il sovraccarico di governance cresce con essa.
Temporizzazione: in tempo reale, quasi in tempo reale e batch
| Modello di temporizzazione | Latenza tipica | Adatto per |
|---|---|---|
| Tempo reale / sub-secondo | Sotto 1 secondo | Inventario POS, feed di trading finanziario, collaborazione live |
| Quasi in tempo reale | Da secondi a minuti | Sincronizzazione account CRM-ERP, tracciamento logistico |
| Batch pianificato | Da minuti a ore | Pipeline analitiche, report notturni, sincronizzazione archivi |
La sincronizzazione in tempo reale comporta i costi infrastrutturali e operativi più elevati. Il batch è più economico e semplice ma produce finestre di dati obsoleti che i tuoi utenti aziendali noteranno prima o poi. Il quasi in tempo reale, tipicamente ottenuto con CDC o streaming di eventi, rappresenta il punto dolce pratico per la maggior parte del lavoro di integrazione aziendale.
Suggerimento professionale: Se uno stakeholder aziendale dice di aver bisogno di sincronizzazione “in tempo reale”, chiedi quale decisione prende con quei dati e quanto possono essere obsoleti prima che causino un problema. La risposta è quasi sempre “cinque minuti vanno bene”, il che apre la porta a un design quasi in tempo reale molto più semplice.
Come viene effettivamente implementata la sincronizzazione: metodi e tecnologie
Cinque metodi principali coprono la stragrande maggioranza del lavoro di sincronizzazione in produzione. Ognuno ha un profilo di latenza distinto, un impatto sul sistema sorgente e una modalità di errore.
Change data capture (CDC)
Il CDC legge il log delle transazioni del database piuttosto che interrogare le tabelle, quindi cattura ogni inserimento, aggiornamento ed eliminazione con un carico minimo sulla sorgente. Una pipeline tipica appare così:
Log transazioni DB sorgente
  → Connettore CDC (es., Debezium)
    → Broker di messaggi (es., topic Apache Kafka)
      → Connettore sink
        → Sistema di destinazione
Debezium è il connettore CDC open-source più ampiamente distribuito. Supporta PostgreSQL, MySQL, SQL Server, MongoDB e altri, e pubblica eventi di modifica su topic Kafka con informazioni sullo schema incorporate tramite Confluent Schema Registry o Apicurio. Apache Kafka fornisce il log durevole e ordinato che disaccoppia la sorgente da ogni consumatore a valle, così puoi aggiungere un nuovo sink analitico senza toccare la pipeline sorgente.
Un avvertimento critico: le operazioni bulk spesso bypassano i trigger di tracciamento delle modifiche a meno che opzioni come FIRE_TRIGGERS sono impostati esplicitamente. Un caricamento notturno di massa che salta i trigger può creare una deriva silenziosa dei dati che il monitoraggio potrebbe non rilevare tempestivamente.
Sincronizzazione tramite API e webhook
Interrogare un'API secondo una pianificazione è l'approccio più semplice e la fonte più comune di violazioni dei limiti di frequenza. I webhook invertono il modello: il sistema sorgente invia una notifica quando si verifica una modifica e il livello di integrazione la elabora. I webhook sono più veloci ed economici sulla quota API, ma richiedono un endpoint affidabile, logica di retry e chiavi di idempotenza affinché le consegne duplicate non creino record duplicati.
ETL/ELT e processi batch
Extract-Transform-Load (ETL) e la sua variante moderna ELT rimangono la scelta giusta quando i requisiti di freschezza sono misurati in ore piuttosto che in secondi. Strumenti come dbt, Apache Airflow e Fivetran gestiscono la pianificazione, la trasformazione e il tracciamento della lineage di cui i pipeline batch hanno bisogno. Il vantaggio in termini di costi rispetto allo streaming è reale: si paga per il calcolo solo durante la finestra del processo, non in modo continuo.
Streaming di eventi (stile Kafka)
Gli approcci di event-streaming funzionano meglio quando la freschezza sub-secondo e l'ordinamento sono critici per il business, ma comportano costi operativi più elevati e una curva di apprendimento più ripida. Kafka garantisce l'ordinamento all'interno di una partizione, supporta la riproduzione da qualsiasi offset e scala a milioni di eventi al secondo. Il compromesso è che ora si gestisce un log distribuito, che richiede il proprio monitoraggio, politiche di conservazione e gestione dei gruppi di consumatori.
Intuizione chiave: Un servizio di ordinamento minimale più la riproduzione locale può garantire la convergenza senza complessa logica CRDT, ma richiede funzioni di transazione deterministiche e una semantica di riproduzione attenta. Il pacchetto di sincronizzazione dati di Adobe dimostra questo pattern in produzione: assegna un ordinamento canonico e supporta transitori locali ottimistici con riproduzione committata dal server, ottenendo uno stato multi-client convergente senza l'overhead di una piena implementazione CRDT.
Trasferimento basato su file
Per dati binari di massa, esportazioni di archivi o sistemi legacy che non espongono API, il trasferimento basato su file rimane pratico. AWS DataSync gestisce trasferimenti su larga scala con crittografia in transito e validazione dell'integrità end-to-end, rendendolo una scelta forte per il movimento di dati regolamentati tra storage on-premises e cloud. Per la sincronizzazione file peer-to-peer, rsync è lo strumento standard del mondo Unix, anche se i team dovrebbero monitorare attentamente i suoi rilasci di sicurezza.
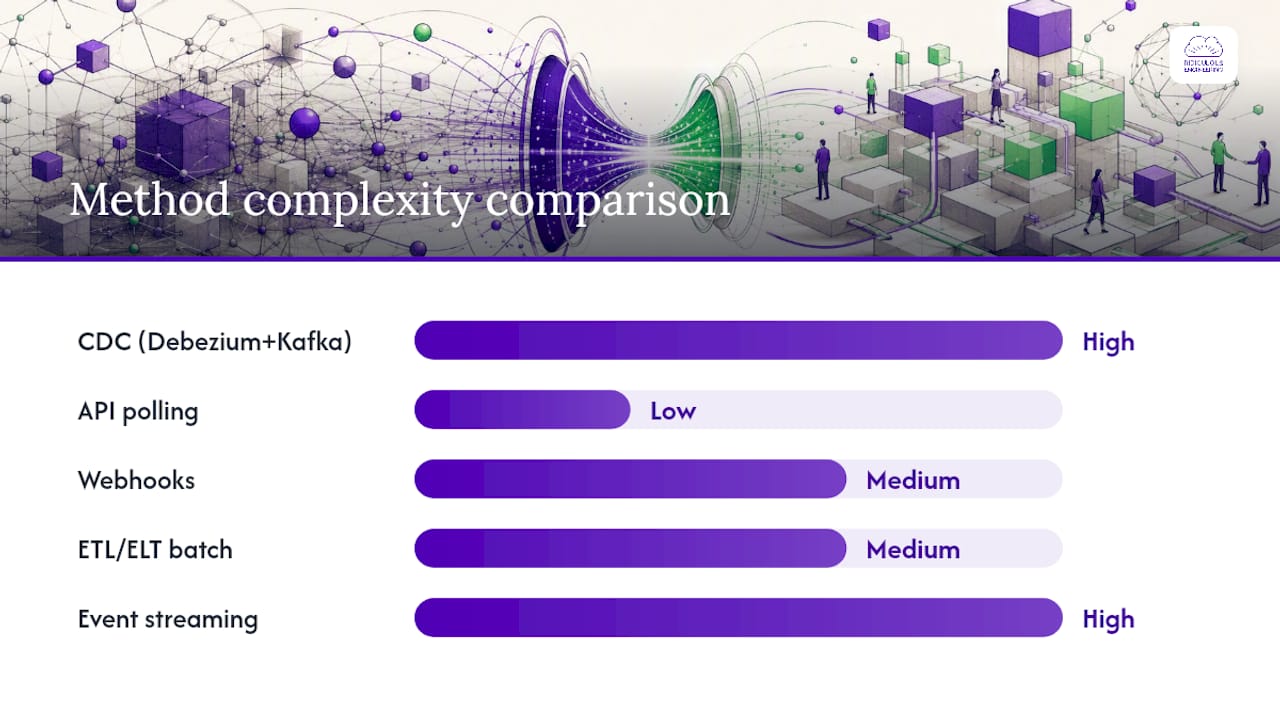
Confronto dei metodi
| Metodo | Latenza | Impatto sulla sorgente | Complessità | Modalità di errore comune |
|---|---|---|---|---|
| CDC (Debezium + Kafka) | Da sub-secondo a secondi | Basso (lettura log) | Alta | Lacune nella conservazione dei log, bypass del caricamento di massa |
| Polling API | Minuti | Medio (carico di query) | Bassa | Limiti di frequenza, eliminazioni mancate |
| Webhook | Secondi | Bassa | Media | Consegna duplicata, tempi di inattività dell'endpoint |
| Batch ETL/ELT | Da minuti a ore | Da medio ad alto | Medio | Deriva dello schema, errori dei job |
| Streaming di eventi | Sub-secondo | Basso | Alto | Ritardo del consumatore, skew delle partizioni |
| Trasferimento file | Ore | Basso | Basso | Errori di integrità, file obsoleti |
Su quale pattern architetturale dovresti costruire?
Il metodo scelto determina il flusso di dati; il pattern architetturale determina chi possiede cosa e come si propagano gli errori. Quattro pattern coprono la maggior parte delle implementazioni aziendali.
Punto-a-punto
Ogni sistema si connette direttamente a ogni altro sistema con cui deve condividere dati. Due sistemi: una connessione. Cinque sistemi: fino a dieci connessioni. La matematica diventa brutta in fretta, e ogni connessione è un'integrazione personalizzata che probabilmente è stata costruita da un team diverso. Il punto-a-punto è accettabile per due o tre sistemi strettamente accoppiati dove il team possiede entrambi i lati. Oltre a ciò, diventa una responsabilità di manutenzione.
Hub-and-spoke
Un hub centrale media tutti gli scambi di dati. Gli spoke si connettono solo all'hub, non tra loro. Azure SQL Data Sync è un esempio di produzione di questo pattern: un database hub si sincronizza con i database membri secondo una pianificazione configurata, con la risoluzione dei conflitti gestita nell'hub. L'hub diventa un punto unico di errore, quindi la configurazione ad alta disponibilità per l'hub non è opzionale.
Middleware e iPaaS
Una piattaforma di integrazione (MuleSoft, Boomi, Workato, IBM App Connect) si trova tra i sistemi e gestisce trasformazione, routing, gestione degli errori e logica di retry. Questo pattern si adatta ad ambienti fortemente SaaS dove non controlli gli schemi di origine o destinazione. Il fornitore della piattaforma gestisce i connettori; il tuo team gestisce i flussi e la governance. Il modello basato su ricette di Workato e la libreria di connettori di livello enterprise di IBM sono due opzioni consolidate in questo spazio.
Principio architetturale: La proprietà del record canonico deve essere dichiarata prima che il primo byte si muova. Se due team credono ciascuno che il proprio sistema sia la fonte di verità per lo stesso campo, nessun pattern architetturale risolve automaticamente quel conflitto.
Event-driven e streaming
Apache Kafka o un equivalente gestito (Confluent Cloud, Amazon MSK) agisce come log durevole. I produttori pubblicano eventi; i consumatori si sottoscrivono in modo indipendente. Questo pattern disaccoppia completamente i produttori dai consumatori, supporta la riproduzione e scala orizzontalmente. Il modello di server di ordinamento di Adobe mostra come una variante leggera di questo pattern raggiunga uno stato convergente per la sincronizzazione multi-utente in tempo reale senza una distribuzione Kafka completa. Il costo operativo è reale: hai bisogno di governance dello schema, monitoraggio dei gruppi di consumatori e politiche di conservazione dal primo giorno.
Per scenari peer-to-peer dove lo storage centrale è indesiderabile, Syncthing offre un modello decentralizzato e crittografato, anche se scambia il controllo centrale con la complessità nella risoluzione dei conflitti e nell'auditabilità.
Consiglio da esperti: Scegli hub-and-spoke quando hai bisogno di una traccia di audit semplice e un chiaro proprietario dei conflitti. Scegli event-driven quando hai bisogno di latenza sub-secondo su più di tre consumatori. Tutto il resto è di solito un buon adattamento per iPaaS.
Riepilogo dell'adattamento del pattern
| Pattern | Ideale per | Isolamento degli errori | Modello di proprietà |
|---|---|---|---|
| Punto-a-punto | 2–3 sistemi strettamente accoppiati | Scarso | Ogni team possiede la propria connessione |
| Hub-and-spoke | Governance centralizzata, carichi di lavoro SQL | L'hub è un punto singolo di guasto | Il team dell'hub possiede le regole di conflitto |
| Middleware / iPaaS | Sistemi eterogenei con forte presenza SaaS | Buono (la piattaforma gestisce i nuovi tentativi) | Team piattaforma + proprietari dei flussi |
| Event-driven / streaming | Alto throughput, sub-secondo, molti consumatori | Eccellente (indipendenza dei consumatori) | Team piattaforma + registro degli schemi |
Come si risolvono i conflitti e si governa il record aureo?
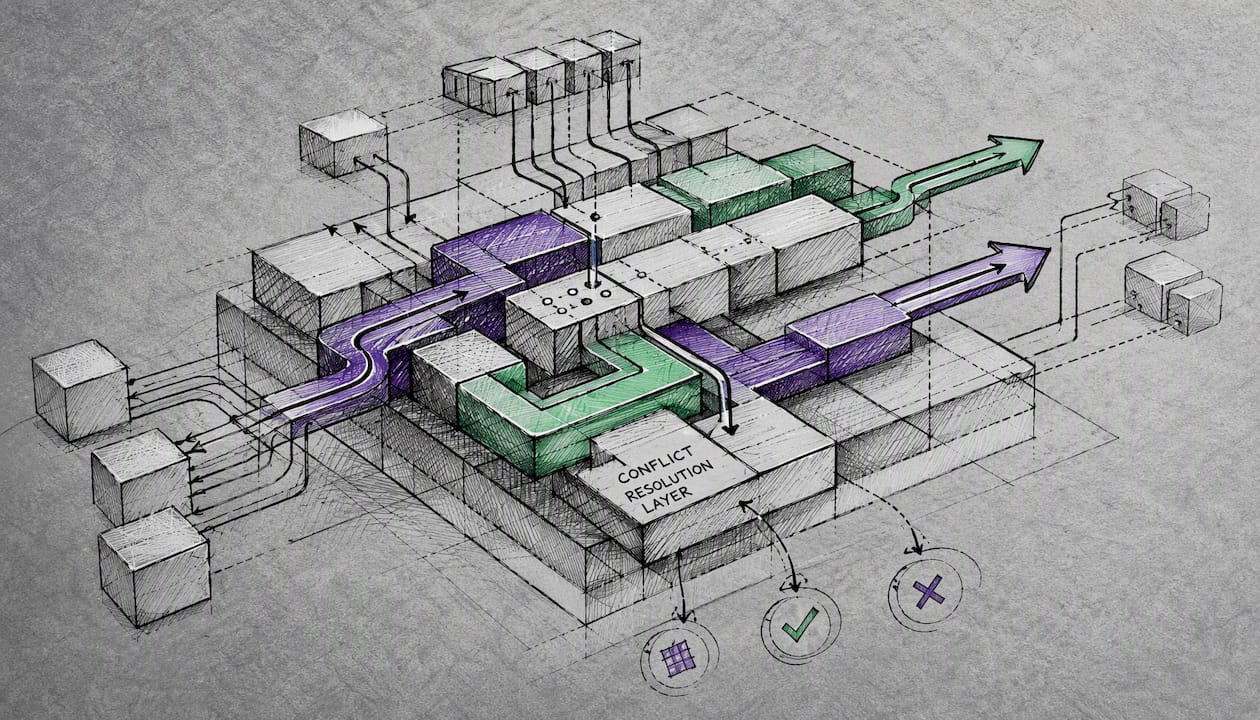
La risoluzione dei conflitti è il punto in cui i progetti di sincronizzazione falliscono più spesso in produzione. Due sistemi aggiornano lo stesso record prima del ciclo di sincronizzazione successivo, e la pipeline deve decidere quale versione vince. La decisione che prendi qui ha conseguenze a valle per ogni team che dipende da quei dati.
Politiche comuni di conflitto
Ultimo scrittore vince (LWW) applica un timestamp o un numero di sequenza e mantiene la modifica più recente. Semplice da implementare, ma scarta silenziosamente aggiornamenti legittimi quando gli orologi sono disallineati o quando una rete lenta consegna una modifica più vecchia dopo una più recente.
Hub vince / Membro vince sono le due politiche esposte da Azure SQL Data Sync. “Hub vince” significa che la versione del database dell'hub sovrascrive sempre le modifiche dei membri in caso di conflitto. “Membro vince” fa il contrario. Nessuna delle due è universalmente corretta; la scelta giusta dipende da quale sistema la tua azienda considera più affidabile per un determinato dominio di dati.
Sorgente di verità per dominio assegna la proprietà a livello di campo o entità. L'indirizzo di fatturazione del cliente è di proprietà dell'ERP; le preferenze di contatto del cliente sono di proprietà del CRM. I conflitti all'interno di un dominio vanno al proprietario designato; i conflitti tra domini non esistono per definizione. Questa è la politica più duratura e la più difficile da implementare senza un lavoro di governance preventivo.
L'approccio del record aureo
Un record aureo è la versione unica concordata di un'entità, assemblata dai campi più affidabili di tutti i sistemi contribuenti. Operativizzarlo richiede tre cose: un data steward che possiede la decisione di riconciliazione per ogni dominio, uno schema che segna esplicitamente quale sistema è autorevole per campo, e un'esecuzione di riconciliazione pianificata che confronta il record aureo con tutti i sistemi contribuenti e segnala le divergenze.
Matrice decisionale per la risoluzione dei conflitti
| Priorità aziendale | Politica consigliata | Rischio da gestire |
|---|---|---|
| Attualità sopra correttezza | Ultimo scrittore vince | Disallineamento orologi, consegna fuori ordine |
| Correttezza sopra attualità | Sorgente di verità per dominio | Latenza, mappatura tra domini |
| Throughput sopra entrambi | Hub vince (regola semplice) | Aggiornamenti legittimi dei membri sovrascritti |
| Auditabilità richiesta | Versionamento a livello di campo + registro di audit | Costo di archiviazione, complessità delle query |
Suggerimento Pro: Ricerca sulla gestione dei conflittidalla Harvard’s Program on Negotiation emerge costantemente che approcci collaborativi basati sugli interessi producono accordi più duraturi rispetto a regole rigide. Applica la stessa logica alla governance della sincronizzazione: quando due team disputano sulla proprietà di un campo dati, facilita una conversazione su ciò di cui ogni team ha effettivamente bisogno da quel campo piuttosto che imporre una regola tecnica. La politica risultante sopravviverà più a lungo e genererà meno escalation.
Quando i team trattano la risoluzione dei conflitti come un problema di negoziazione, producono una governance più duratura rispetto a fare affidamento solo sull'ultimo scrittore vince.
Checklist di governance
- Assegna un data steward nominato per dominio con autorità documentata per risolvere le dispute.
- Definisci SLA per la freschezza della sincronizzazione (es., sincronizzazione account CRM-ERP entro 5 minuti dalla modifica).
- Mantieni una traccia di audit di ogni decisione di risoluzione dei conflitti, non solo del valore vincente.
- Pianifica esecuzioni di riconciliazione almeno giornaliere; confronta conteggi di record e checksum dei campi chiave.
- Documenta un percorso di escalation per i conflitti che la politica automatizzata non può risolvere.
Checklist di implementazione: dalla progettazione al rollback
Un progetto di sincronizzazione che salta le fasi di progettazione lo paga in incidenti di produzione. La checklist seguente copre le fasi in cui i team tagliano più comunemente gli angoli.
Fase di progettazione
- Mappa ogni sistema sorgente e di destinazione, inclusi proprietario, versione dello schema e frequenza di aggiornamento.
- Esegui la mappatura a livello di campo: identifica discrepanze di tipo, differenze nullable e incoerenze di codifica prima di scrivere una riga di codice.
- Dichiara il sistema autorevole per ogni entità e campo sincronizzato.
- Progetta per l'idempotenza fin dall'inizio: ogni operazione di sincronizzazione dovrebbe produrre lo stesso risultato sia che venga eseguita una volta o dieci volte.
- Definisci la politica di risoluzione dei conflitti per dominio e documentala in un record decisionale condiviso.
Fase di ingegneria
- Implementa la gestione dell'evoluzione dello schema: usa un registro di schemi (Confluent Schema Registry, AWS Glue Schema Registry) così i consumatori non si rompono quando un produttore aggiunge un campo.
- Costruisci logica di retry con backoff esponenziale e una coda di lettere morte per i messaggi che falliscono ripetutamente.
- Gestisci esplicitamente la semantica transazionale: decidi se hai bisogno di consegna exactly-once, at-least-once o at-most-once e scegli il tuo trasporto di conseguenza.
- Testa i percorsi di caricamento bulk separatamente. Le operazioni bulk possono bypassare i trigger di tracciamento delle modifiche a meno che non configurati diversamente, creando drift silenzioso.
- Implementa la gestione del rate-limit per i connettori basati su API: fai backoff con grazia e esponi l'esaurimento della quota come errore nominato, non come fallimento silenzioso.
Schema del piano di test
- Test unitari: convalida la logica di trasformazione, la mappatura dei campi e le regole di risoluzione dei conflitti in isolamento.
- Test di integrazione: esegui contro un dataset simile alla produzione; verifica conteggi di record, checksum e latenza rispetto agli obiettivi SLA.
- Test di caos e fallimento: uccidi il message broker a metà batch, introduci partizioni di rete e verifica che la pipeline si riprenda senza perdita o duplicazione di dati.
- Prova di cutover: esegui la sequenza completa di cutover in un ambiente di staging almeno due volte prima della produzione.
Rollback e mitigazione
- Usa feature flag o toggle di abilitazione sincronizzazione così puoi disabilitare una pipeline senza un deploy di codice.
- Fai uno snapshot dei sistemi di destinazione immediatamente prima del cutover; conservalo per almeno un ciclo completo di riconciliazione.
- Progetta la capacità di replay nella pipeline così puoi riprocessare eventi da un offset noto-buono.
- Definisci uno SLA di rollback: quanto tempo può tollerare il business di girare su dati obsoleti mentre recuperi?
Suggerimento Pro: I team che si riprendono più velocemente dai fallimenti di sincronizzazione sono quelli che hanno praticato il rollback prima di averne bisogno. Pianifica un drill di caos in staging prima del tuo primo cutover di produzione.
Cosa dovresti monitorare e come individuare i problemi in anticipo?
Le sfide operative comuni nei progetti di sincronizzazione includono ritardi di latenza, deriva dello schema, record duplicati da nuovi tentativi, ritardo CDC, limiti di velocità API e dati obsoleti che gli utenti aziendali rilevano prima del team di ingegneria. Il monitoraggio che misura solo la salute del connettore perde la maggior parte di questi aspetti.
Metriche essenziali
- Ritardo di sincronizzazione: tempo tra una modifica nell'origine e il suo arrivo a destinazione. Avvisa quando il ritardo supera la soglia SLA.
- Tasso di successo/errore: percentuale di operazioni di sincronizzazione completate senza errori. Un calo improvviso è il primo segnale di un problema sistemico.
- Throughput: eventi o record al secondo. Cali inaspettati indicano rallentamenti a monte o ritardo del consumatore.
- Conteggio duplicati: record elaborati più di una volta. Un tasso di duplicati in aumento segnala mancanza di idempotenza o configurazione errata dei nuovi tentativi.
- Delta di riconciliazione: confronto periodico dei conteggi dei record e dei checksum dei campi chiave tra sistemi autorevoli. Questa è la metrica che cattura la deriva che le metriche a livello di connettore perdono.
- Avvisi di modifica dello schema: si attivano su qualsiasi modifica DDL a una tabella sincronizzata o allo schema di un argomento.
Soglie di avviso e escalation
Inizia con questi valori predefiniti sensati, poi ottimizza in base alla tua SLA:
- Il ritardo supera 2 volte l'obiettivo SLA per più di 3 minuti consecutivi: contatta l'ingegnere di turno.
- Tasso di errore superiore all'1% in una finestra di 5 minuti: nuovo tentativo automatico; escalada a un umano se non risolto dopo 15 minuti.
- Delta di riconciliazione superiore allo 0,1% del conteggio totale dei record: apri un incidente ed esegui un lavoro di riconciliazione mirato.
- Modifica dello schema rilevata su una tabella sincronizzata: metti in pausa la pipeline, notifica al team proprietario e richiedi una ripresa deliberata.
Strumenti di osservabilità
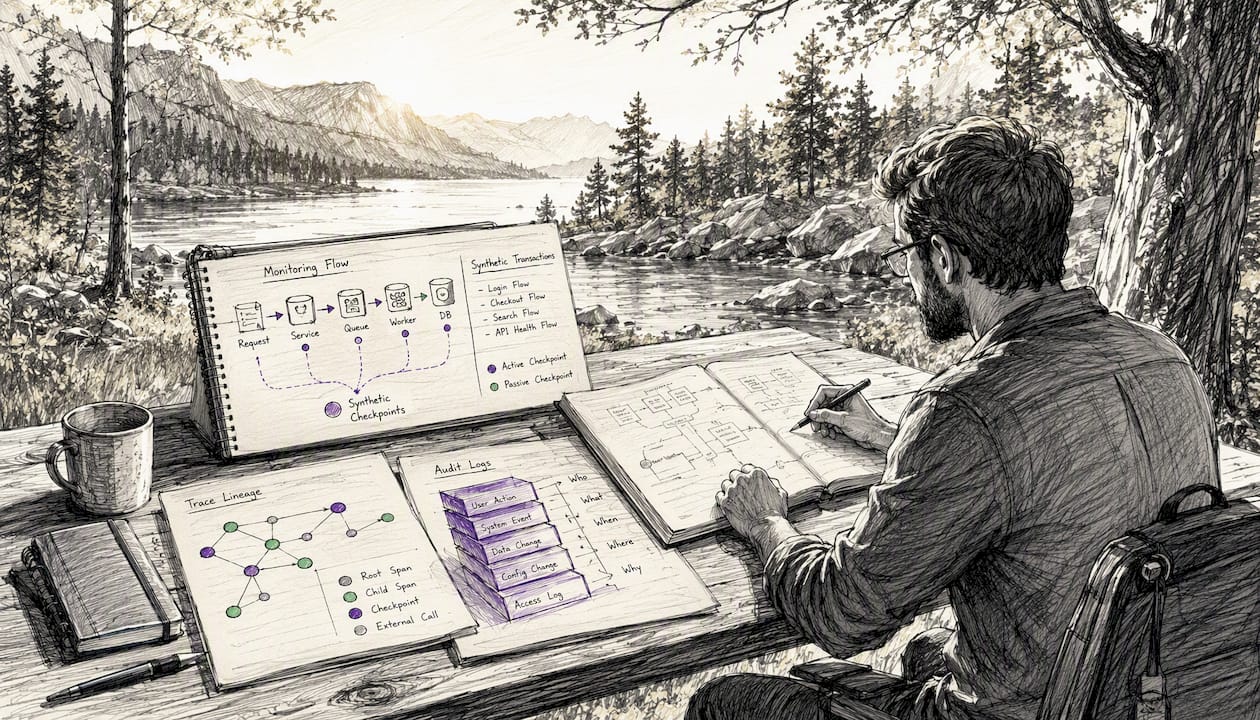
I controlli di salute a livello di connettore sono necessari ma non sufficienti. Aggiungi transazioni end-to-end sintetiche: inietta un record di test noto nell'origine secondo una pianificazione e verifica che arrivi a destinazione entro la finestra SLA. Aggiungi la tracciabilità della discendenza per poter tracciare qualsiasi record attraverso ogni trasformazione che ha subito. I log di controllo dovrebbero catturare non solo cosa è cambiato ma chi o quale sistema ha avviato il cambiamento.
Quali strumenti e piattaforme gestiscono la sincronizzazione dei dati?
La categoria di strumenti di cui hai bisogno dipende dai sistemi di origine e destinazione, dal requisito di latenza e dalla capacità operativa del tuo team. CDC e streaming di eventi sono gli approcci standard per la sincronizzazione quasi in tempo reale; le piattaforme iPaaS sono adatte all'integrazione SaaS-to-SaaS; gli strumenti file gestiscono trasferimenti bulk e binari.
Panoramica delle categorie di strumenti
iPaaS (Integration Platform as a Service): Workato, IBM App Connect, Skyvia e MuleSoft Anypoint Platform rientrano tutti qui. Queste piattaforme forniscono connettori predefiniti per centinaia di applicazioni SaaS, builder di flussi visivi e gestione di nuovi tentativi/errori. Il modello di ricette di Workato è adatto a team operativi che devono creare flussi senza un coinvolgimento ingegneristico profondo. IBM App Connect porta una governance di livello enterprise e una libreria di connettori che copre mainframe e sistemi legacy che la maggior parte dei vendor iPaaS ignora. Skyvia offre un'opzione più leggera, nativa del cloud, con un forte supporto per la sincronizzazione database-to-cloud a un prezzo inferiore.
CDC e replica del database: Debezium (open source, nativo Kafka) e Azure SQL Data Sync (gestito, hub-and-spoke) sono l'opzione primaria per la sincronizzazione database-to-database. Debezium ti dà il controllo completo e si integra nativamente con Apache Kafka. Azure SQL Data Sync scambia flessibilità per semplicità: configura un gruppo di sincronizzazione, imposta una pianificazione e il servizio gestisce il resto all'interno dell'ecosistema Azure.
Streaming di eventi: Apache Kafka (self-managed o tramite Confluent Cloud, Amazon MSK o Azure Event Hubs) è lo standard di produzione per la sincronizzazione sub-secondo ad alto throughput. La complessità operativa è alta; i servizi gestiti la riducono significativamente.
Trasferimento file e bulk: AWS DataSync gestisce il movimento di file su larga scala e sicuro tra on-premises e cloud con verifica dell'integrità. Rsync rimane lo standard per la sincronizzazione file Unix-to-Unix.
Dimensioni di valutazione
| Strumento / categoria | Ideale per | Direzionalità | Tempi | Distribuzione | Complessità operativa | Modello di costo |
|---|---|---|---|---|---|---|
| Workato | Automazione SaaS-to-SaaS | Unidirezionale, bidirezionale | Quasi in tempo reale | Cloud | Bassa (builder visuale) | Per ricetta / consumo |
| IBM App Connect | Enterprise, sistemi legacy | Unidirezionale, bidirezionale, multi | Quasi in tempo reale, batch | Cloud, on-prem, ibrido | Da media ad alta | Licenza + consumo |
| Skyvia | DB-to-cloud, sincronizzazione SaaS | Unidirezionale, bidirezionale | Quasi in tempo reale, batch | Cloud | Da bassa a media | Piani di abbonamento |
| Apache Kafka + Debezium | CDC DB, streaming ad alta produttività | Unidirezionale, multi | Da sub-secondo a secondi | Cloud, on-prem, ibrido | Alta | Infrastruttura + operazioni |
| Azure SQL Data Sync | Sincronizzazione SQL Server / Azure SQL | Bidirezionale (hub-spoke) | Quasi in tempo reale, batch | Cloud, ibrido | Da bassa a media | Consumo di Azure |
| AWS DataSync | Migrazione di file/storage in blocco | Unidirezionale | Batch, pianificato | Cloud, ibrido | Basso | Per GB trasferito |
Consiglio da esperti: Per ambienti piccoli (meno di 5 sistemi, prevalentemente SaaS), inizia con un iPaaS come Workato o Skyvia. Per ambienti medi con un mix di database e SaaS, aggiungi Debezium e Kafka per il livello database. Per requisiti su larga scala, sub-secondo, con molti consumatori, un servizio Kafka completamente gestito con un registro degli schemi è l'unica architettura che regge sotto carico.
Quando la complessità dell'integrazione supera ciò che il tuo team può gestire internamente, la decisione di coinvolgere un integratore si ripaga rapidamente. Il lavoro di Ridiculousengineering su integrazione di sistemi e ingegneria di sincronizzazione personalizzata copre l'intero stack, dall'architettura al supporto di produzione.
Considerazioni su sicurezza, privacy e conformità
La sicurezza è dove i progetti di sincronizzazione creano più spesso esposizioni involontarie. I dati che si spostano tra sistemi attraversano confini di rete, passano attraverso connettori con credenziali memorizzate e finiscono in destinazioni che potrebbero avere controlli di accesso più deboli rispetto all'origine.
Controlli fondamentali
- Crittografia in transito: TLS 1.2 o superiore su ogni connettore, ogni hop. Nessuna eccezione per segmenti di rete interni.
- Autenticazione e autorizzazione: usa account di servizio con accesso con privilegi minimi. Un connettore di sincronizzazione che legge dati dei clienti non dovrebbe avere accesso in scrittura a tabelle finanziarie.
- Gestione di chiavi e segreti: memorizza le credenziali dei connettori in un gestore di segreti (AWS Secrets Manager, HashiCorp Vault, Azure Key Vault), non in file di configurazione o variabili d'ambiente versionate nel controllo del codice sorgente.
- Rotazione dei segreti: ruota le credenziali dei connettori secondo un programma definito e dopo qualsiasi cambio di personale che vi abbia avuto accesso.
Minimizzazione dei dati e dati regolamentati
Sincronizza solo i campi di cui hai bisogno. Sincronizzare un record completo del cliente quando il sistema di destinazione necessita solo di nome ed email raddoppia la tua superficie di esposizione senza valore aziendale. Per dati regolamentati, la superficie di esposizione è anche una superficie di conformità.
I dati sanitari statunitensi sono soggetti agli obblighi HIPAA: qualsiasi progetto di sincronizzazione che tocchi informazioni sanitarie protette (PHI) deve includere crittografia, controlli di accesso e trail di audit per supportare la conformità. Questo si applica alla pipeline stessa, non solo agli endpoint. Un topic Kafka che trasporta PHI è un archivio PHI e deve essere trattato di conseguenza.
Per dati regolamentati non sanitari, PCI DSS regola i dati delle carte di pagamento e CCPA impone obblighi sui diritti dei soggetti dei dati per i consumatori californiani. Entrambi hanno implicazioni su quanto a lungo vengono conservati i dati sincronizzati e chi può accedervi.
Checklist di sicurezza
| Controllo | Si applica a | Nota di implementazione |
|---|---|---|
| TLS in transito | Tutti i connettori | Applica TLS minimo 1.2; disabilita suite di crittografia legacy |
| Account di servizio con privilegi minimi | Tutti i connettori | Separa account di lettura e scrittura per pipeline |
| Integrazione gestore segreti | Tutto lo stoccaggio delle credenziali | Non conservare mai le credenziali nel codice o nei file di configurazione |
| Mascheramento a livello di campo | Dati regolamentati (PHI, PCI) | Mascherare nel connettore prima di scrivere su destinazioni non regolamentate |
| Registrazione di controllo (audit logging) | Tutte le pipeline | Registrare origine, destinazione, timestamp, ID record e tipo di operazione |
| Pianificazione rotazione segreti | Tutte le credenziali | Minimo annuale; trimestrale per pipeline ad alta sensibilità |
| Politica di conservazione dei dati | Tutti gli archivi sincronizzati | Allineare la conservazione alla normativa più restrittiva applicabile |
Migrazione vs. sincronizzazione vs. replica: quale strategia si adatta?
Questi tre termini sono spesso usati in modo intercambiabile, ma descrivono strategie fondamentalmente diverse con impegni operativi differenti.
Migrazione è un'operazione una tantum e limitata: spostare dati dal sistema A al sistema B, validarli e dismettere A. L'obiettivo è un cutover pulito. Strumenti come AWS DataSync e utility di export/import native del database gestiscono bene questa situazione. La migrazione è la scelta giusta quando si ritira un sistema, non lo si integra.
Replica copia i dati continuamente da un primario a una o più repliche, tipicamente per scalabilità di lettura o disaster recovery. La replica non è un partecipante indipendente; è una copia. Lo streaming replication di PostgreSQL e la replica binlog di MySQL sono i meccanismi standard. La replica è la scelta giusta quando l'obiettivo è la disponibilità o il throughput di lettura, non la condivisione di dati tra sistemi.
Sincronizzazione mantiene due o più sistemi indipendenti coerenti nel tempo. Ogni sistema può originare modifiche. La sincronizzazione è la scelta giusta quando più applicazioni devono leggere e scrivere lo stesso dominio logico di dati e nessuna di esse può essere resa subordinata alle altre.
Flusso decisionale
- Cutover a breve termine con dismissione del sistema: scegliere la migrazione.
- Scalabilità di lettura o disaster recovery all'interno di un singolo stack applicativo: scegliere la replica.
- Coerenza a lungo termine tra sistemi indipendenti: scegliere la sincronizzazione.
- Disaster recovery più integrazione tra sistemi: combinare la replica per HA con la sincronizzazione per l'integrazione dei workload.
- Migrazione a una nuova piattaforma mantenendo la vecchia attiva durante la transizione: migrare prima, poi eseguire la sincronizzazione in parallelo fino alla data di cutover, quindi dismettere.
Il gap di condivisione dei dati tra sistemi è quasi sempre un problema di governance prima che tecnologico. Scegliere la strategia giusta in anticipo previene mesi di rilavorazione.
Come Ridiculous Engineering affronta programmi di sincronizzazione complessi
I team che hanno mappato le loro origini, scelto un'architettura e scritto una politica di conflitto affrontano ancora un problema difficile: costruire e gestire una pipeline di sincronizzazione in produzione è lavoro di ingegneria, non di configurazione. La differenza tra una pipeline che regge sotto carico e una che deriva silenziosamente si manifesta nei dettagli: progettazione dell'idempotenza, gestione dell'evoluzione dello schema, test di caos e monitoraggio che cattura la deriva prima che lo facciano gli utenti aziendali.
I servizi di integrazione personalizzata e ingegneria della sincronizzazione di Ridiculous Engineering coprono l'intero ciclo di vita della consegna: progettazione dell'architettura, implementazione della pipeline CDC, infrastruttura di streaming di eventi, configurazione del programma di governance, pianificazione dei test e monitoraggio della produzione. Lavoriamo con gli strumenti che il tuo team usa già o ti aiutiamo a scegliere quelli giusti per la tua scala e i tuoi vincoli.
I risultati pratici che i clienti possono aspettarsi includono riduzione della deriva dei dati, garanzie di freschezza basate su SLA, procedure di rollback riproducibili e trail di audit che soddisfano la revisione normativa. Aiutiamo anche i team a costruire le strutture di governance e gli accordi tra team che mantengono le pipeline sane dopo la consegna iniziale.
Se il tuo team sta pianificando un programma di sincronizzazione o ne sta ereditando uno che mostra già segni di deriva, contattaci per avviare una conversazione. Ti aiuteremo a capire cosa ti serve realmente prima di consigliare come costruirlo.
Fonti
Le fonti seguenti meritano di essere salvate nei preferiti per letture tecniche e normative più approfondite:
- sql-data-sync-data-sql-server-sql-database?view=azuresql
- Stili di gestione dei conflitti: insidie e migliori pratiche - PON - Programma di negoziazione presso la Harvard Law School
- Gli strumenti di sincronizzazione dei dati mantengono le informazioni coerenti tra più sistemi, database e ambienti cloud automaticamente
- adobe/data sync (GitHub)
- AWS DataSync
- Health Insurance Portability and Accountability Act (HIPAA) - CDC
FAQ
Cosa succede se disattivo la sincronizzazione?
La disattivazione di una pipeline di sincronizzazione interrompe la propagazione delle modifiche tra i sistemi, quindi ciascun sistema continua ad accumulare aggiornamenti in modo indipendente. Quando riattivi la sincronizzazione, la pipeline deve riconciliare la divergenza e, a seconda della politica sui conflitti, alcuni aggiornamenti potrebbero essere sovrascritti.
Perché i miei dati non si sincronizzano tra i sistemi?
Le cause più comuni sono la scadenza delle credenziali del connettore, l'esaurimento dei limiti di frequenza API, modifiche allo schema che interrompono la pipeline e operazioni di caricamento bulk che bypassano i trigger di rilevamento delle modifiche. Controlla prima i log del connettore e i delta di riconciliazione.
La sincronizzazione dovrebbe essere attiva o disattiva per impostazione predefinita?
Attiva, per qualsiasi integrazione in cui le operazioni aziendali dipendono da dati coerenti tra i sistemi. Disattiva è appropriata solo durante la manutenzione pianificata, un evento di rollback o una pausa deliberata mentre viene applicata una migrazione dello schema.
Come posso interrompere una pipeline di sincronizzazione in modo sicuro?
Usa un flag di funzionalità o un interruttore di abilitazione sincronizzazione per mettere in pausa la pipeline senza un deploy di codice, acquisisci uno snapshot dello stato attuale del sistema di destinazione e documenta l'offset o il checkpoint in modo da poter riprendere da una posizione nota senza rielaborare o perdere eventi.
Qual è la differenza tra CDC e ETL per la sincronizzazione?
Il CDC legge il log delle transazioni del database in modo continuo e cattura ogni modifica con un basso impatto sulla sorgente, rendendolo adatto alla sincronizzazione quasi in tempo reale. L'ETL interroga la sorgente secondo una pianificazione, che è più semplice da gestire ma produce finestre obsolete e aggiunge carico di query al sistema sorgente durante ogni esecuzione.
Consigliato
- Crescita trasformativa con il cloud computing | Ridiculous Engineering | Ridiculous Engineering
- Colmare il divario di condivisione dati: un percorso verso il successo della missione | Ridiculous Engineering
- Sfruttare le forze macro tecnologiche: come Ridiculous Engineering guida il successo aziendale | Ridiculous Engineering