Gobernanza de costes en la nube para líderes de tecnología y finanzas
Gobernanza de costes en la nube para líderes de tecnología y finanzas La gobernanza de costes en la nube es la práctica de alinear el gasto en la nube con el valor empresarial mediante roles, políticas y controles definidos —y el siguiente paso inmediato para la mayoría de las organizaciones es realizar un análisis de visibilidad de 7 días que...
Gobernanza de costes en la nube para líderes de tecnología y finanzas
La gobernanza de costes en la nube es la práctica de alinear el gasto en la nube con el valor empresarial mediante roles, políticas y controles definidos —y el siguiente paso inmediato para la mayoría de las organizaciones es realizar un análisis de visibilidad de 7 días que vincule cada línea de factura de la nube con un producto, equipo o centro de costes.
TL;DR — lo que encontrarás en esta guía:
-
Una definición clara que separa la gobernanza de la optimización de costes y FinOps
-
Los seis pilares de la gobernanza y el artefacto mínimo que requiere cada uno
-
Cómo funcionan los principales modelos de precios de la nube y qué palancas realmente marcan la diferencia
-
Un marco de roles y políticas con un espectro de cumplimiento
-
Controles operativos diarios y semanales para evitar la desviación del gasto
-
Un árbol de decisión para seleccionar herramientas (nativas de la nube frente a plataformas CCM)
-
Indicadores clave de rendimiento para equipos de ingeniería y para las audiencias de dirección financiera y FP&A
-
Las trampas culturales que acaban con los programas de gobernanza antes de que puedan escalar
-
Un despliegue de 90 días, semana a semana, con rangos estimados de esfuerzo y costes
Índice
-
Qué es realmente la gobernanza de costes en la nube (y qué no es)
-
Cómo funcionan los modelos de precios de la nube y qué palancas marcan la diferencia
-
Cómo crear el marco de gobernanza: roles, políticas y cumplimiento
-
Controles operativos diarios y semanales que evitan la desviación del gasto
-
¿Qué herramientas deberías usar para la gestión de costes en la nube?
-
Qué métricas presentar a los equipos de ingeniería frente a los ejecutivos
-
Dónde fallan los programas de gobernanza y cómo FinOps corrige la cultura
-
El despliegue en 90 días: hitos semanales y rangos de esfuerzo
Qué es realmente la gobernanza de costes en la nube (y qué no es)
La gobernanza de costes en la nube es la capa organizativa que se sitúa por encima de la optimización de costes. Define quién es responsable del gasto en la nube, qué políticas lo limitan y cómo se aplican esas políticas de forma continua. La optimización es una acción puntual de ahorro —ajustar el tamaño de una máquina virtual o eliminar un bucket huérfano—. La gestión es la capa de informes y asignación —paneles, facturas e informes de showback—. La gobernanza es la estructura que hace que ambas actividades sean repetibles y tengan responsables.
El Marco de FinOpsdefine bien esto: FinOps es un marco operativo que maximiza el valor empresarial del gasto en la nube mediante la colaboración entre los equipos de ingeniería, finanzas y negocio, con el principio de que el valor empresarial impulsa las decisiones tecnológicas. La gobernanza es el mecanismo que hace operativo ese principio.
Para las organizaciones estadounidenses, el alcance práctico de la gobernanza abarca tres resultados sujetos a control: cumplimiento del presupuesto (el gasto no supera los límites aprobados sin una decisión deliberada), visibilidad de costes a nivel de producto (cada dólar se asigna a un elemento empresarial) y normas de aprovisionamiento (las compras de compromisos siguen un flujo de aprobación). La gobernanza no debe convertirse en una función de vigilancia de ingeniería. En el momento en que los ingenieros perciben la gobernanza como un obstáculo en lugar de un facilitador, el programa pierde la responsabilidad distribuida de la que depende.
Consejo profesional: Elige un alcance de FinOps — un único producto, entorno o centro de costes — para tu piloto inicial. Intentar gobernar todo el gasto en la nube desde el primer día es la forma de que los programas se estanquen. Un piloto centrado genera pruebas que consiguen el apoyo de la organización para una implementación más amplia.
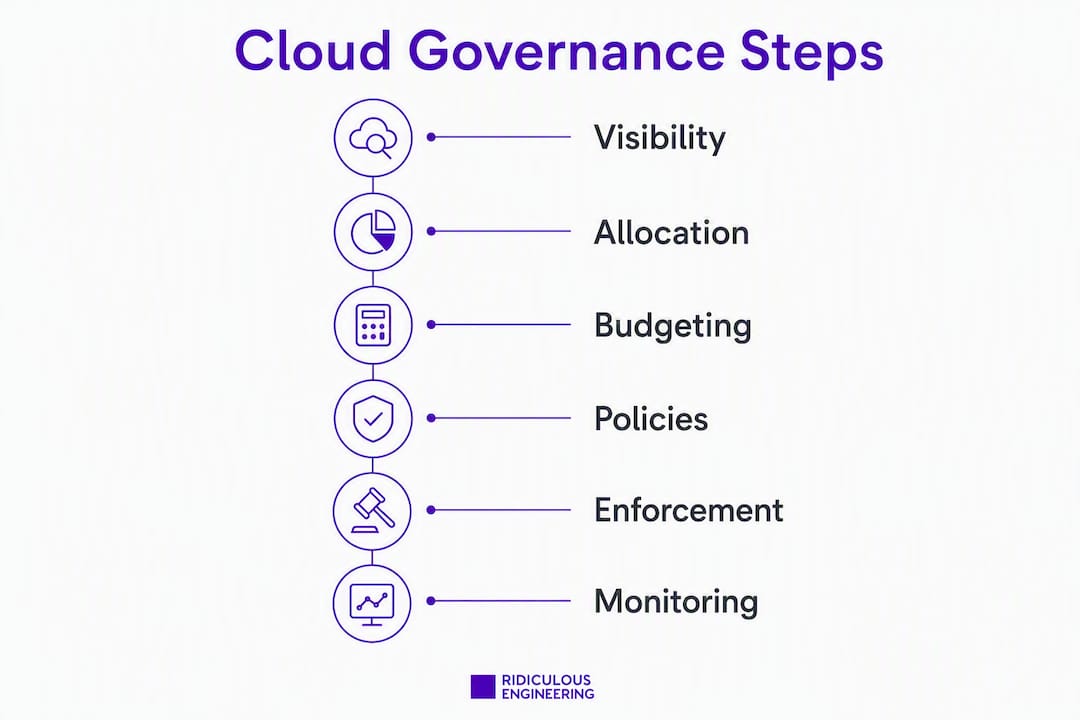
Los seis pilares que necesita todo programa de gobernanza
Los programas de gobernanza que perduran se construyen sobre seis pilares. Cada uno tiene un artefacto mínimo — el elemento que demuestra que el pilar funciona realmente, no que solo está documentado.
| Pilar | Responsable | Frecuencia | Resultado mínimo |
|---|---|---|---|
| Visibilidad y etiquetado | Ingeniería de plataformas | Diaria | Panel de gasto etiquetado con menos del 5 % sin etiquetar |
| Asignación / repercusión de costes | FinOps / Finanzas | Mensual | Informe de showback por producto y centro de costes |
| Presupuestación y previsiones | FP&A + FinOps | Mensual / trimestral | Objetos presupuestarios con alertas de desviación |
| Políticas y cumplimiento | Responsables de FinOps + Ingeniería | Revisión trimestral | Documento de política escrito + registro de cumplimiento |
| Optimización y revisiones de arquitectura | Ingeniería / arquitectos | Mensual | Informe de dimensionamiento adecuado y desperdicio |
| Aprovisionamiento y descuentos | Aprovisionamiento + FinOps | Trimestral | Registro de compras de compromisos y tasa de utilización |
La visibilidad y el etiquetado son la base. Sin ellos, todos los demás pilares se basan en conjeturas. La guía de buenas prácticas de FinOps de GSA/ITVMO recomienda utilizar jerarquías de recursos organizativas — AWS Organizations, Azure Management Groups y carpetas de GCP — como límite estricto de costes, reservando las etiquetas para informes basados en metadatos. Las etiquetas fallan. Las jerarquías no.
La asignación y la repercusión de costes convierten los datos brutos de facturación en lenguaje empresarial. Un informe de showback indica a un equipo de producto cuánto ha gastado; un informe de chargeback imputa ese coste a su presupuesto. Empieza con showback: genera confianza antes de pedir a los equipos que asuman la responsabilidad de una cifra.
La elaboración de presupuestos y las previsiones cierran el ciclo entre finanzas e ingeniería. Los objetos presupuestarios en la consola de facturación de tu proveedor de nube, combinados con alertas de desviación al 80 % y al 100 % del presupuesto, proporcionan a FP&A la señal que necesita sin requerir una conciliación manual mensual. Conectar esto con prácticas ágiles de modelización financiera hace que las previsiones respondan mejor a los patrones de uso reales.
Consejo profesional: Si tu organización se encuentra en una fase inicial de madurez en la nube, prioriza primero la visibilidad y la asignación. La optimización de las compras (instancias reservadas y planes de ahorro) ofrece los mayores ahorros en términos absolutos, pero solo después de comprender suficientemente bien tus patrones de uso de referencia como para comprometerte con confianza.
Cómo funcionan los modelos de precios de la nube y qué palancas tienen un impacto real
Una encuesta del sector reveló que el 66 % de los ejecutivos afirmó que la migración a la nube no redujo el coste total de propiedad; un tercio citó la imprevisibilidad de los costes y el 31 % señaló la complejidad de los precios como principales obstáculos. El modelo de facturación variable es realmente difícil de gestionar sin un marco de trabajo. Comprender las estructuras de precios es el requisito previo.
| Modelo de precios | Palanca de coste habitual | Compensación empresarial |
|---|---|---|
| Pago por uso (bajo demanda) | Dimensionamiento adecuado, políticas de escalado automático | Flexibilidad total; coste unitario más alto |
| Instancias reservadas / planes de ahorro | Compromisos de 1 o 3 años | Ahorro del 30 % frente a bajo demanda; requiere confianza en el uso |
| Instancias spot / preemptibles | Cargas de trabajo por lotes tolerantes a fallos | Coste más bajo; riesgo de interrupción |
| Salida de datos | Colocación conjunta en regiones, descarga a CDN | Ahorros significativos; requiere cambios arquitectónicos |
| Servicios gestionados | Selección del nivel adecuado, políticas de ciclo de vida | Prima por comodidad; a menudo sobredimensionados |
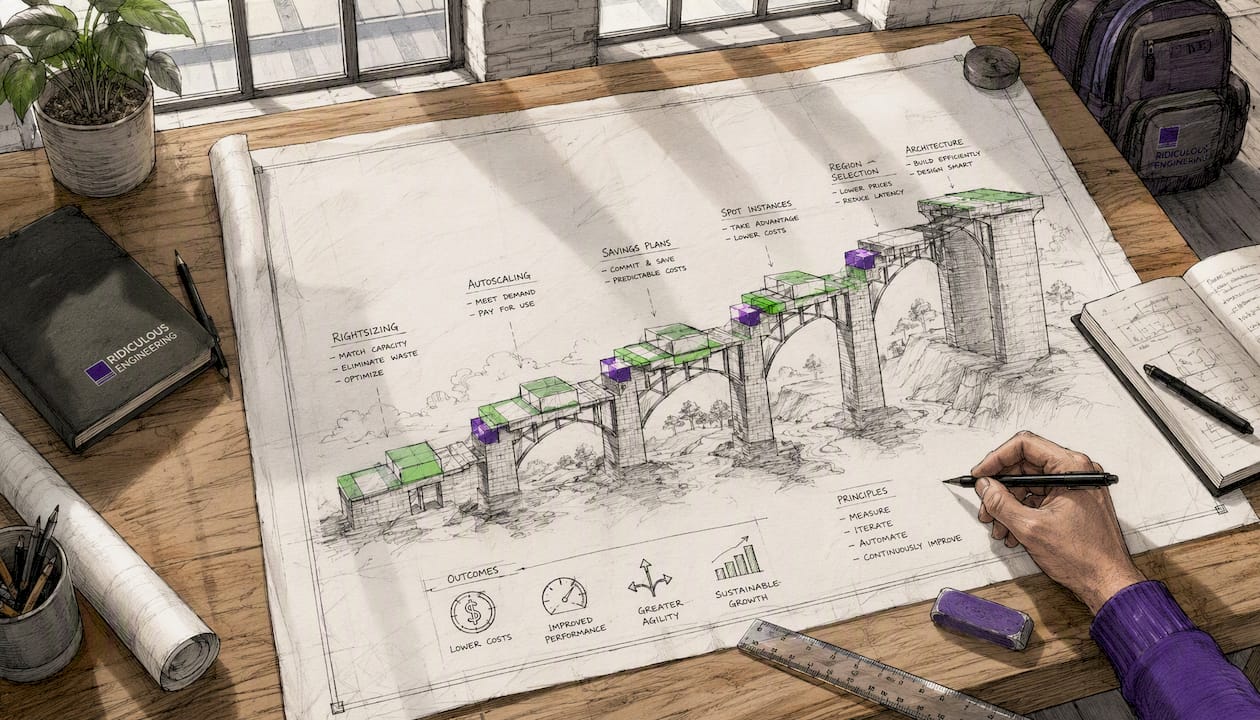
Las palancas más fiables, en orden de esfuerzo en relación con los ahorros, son: dimensionamiento adecuado y escalado automático (poco esfuerzo, resultados inmediatos), compras de instancias reservadas y planes de ahorro (esfuerzo medio, grandes ahorros), cargas de trabajo spot para trabajos por lotes y tareas de CI/CD (esfuerzo medio, grandes ahorros para las cargas adecuadas) y optimización de la salida de datos (mayor esfuerzo, pero los costes de salida suelen ser la partida oculta que sorprende a los equipos).
La selección de la región importa más de lo que la mayoría de los equipos cree. Ejecutar las cargas de trabajo en una región con precios de computación más bajos —manteniendo dentro del alcance los requisitos de residencia de datos— puede reducir los costes unitarios sin ningún cambio arquitectónico. En concreto, para las cargas de trabajo de IA y GPU, merece la pena modelar explícitamente esta compensación, como se explica en el contexto de equilibrar el coste y la velocidad en las cargas de trabajo de IA.
Consejo profesional: Centraliza la compra de compromisos (instancias reservadas, planes de ahorro y descuentos por uso comprometido) en una única función de FinOps o compras. La compra descentralizada de compromisos provoca adquisiciones solapadas y una infrautilización. Deja que los equipos de producto sean responsables de las decisiones sobre el gasto bajo demanda; deja que el equipo central se encargue de optimizar las tarifas.
Crear el marco de gobierno: funciones, políticas y aplicación
Un marco de gobierno sin responsables designados es un documento, no un programa. La tabla siguiente relaciona las cinco funciones principales con sus responsabilidades primarias.
| Función | Responsabilidad principal |
|---|---|
| FinOps central / Finanzas de la nube | Optimización de tarifas, compra de compromisos, redacción de políticas e informes |
| Responsables de ingeniería / producto | Decisiones diarias sobre el gasto, cumplimiento del etiquetado y respuesta a anomalías |
| Adquisiciones | Contratos con proveedores, flujos de trabajo de aprobación de compromisos |
| Ingeniería de plataformas | IaC como código de políticas, jerarquía de cuentas, herramientas |
| FP&A | Objetos presupuestarios, análisis de variaciones, integración de previsiones |
Los principios de FinOps son explícitos en esta estructura: una función central de FinOps permite aplicar las mejores prácticas, mientras que los ingenieros son responsables de las decisiones diarias sobre costes. Centralizarlo todo crea un cuello de botella; descentralizarlo todo genera caos. La división se establece entre la optimización de tarifas (centralizada) y las decisiones de uso (distribuidas).
Tipos de políticas que su programa necesita desde el primer día:
-
Política de etiquetado — etiquetas obligatorias (producto, entorno, equipo, centro de costes) con aplicación mediante linting de IaC o motores de políticas en la nube
-
Política de jerarquía de cuentas — qué cuentas o suscripciones se asignan a qué estructuras empresariales
-
Gestión de presupuestos e incumplimientos presupuestarios — quién recibe una notificación al 80 % y quién aprueba el exceso al 100 %
-
Controles de costes de CI/CD — estimación de costes en las solicitudes de incorporación de cambios para modificaciones de infraestructura
-
Reglas de adquisiciones — flujo de trabajo de aprobación para cualquier compra de compromisos que supere un umbral definido
-
Flujos de trabajo de aprobación — quién puede aprovisionar recursos de nivel de producción sin una solicitud de cambio
Espectro de aplicación: Las alertas son la opción predeterminada en producción. Las aprobaciones se aplican al aprovisionamiento de nuevos recursos por encima de un umbral de costes. Los controles flexibles (límites presupuestarios que envían notificaciones, pero no terminan recursos) se aplican a desarrollo y pruebas. Las detenciones estrictas — terminación automatizada — solo son adecuadas para recursos que no sean de producción y que superen un umbral de inactividad definido, y únicamente después de incorporar la confirmación humana al flujo de trabajo. La Usage.ai orientación sobre gobernanza es clara: las alertas que requieren confirmación antes de cualquier acción automatizada en servicios críticos evitan las interrupciones del negocio que las detenciones estrictas suelen provocar.
Consejo profesional: Escriba su primera política de etiquetado como una solicitud de incorporación de cambios en su repositorio de IaC, no como una página wiki. Una política que vive en el código se revisa, versiona y aplica. Una política que vive en una wiki se ignora.
Controles operativos diarios y semanales que evitan la desviación del gasto
La política de gobernanza es el plano. Los controles operativos son los que realmente mantienen los costes bajo control semana a semana. Los controles siguientes constituyen el ritmo mínimo viable para un equipo que ha completado la fase piloto.
Controles diarios:
-
Alertas automatizadas de anomalías configuradas para activarse cuando el gasto supere un umbral definido por encima de la media móvil de 7 días, y dirigidas a Slack o a un canal de webhook
-
Revisión de recursos huérfanos — identificación automatizada de volúmenes no asociados, equilibradores de carga sin uso y direcciones IP reservadas inactivas
-
Informe de cumplimiento de etiquetas — porcentaje del gasto cubierto por etiquetas obligatorias, con variación diaria
Controles semanales:
-
Revisión del dimensionamiento adecuado: extraiga las recomendaciones de dimensionamiento del proveedor de nube y priorícelas con el equipo de ingeniería correspondiente
-
Revisión de la utilización de instancias reservadas: confirme que la utilización de los compromisos se mantiene por encima del umbral objetivo (normalmente, más del 80 %)
-
Auditoría del ciclo de vida del almacenamiento: identifique buckets o blobs sin una política de ciclo de vida aplicada
-
Comprobación de costes de la canalización de CI/CD: revise las estimaciones de costes de infraestructura de los despliegues de la semana anterior
Manual de respuesta ante anomalías:
-
Se activa una alerta en el canal de Slack o webhook
-
El ingeniero de guardia confirma la recepción dentro de un SLA definido (por ejemplo, 2 horas durante el horario laboral)
-
Triaje: identifique el recurso, el equipo y la causa raíz
-
Mitigación: reduzca la escala, termine el recurso o escale el caso al propietario del recurso
-
Análisis posterior al incidente: documente la causa raíz y actualice la política o el IaC para evitar que vuelva a ocurrir
La orientación operativa de los profesionales lo expresa bien: la detección automatizada de anomalías reduce de meses a horas el tiempo medio de resolución cuando se integra como una señal activa en los flujos de trabajo de CI/CD y operativos, en lugar de aparecer en un informe mensual de facturación.
Consejo profesional: Los límites flexibles con confirmación humana superan a las detenciones estrictas en los sistemas de producción. Automatice las acciones seguras — terminar instancias de desarrollo inactivas, archivar almacenamiento en frío — y exija la aprobación humana para cualquier acción que pueda afectar a un servicio orientado al cliente.
¿Qué herramientas deberías utilizar para gestionar los costes de la nube?
La respuesta sobre las herramientas adecuadas depende de tu presencia en la nube, el volumen de gasto y la capacidad interna de ingeniería. La decisión no es qué proveedor elegir — sino qué nivel de capacidad necesitas realmente.
| Capacidad | Herramientas de facturación nativas de la nube | Automatización de plataformas (IaC/políticas como código) | Plataformas de CCM |
|---|---|---|---|
| Visibilidad del gasto | Básica (una sola nube) | Ninguna | Multinube, unificada |
| Detección de anomalías | Limitada | Ninguna | Avanzada, basada en ML |
| Planificación de reservas | Específica del proveedor | Ninguna | Optimización entre nubes |
| Aplicación del etiquetado | Manual o mediante un motor de políticas | Sólida (OPA, Sentinel) | Solo informes |
| Showback / chargeback | Básico | Ninguno | Completo |
| Acciones de automatización | Limitadas | Sólidas | Varía según la plataforma |
Las herramientas nativas de la nube — AWS Cost Explorer, Azure Cost Management y GCP Billing — son el punto de partida adecuado para organizaciones que utilizan una sola nube y tienen una facturación sencilla. Son gratuitas, precisas y suficientes para la fase piloto. La limitación es que no agregan datos entre nubes y su detección de anomalías es básica.
La automatización de plataformas mediante motores de políticas de Infraestructura como Código (Open Policy Agent, HashiCorp Sentinel y AWS Service Control Policies) gestiona la aplicación del etiquetado y las salvaguardas del aprovisionamiento. Aquí es donde reside la gobernanza impulsada por ingeniería. Requiere disciplina con la IaC, pero produce políticas duraderas y controladas mediante versiones.
Las plataformas de gestión de costes de la nube (CCM) añaden agregación multinube, detección de anomalías basada en ML, recomendaciones para optimizar reservas y automatización del showback/chargeback. Tienen sentido cuando operas en dos o más nubes, cuando tu gasto mensual en la nube justifica el coste de la suscripción o cuando tu equipo interno no tiene capacidad para crear informes personalizados. El marco de decisión entre crear o comprar se aplica directamente aquí: si la capacidad no es un factor diferenciador y una plataforma la ofrece de forma fiable, cómprala.
Consejo profesional: Instrumenta la detección de anomalías como tu primera inversión en automatización, antes que los paneles y antes que el chargeback. Una alerta de Slack que se active pocos minutos después de un aumento repentino de costes vale más que un bonito informe mensual. Conéctala a un webhook, exige una confirmación y tendrás un ciclo de retroalimentación rápido que cambia el comportamiento de los ingenieros en cuestión de semanas.
Qué métricas presentar a ingeniería frente a la dirección
El error que comete la mayoría de los equipos es crear un único panel y presentárselo a todo el mundo. Ingeniería necesita señales detalladas y casi en tiempo real. Los ejecutivos necesitan resúmenes en lenguaje empresarial con periodicidad mensual. Las métricas son diferentes y los paneles también deberían serlo.
Métricas para los responsables de ingeniería y producto:
-
Coste por recurso (máquina virtual, contenedor, base de datos) por día
-
Coste por despliegue (variación de la infraestructura derivada de las ejecuciones de CI/CD)
-
Tasa de anomalías (número de alertas activadas frente a las resueltas por semana)
-
Porcentaje de gasto sin etiquetas (objetivo: <5%)
-
Tasa de utilización de reservas (objetivo: 80% o más)
Métricas para dirección y FP&A:
-
Gasto total en la nube por producto, mes a mes
-
Desviación entre la previsión y el presupuesto (mes actual y periodo móvil de 90 días)
-
Combinación de gasto comprometido y bajo demanda
-
Economía unitaria: coste por cliente, coste por transacción, coste por llamada a la API
-
Desperdicio como porcentaje del gasto total
El marco FinOps destaca que los datos deben ser oportunos, precisos y accesibles para permitir una toma rápida de decisiones. Un panel que se actualiza semanalmente no es suficientemente oportuno para ingeniería. Un panel que muestra los costes por recurso no resulta útil para un director financiero. Conectar canalizaciones de datos en tiempo real con la exportación de facturación es lo que hace que el panel de ingeniería sea realmente operativo en lugar de retrospectivo.
Mejorar la calidad de los informes financieros sobre el gasto en la nube — estructurándolos para responder a las preguntas que realmente hacen los equipos financieros — es una disciplina en sí misma, y los marcos para mejorar los informes financieros ofrecen una estructura útil para la capa orientada a FP&A de tu programa de gobernanza.
Consejo profesional: Combina las métricas de uso con las métricas de coste para generar una economía unitaria. Coste por cliente = gasto total en la nube / clientes activos. Haz un seguimiento mensual. Cuando aumenta, tienes un punto de partida para conversar. Cuando disminuye, tienes un logro que compartir con la empresa.
Dónde fracasan los programas de gobernanza y cómo FinOps corrige la cultura
La mayoría de los fallos de gobernanza de costes en la nube no son técnicos. Son organizativos. Los patrones se repiten de forma predecible.
Errores habituales:
-
Tratar la gobernanza como una labor policial. Cuando los ingenieros perciben la gobernanza de costes como una auditoría de cumplimiento en lugar de un servicio facilitador, la esquivan. Se ignoran las políticas, se falsifican las etiquetas y el programa pierde credibilidad.
-
Depender únicamente de las etiquetas para la asignación. Las etiquetas son frágiles. Los ingenieros las olvidan, las renombran o las aplican de forma incoherente. Sin la jerarquía de cuentas o suscripciones como límite estructural, los informes de asignación dejan de ser fiables.
-
Limpiezas puntuales en lugar de procesos continuos. Un «sprint de limpieza de la nube» trimestral no es gobernanza. Es una prueba de que la gobernanza no existe. Los controles operativos continuos sustituyen la necesidad de realizar sprints de limpieza.
-
Bloqueos estrictos en producción. La terminación automatizada de recursos de producción basada en umbrales de coste provoca incidentes. El coste del incidente supera el coste del gasto excesivo.
-
Ignorar los circuitos de retroalimentación de la gobernanza. Las políticas que se redactan una vez y nunca se revisan quedan obsoletas. Una política de etiquetado redactada para una aplicación web de tres niveles no contempla cargas de trabajo de Kubernetes ni funciones sin servidor sin una revisión.
El modelo cultural de FinOps aborda estos aspectos directamente. Los principios de FinOps impulsan la responsabilidad hacia los equipos: los ingenieros son responsables de las decisiones de uso y la función central de FinOps se encarga de optimizar las tarifas y facilitar recursos. No es una función exclusiva de finanzas ni exclusiva de ingeniería. Las directrices piloto de GSA/ITVMO recomiendan un pequeño grupo directivo multifuncional que itere la política allí donde más importa, en lugar de imponer un mandato desde arriba. Incorporar la autonomía de los equipos de ingeniería al modelo de gobernanza es lo que permite que la responsabilidad distribuida funcione en la práctica.
Consejo profesional: Lanza la gobernanza como un servicio facilitador, no como una función de control. Lo primero que debería hacer el equipo de FinOps es proporcionar a los equipos de ingeniería una mejor visibilidad de sus propios costes: sin políticas, sin medidas coercitivas, solo datos. Los equipos que pueden ver sus costes casi siempre quieren reducirlos.
El despliegue en 90 días: hitos y niveles de esfuerzo semana a semana
La orientación de GSA/ITVMO valida el enfoque iterativo: los proyectos piloto gubernamentales y empresariales que utilizaron implementaciones progresivas de FinOps — comenzando por la visibilidad, siguiendo con la asignación y después la optimización — superaron a las implementaciones integrales en la adopción y en el ahorro sostenido. El plan de 90 días que aparece a continuación sigue ese patrón.
| Fase | Semanas | Hitos | Responsable | Criterios de aceptación |
|---|---|---|---|---|
| Descubrimiento | 1–2 | Exportación de facturación en la nube configurada; jerarquía de cuentas asignada; entrevistas con las partes interesadas completadas | Ingeniería de plataformas + FinOps | El 100 % del gasto es visible en un único panel |
| Piloto de visibilidad | 3–4 | Política de etiquetado redactada e incluida en IaC; alertas de anomalías activas; primer informe de showback | Ingeniería de plataformas + FinOps | Bajo gasto sin etiquetar; primera alerta reconocida |
| Asignación | 5–8 | Informes de showback para los 3 productos principales; objetos presupuestarios creados; FP&A integrado | FinOps + FP&A | Alertas de desviación presupuestaria operativas y participación de FP&A confirmada |
| Optimización | — | Recomendaciones de dimensionamiento adecuado clasificadas; primeras compras de reservas aprobadas | FinOps + Compras | Utilización de reservas por encima del umbral objetivo, lo que indica una utilización eficaz |
| Integración en las operaciones | — | Cadencia operativa documentada; manuales operativos publicados; cumplimiento del etiquetado >95 % | Todos los responsables | La cadencia de revisión semanal funciona sin necesidad de recordatorios |
Lista de comprobación de los días 1–30:
-
Configurar la exportación de facturación en un almacén de datos central (BigQuery, S3 o Azure Storage)
-
Asignar la jerarquía de cuentas/suscripciones a las estructuras empresariales
-
Redactar la política de etiquetado como una solicitud de incorporación de cambios de IaC
-
Implementar alertas de anomalías con enrutamiento a Slack/webhook
-
Elaborar el primer informe de showback para el producto con mayor gasto
Lista de comprobación de los días 31–60:
-
Ampliar el showback a los tres productos principales
-
Crear objetos presupuestarios con alertas al 80 % y al 100 %
-
Integra los datos del gasto en la nube con las previsiones de FP&A
-
Analiza las recomendaciones de dimensionamiento adecuado del proveedor de la nube
-
Realiza la primera revisión de utilización de reservas
Lista de comprobación de los días 61–90:
-
Ejecuta la primera compra centralizada de una reserva o un plan de ahorro
-
Publica manuales operativos para responder a anomalías
-
Alcanza un cumplimiento de etiquetado superior al 95 %
-
Entrega el primer informe ejecutivo de costes en lenguaje empresarial
-
Programa la revisión trimestral de políticas
Bandas estimadas de esfuerzo y costes:
-
Horas de FTE internos: entre 80 y 160 horas de ingeniería de plataformas, FinOps y FP&A para el piloto de 90 días
-
Herramientas nativas de la nube: 0 $ (incluidas con las cuentas del proveedor de la nube)
-
Suscripción a la plataforma CCM: entre 500 y 5.000 $/mes, según el volumen de gasto y el nivel de la plataforma
-
Consultoría opcional: varía según el alcance; un trabajo específico de descubrimiento y un piloto suelen durar entre 4 y 8 semanas
Consejo profesional: El piloto está listo para escalar cuando se cumplen tres condiciones: el cumplimiento de etiquetado supera el 95 %, al menos un equipo de producto revisa su propio informe de showback sin que se lo pidan y la alerta de anomalías se ha activado y resuelto al menos una vez. Estas tres señales indican que el programa ha logrado tracción organizativa, no solo infraestructura técnica.
Qué hacer en los próximos 30, 90 y 180 días
Los programas de gobernanza se estancan cuando los líderes abandonan una sesión de planificación sin una acción siguiente específica. La lista siguiente está priorizada por impacto y secuenciada para aprovechar cada fase.
Inmediato (próximos 7–30 días):
-
Realiza un análisis de visibilidad de 7 días: configura la exportación de facturación e identifica los cinco principales factores de coste por producto o equipo. Métrica de éxito: el 100 % del gasto está asignado a una estructura empresarial.
-
Redacta la política de etiquetado como una solicitud de cambios de IaC. Responsable: líder de ingeniería de plataformas.
-
Implementa la monitorización de alertas de anomalías. Responsable: ingeniería de plataformas. Métrica de éxito: primera alerta reconocida en un plazo de 2 horas.
Corto plazo (30–90 días):
-
Entrega informes de showback para los tres productos principales. Responsable: FinOps/Finanzas. Métrica de éxito: los responsables de producto revisan sus propios informes mensualmente.
-
Reducir el gasto sin etiquetar por debajo del 5 %. Responsables: ingeniería de plataformas y FinOps. Métrica de éxito: panel diario de cumplimiento de etiquetado que muestre <5 %.
-
Crea objetos presupuestarios e intégralos con FP&A. Responsable: FP&A + FinOps. Métrica de éxito: las alertas de variación se activan antes de sorpresas de fin de mes.
Medio plazo (90–180 días):
-
Ejecuta la primera compra centralizada de reservas. Responsable: adquisiciones + FinOps. Métrica de éxito: utilización de reservas superior al 80 %.
-
Publica la economía unitaria (coste por cliente o coste por transacción) de los dos productos principales. Responsable: FinOps + ingeniería. Métrica de éxito: la métrica se registra mensualmente y se revisa en la planificación del producto.
-
Realiza la primera revisión trimestral de políticas. Responsable: grupo directivo de FinOps. Métrica de éxito: al menos una política se actualiza basándose en los comentarios operativos.
Cuando el programa alcanza los 90 días y la cadencia operativa funciona sin necesidad de recordatorios, es el momento adecuado para evaluar si la ayuda externa puede acelerar las fases de optimización y economía unitaria. Un trabajo específico en esa etapa genera ahorros más rápidamente que uno al principio, porque los datos y el contexto organizativo ya existen.
Conclusiones clave
Una gobernanza eficaz de los costes en la nube requiere visibilidad, responsabilidad distribuida y controles operativos continuos, no una limpieza puntual ni una función de vigilancia exclusiva de Finanzas.
| Punto | Detalles |
|---|---|
| Gobernanza frente a optimización | La gobernanza es la estructura (roles, políticas y controles) que hace que la optimización de costes sea repetible y tenga responsables. |
| Jerarquía por encima de las etiquetas | Usa las jerarquías de cuentas/suscripciones como límites estrictos de costes; reserva las etiquetas para los metadatos y los informes. |
| Despliegue iterativo | Empiece por la visibilidad y la asignación, y después optimice las adquisiciones — las implementaciones de golpe suelen rendir por debajo de lo esperado. |
| Primero, controles flexibles | Alerta y exige la confirmación humana para los sistemas de producción; automatiza las interrupciones estrictas solo para los recursos inactivos que no sean de producción. |
| Ridiculous Engineering | Ridiculous Engineering ofrece proyectos piloto de 90 días que proporcionan un panel de costes, una política de etiquetado y un manual de optimización priorizado como entregables concretos. |
Ridiculous Engineering puede ayudarte a desarrollar esto
La gobernanza de costes en la nube es un problema de ingeniería y organizativo, no solo financiero. Ridiculous Engineering trabaja con responsables de tecnología y finanzas para diseñar e implementar programas de gobernanza que produzcan resultados medibles: visibilidad de costes a nivel de producto, cumplimiento del etiquetado superior al 95 % y una economía unitaria que conecte el gasto en la nube con el valor empresarial.
Las dos modalidades de proyecto más habituales son un piloto de 90 días (desde el descubrimiento hasta la integración operativa, con un panel de costes y un manual priorizado como entregables) y un descubrimiento y evaluación más breves (de 2–4 semanas, que producen un análisis del estado actual, un informe de carencias de gobernanza y una hoja de ruta priorizada). Ambos proyectos incluyen un alcance transparente, entregables definidos y una transferencia clara para que tu equipo asuma el programa una vez finalizado el proyecto.
Si eres responsable de tecnología o finanzas y necesitas un marco práctico de gobernanza en lugar de un discurso comercial de un proveedor, inicia una conversación con Ridiculous Engineering. La primera llamada es una sesión de trabajo, no una llamada comercial.
Fuentes útiles
-
Descripción general del marco de la FinOps Foundation — La referencia principal sobre los principios de FinOps, sus ámbitos y el modelo cultural de responsabilidad distribuida. Empieza aquí para conocer los fundamentos conceptuales.
-
Principios de la FinOps Foundation — Los principios específicos que rigen la habilitación central y la responsabilidad distribuida; esenciales para diseñar el modelo de roles.
-
Buenas prácticas de FinOps de GSA / ITVMO — Orientación validada por el Gobierno sobre pilotos iterativos de FinOps, gobernanza del etiquetado y jerarquía organizativa. Aplicable directamente a programas federales y empresariales de EE. UU.
-
Marco de adopción de la nube de Microsoft: gestión de costes en la nube — Orientación específica de Azure sobre la asignación del alcance de la gobernanza a las estructuras empresariales y la realización de revisiones periódicas.
-
BizTech Magazine: Cómo controlar el gasto en la nube — Datos de una encuesta del sector que identifican la imprevisibilidad de los costes y la complejidad de los precios como los principales obstáculos para materializar el coste total de propiedad de la nube.
-
Ridiculous Engineering: Guía de optimización de costes de Kubernetes — Tácticas de costes específicas para plataformas con cargas de trabajo contenerizadas; lectura recomendada para equipos que utilizan Kubernetes.
-
Ridiculous Engineering: Guía de estrategia de migración a la nube — Orientación para planificar las fases de migración y prever los costes; relevante para la fase de descubrimiento del despliegue de 90 días.
Preguntas frecuentes
¿Qué es la gobernanza de costes en la nube?
La gobernanza de costes en la nube es el conjunto de roles, políticas y controles que alinean continuamente el gasto en la nube con el valor empresarial. Se diferencia de la optimización de costes (acciones puntuales de ahorro) y de la gestión de costes (informes y asignación) porque proporciona la estructura organizativa que hace que ambas sean repetibles.
¿Qué es la gestión de costes en la nube?
La gestión de costes en la nube abarca los informes, la asignación y la supervisión del gasto en la nube — paneles, informes de showback, alertas presupuestarias y conciliación de facturas. La gobernanza es la capa superior que define quién es responsable y qué políticas limitan las decisiones de gasto.
¿Qué es la gobernanza de la computación en la nube?
La gobernanza de la computación en la nube es el marco más amplio de políticas, controles y estructuras de responsabilidad que abarca la seguridad, el cumplimiento, los costes y los estándares operativos de los entornos en la nube. La gobernanza de costes en la nube es un ámbito específico dentro de ese marco más amplio, centrado en la responsabilidad financiera y la alineación del gasto.
¿Cuál es la mejor estrategia de nube para optimizar costes?
El enfoque más eficaz combina un despliegue iterativo de FinOps — empezando por la visibilidad y la asignación, y pasando después a la optimización de las adquisiciones — con una responsabilidad distribuida, en la que los ingenieros son responsables de las decisiones de uso y una función central de FinOps se encarga de optimizar las tarifas y los compromisos. Comprometerse con instancias reservadas o planes de ahorro después de establecer una línea base de uso suele proporcionar el mayor ahorro sostenido.